
CDM:突破离散束缚,开启扩散模型全连续蒸馏新时代
Continuous-Time Distribution Matching for Few-Step Diffusion Distillation
本文提出了连续时间分布匹配(Continuous-Time Distribution Matching, CDM),一种用于加速扩散模型生成的蒸馏框架。该方法首次将 Distribution Matching Distillation (DMD) 从离散步长转向全连续优化空间,实现了在 4 步迭代(4 NFE)下达到甚至超越 100 步教师模型的 SOTA 生成质量。
TL;DR
传统的扩散模型蒸馏往往被“离散时间步”锁死,导致模型在少步推理时容易产生纹理模糊和伪影。南开大学与阿里巴巴等团队提出的 Continuous-Time Distribution Matching (CDM) 给出了一个优雅的解:将蒸馏从离散锚石移入连续大河。通过动态时间调度和独创的速度外推技术,CDM 让 4 步生成的图像质量在很多细分指标上首次超越了传统的 100 步采样。
1. 痛点:为什么“少步生成”总是长得不好看?
在扩散模型加速领域,Distribution Matching Distillation (DMD) 一直是 SOTA。但它有个根深蒂固的问题:时间步的“离散锚定”。
- 训练与推理的僵化耦合:以前的方法认为推理用 4 步,训练也必须死板地在那 4 个时间点(Anchors)上对齐。这导致模型只学会了这几个点的映射,轨迹中间的速率场(Velocity Field)分布极度杂乱。
- 截断误差的累积:在只有 4 步的情况下,每一跳的步长都非常大,欧拉积分产生的数值误差会将潜变量推离理想的“数据流形”,反映在视觉上就是画面发虚、细节丢失。
2. 核心洞察:从“锚点对齐”到“轨迹感知”
CDM 作者实验发现两个惊人的事实:
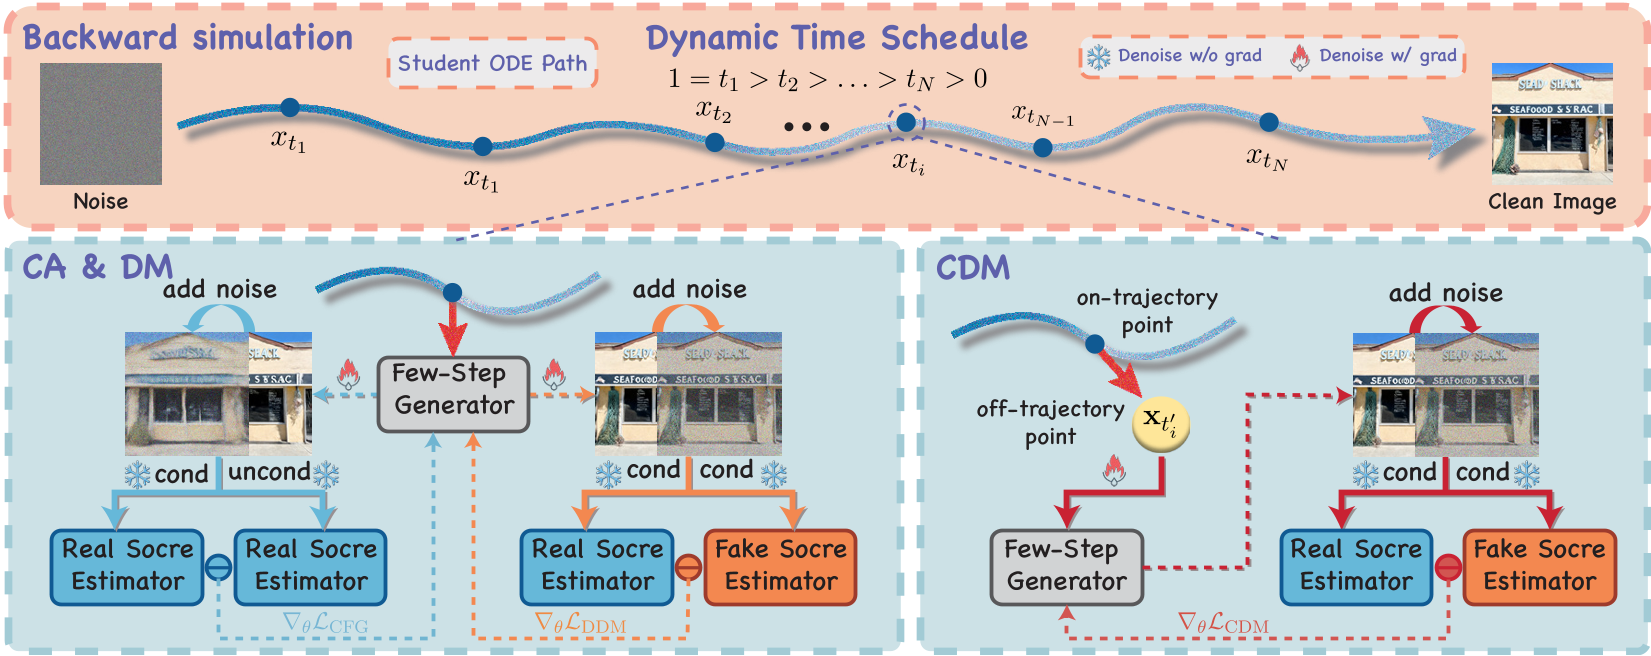
- 脱钩更有利:训练时随机选择连续的时间点,避开固定的推理步长,反而能让模型学到更健壮的生成能力(如图 2 所示)。
- 不仅仅是正则项:分布匹配损失(DM Loss)并不是可有可有无的“稳定剂”,它实质上驱动学生模型去对齐教师的 CFG-free(无引导)分布。
3. CDM 的杀手锏:速度驱动的外推对齐
如何修正大步长带来的误差?CDM 提出了一种类似“自动驾驶纠偏”的机制:
- 主动探测轨迹外空间:基于学生模型预测的速度 ,主动向未来时间点进行一阶欧拉外推(Euler Extrapolation),得到一个“偏移”后的潜变量。
- 局部自适应监督(LCDM Loss):在这个偏移点上,利用教师模型的 Score 信息强制进行对齐。这就好比模型在练习跑步时,教练不仅告诉它在跑道中心怎么跑,还专门把它推到跑道边缘,教它如何“修正”回中心。
从数学上看,这种做法直接抑制了速率场的材料导数(Material Derivative),减少了步间的运动不一致性。
4. 实验战绩:全方位的视觉进化
在 SD3-Medium 和 Longcat-Image 两个大模型上的实验结果堪称惊艳:
- 硬核指标提升:在 4 步 NFE 下,CDM 在 HPSv3(人类偏好分数)上取得了巨大跨越。
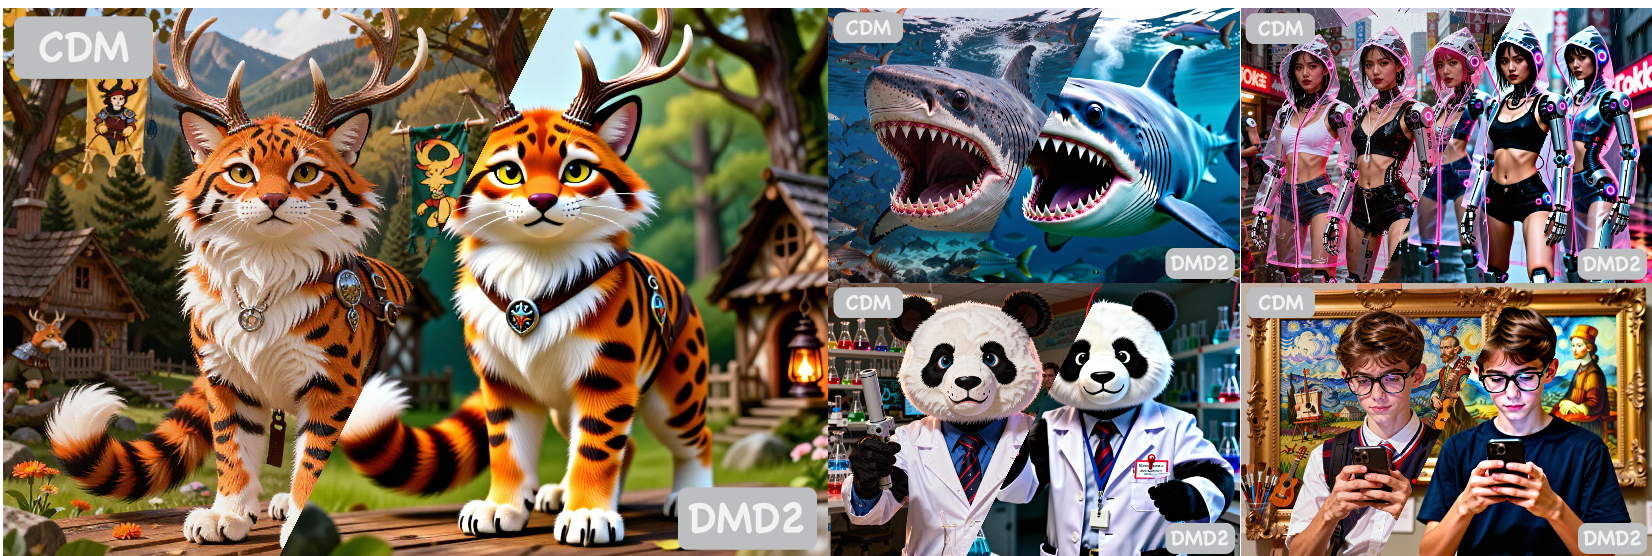
- 告别过度平滑:如图 1 和图 5 所示,相比前代 DMD2,CDM 生成的纹理更加锐利,特别是在复杂背景、材质反光和细微质感上表现出色,且不依赖任何额外的 GAN 或奖励模型。
5. 深度洞察与总结
CDM 的成功揭示了扩散模型蒸馏的一个本质:鲁棒的连续监督胜过死板的离散对齐。
亮点总结:
- 效率与质量并存:推理延迟保持在 246ms(4 NFE),但画面质量可比肩甚至超越 100 步的教师。
- 普适性强:该架构不挑模型,无论是 Rectified Flow 还是传统的 Diffusion 架构都适用。
局限性: 尽管推理极快,但由于训练时需要进行额外的轨迹外推和动态采样,训练成本约为 D-DMD 的 1.8 倍。
对于追求极致实时性和画质的应用来说,CDM 毫无疑问是目前扩散模型“少步蒸馏”中最值得借鉴的范式。