
协调即架构:破解 LLM 多智能体系统高失败率的“暗物质”
Coordination as an Architectural Layer for LLM-Based Multi-Agent Systems
本文提出了将“协调(Coordination)”视为基于 LLM 多智能体系统独立架构层的理论框架,并开发了一套信息受控(Information-Controlled)的实验方法论。该研究通过在预测市场(Polymarket)的 100 个真实案例上测试五种典型协调配置,揭示了不同架构对模型校准度和判别力的独特影响。
TL;DR
即使拥有最强的模型(如 Claude 3.5 Opus),多智能体系统在生产环境中的失败率依然居高不下。本文指出,问题的根源不在于模型不够聪明,而在于“协调(Coordination)”结构的随意性。作者提出将协调视为一个独立的架构层,并通过对预测市场的严密实验证明:架构本身就带有特定的“失效签名”——某些结构天生就会导致模型盲目自信或丧失判断力。
背景定位:从工程便捷到架构理性
在 AI 智能体(Agent)领域,我们正处于一个奇怪的阶段:开发者们忙着使用 YAML 或可视化工具(如 AWS Strands, Microsoft Foundry)来编排工作流,但这仅仅是为了“工程方便”。
学术界此前也缺乏严密的测试手段。如果你比较“单智能体”和“五智能体辩论”,后者表现更好,那是由于辩论产生的智力火花,还是仅仅因为它消耗了 5 倍的 Token、读了 5 倍的参考资料?这篇论文通过**“信息固定(Information-Controlled)”**的实验设计,剥离了所有变量,专门审视“协调结构”本身对决策质量的影响。
核心直觉:协调层的七要素
作者认为,一个多智能体系统由三层组成:信息层(数据工具)、协调层(谁和谁通信)、智能体层(模型本身)。通过固定其他两层,我们可以像研究物理结构一样研究“协调”。
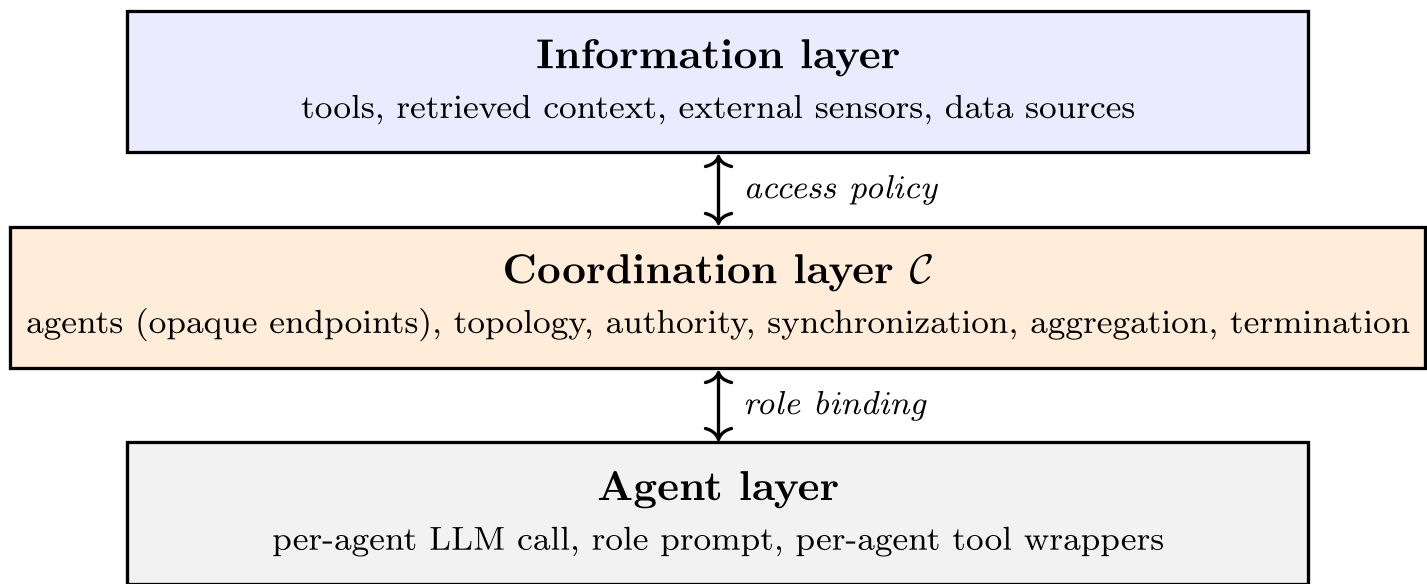
一个协调规范应包含:
- 智能体端点(接口定义)
- 通信拓扑(节点间的消息流图)
- 权威分布(谁最终拍板?)
- 同步机制(回合制还是异步?)
- 聚合规则(如何投票或加权?)
- 终止条件
- 故障处理
实验详解:Murphy 分解视角下的五大架构
作者在真实预测市场(Polymarket)上测试了五种配置:独立集成、同行辩论、协调员-专家模式、序列管道、共识对齐。
研究采用了经典的 Murphy 分解。这是一种比单纯看准确率(Brier Score)更深刻的方法,它将表现拆解为:
- 可靠性 (REL):模型说“有 70% 概率发生”时,现实中是否真的有 70% 的事件发生了?(即校准度)
- 判别力 (RES):模型能否区分“必然发生”和“偶然发生”的事件?
关键发现与“失效签名”
实验揭示了令人警醒的行为模式:
- 共识对齐(Consensus Alignment)的陷阱:当你强迫智能体必须达成共识时,系统的判别力(RES)会大幅下降。智能体倾向于向中庸靠拢,最终丧失了捕捉极端信号的能力。
- 序列管道(Sequential Pipeline)的暴力美学:尽管成本最高,但它在校准度上表现最好。它通过明确的分工(研究-分析-预测)层层递进,有效利用了推理链路。
- 辩论抑制少数派:在同行辩论中,作者观察到“对齐压力”会抑制正确的少数派意见。

深度洞察:成本-质量的 Pareto 前沿
作为技术主管,最关心的通常是性价比。论文绘制了一张残酷的 Cost-Quality 曲线图:
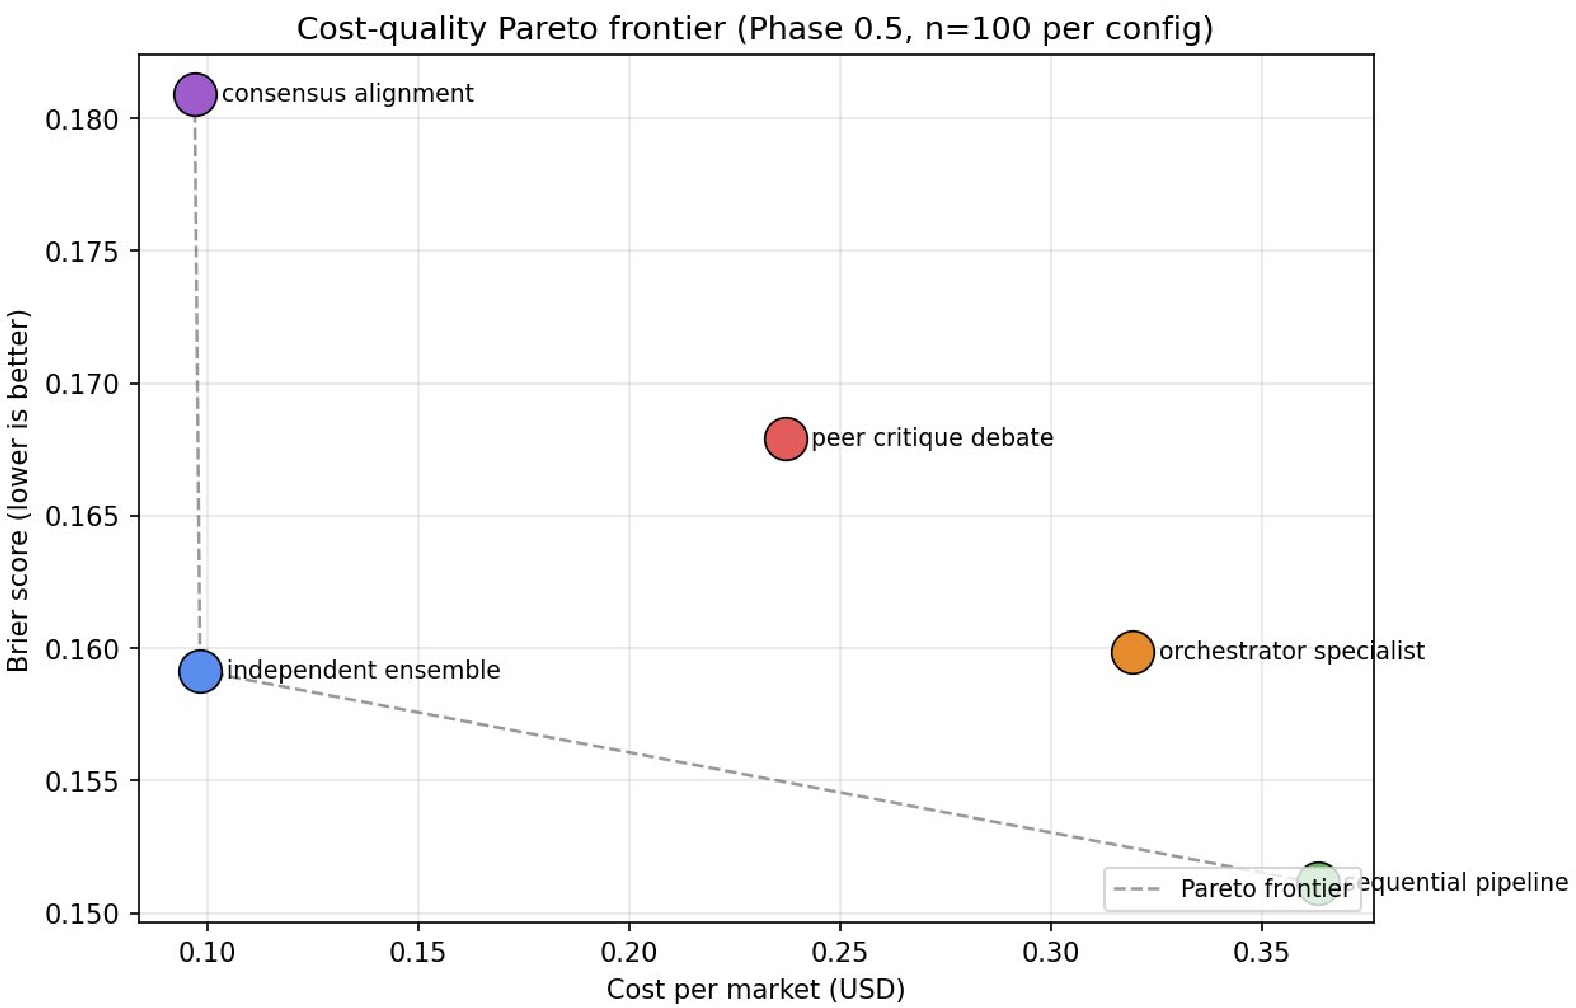
由上图可见:
- **独立集成(Independent Ensemble)**是性价比之王,每题仅需 0.1 美元。
- 序列管道占据了质量高地。
- 尴尬的中间派:备受推崇的“协调员-专家模式”和“同行辩论”在很多场景下被“独立集成”完全碾压(既更贵,又更不准)。
总结与局限
这项工作证明了:多智能体系统的设计不应仅仅是写几行 Prompt。
核心局限分析:
- 负 Alpha 现象:在关掉搜索功能的情况下,所有架构的表现都未能跑赢 Polymarket 的市场共识。这说明目前的 LLM 在处理其训练截止日期之后的事件时,协调逻辑无法弥补信息的缺失。
- 样本量限制:100 个案例在统计学上虽有启发意义,但若要彻底确立某些架构优于另一些架构,可能需要超过 500 个样本才能通过严格的 Bonferroni 校正。
启示
对于正在构建智能体集群的工程师来说,这篇论文是一个及时的警告:如果你正在设计一个复杂的“共识对齐”或“专家协调”系统,请务必测量它的判别力损耗。 有时候,让几个智能体独立思考并取平均值,不仅更便宜,而且更敏锐。