
[CVPR 2025(?)] CubiD:打破维度诅咒,高维语义 Token 也能直接“画”出 SOTA 视觉
Cubic Discrete Diffusion: Discrete Visual Generation on High-Dimensional Representation Tokens
本文提出了 Cubic Discrete Diffusion (CubiD),这是首个能够直接对高维表征(如 DINOv2 的 768 维特征)进行离散生成的扩散模型。通过引入细粒度的 3D 张量掩码机制,CubiD 在 ImageNet-256 任务上实现了 1.88 FID 的 SOTA 离散生成表现,并保持了原生表征的理解能力。
TL;DR
长期以来,AI 领域存在一个尴尬的“表征分裂”:做视觉理解(如 DINOv2)需要高维语义特征,而做视觉生成(如 VQ-GAN, LlamaGen)则被迫将其压缩至极低维度。Cubic Discrete Diffusion (CubiD) 首次终结了这种妥协,它直接在 768 维的原始表征上进行离散扩散生成。通过创新的“立方体掩码”技术,它在 ImageNet 上刷出了 1.88 FID 的惊人成绩,同时保留了原生表征的理解力。
痛点深挖:为什么高维离散生成这么难?
在视觉任务中,我们通常面临鱼与熊掌不可兼得的困境:
- 维度灾难:如果你尝试对 768 维特征做传统的 Vector Quantization (VQ),聚类中心会极其稀疏,导致语义严重丢失(表 3 显示 VQ 在理解任务上大幅降级)。
- 序列爆炸:若采用自回归(Autoregressive)方案,一个 16x16 的特征图在 768 维度下会膨胀成 196,608 个 Token。这种长度会让 Transformer 的计算量呈指数级增长。
- 模式缺失:现有的掩码生成模型(如 MaskGIT)通常以“位置”为单位进行遮盖。但在高维特征中,同一位置的不同维度之间存在极强的耦合,必须进行更精细的建模。
核心方法:Cubic Discrete Diffusion (CubiD)
CubiD 的直觉在于:将 的特征张量视为一个统一的 3D 立方体。
1. 维度无关量化 (Dimension-wise Quantization)
为了规避 VQ 的维度灾难,作者不对整个向量进行查找,而是独立处理每一个维度。这保证了离散化后的 Token 能像连续特征一样支持高性能的视觉理解(如 LLaVA 任务)。
2. 精细化立方体掩码 (Fine-grained Masking)
这是 CubiD 的灵魂。不同于以往遮住整个像素的方法,CubiD 随机遮住 3D 张量中的任意单个元素。这意味着在推理时,模型可以根据“部分已知的维度”去推测“同一位置的其他维度”,同时参考“周围像素的维度”。
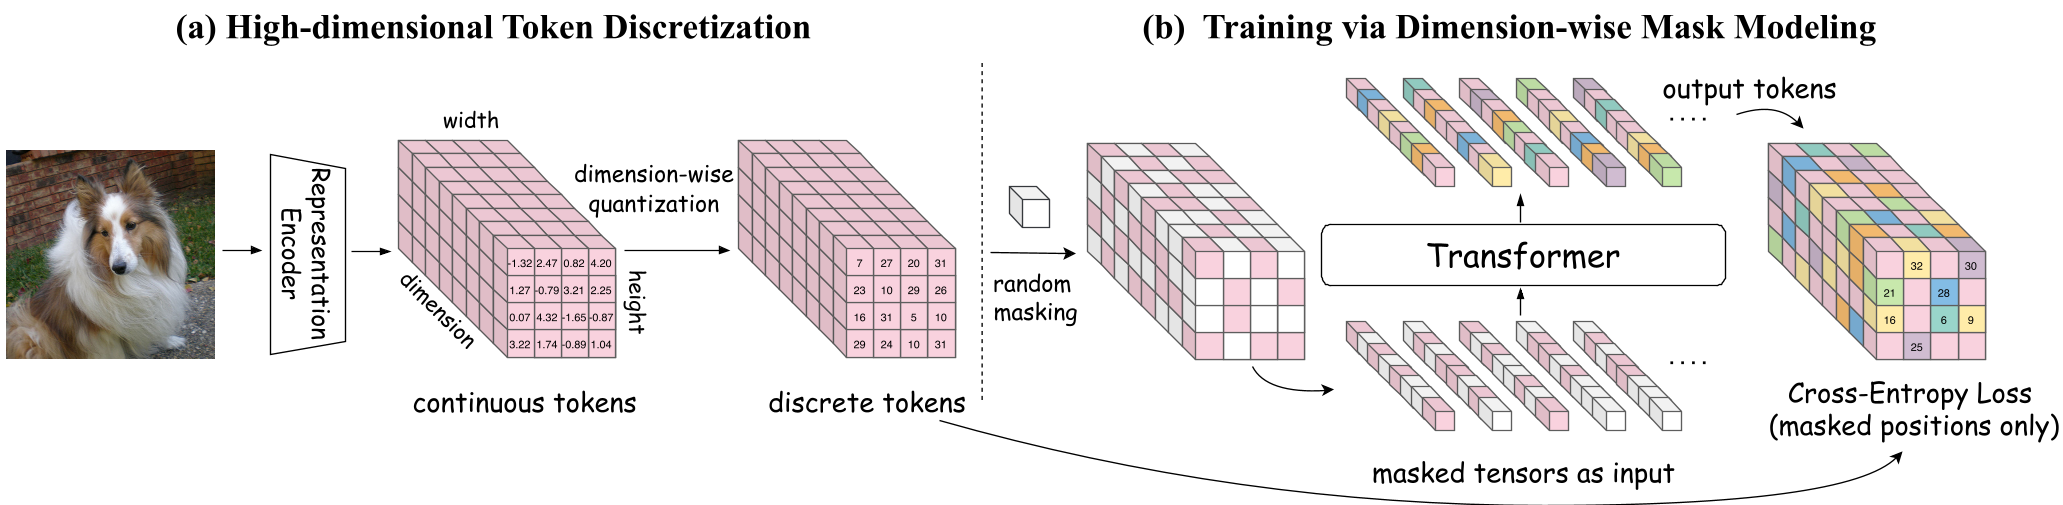 图 1: CubiD 训练流程。通过维度的细粒度掩码学习空间与维度的双重依赖。
3. 解耦计算复杂性
尽管 Token 总数过万,但 CubiD 巧妙地将每个空间位置(包含 个维度)映射回 Transformer 的一个输入序列位置。通过多层 MLP 预测头同步输出 个概率分布,使得采样步数与维度 无关,仅需约 250-512 步即可收敛。
实验战绩:离散生成的新巅峰
在 ImageNet 256x256 的强项对比中,CubiD 展现了极强的 Scaling 能力:
- SOTA 性能:3.7B 规模的 CubiD-XXL 取得了 1.88 FID,超越了专门优化的 VFMTok 和 LlamaGen。
- 无需引导 (Classifier-Free Guidance):即使不开启 CFG,CubiD 仍能保持 2.02 FID。这说明高维表征本身蕴含的结构化信息比低维空间更稳定,对“引导技巧”的依赖更低。
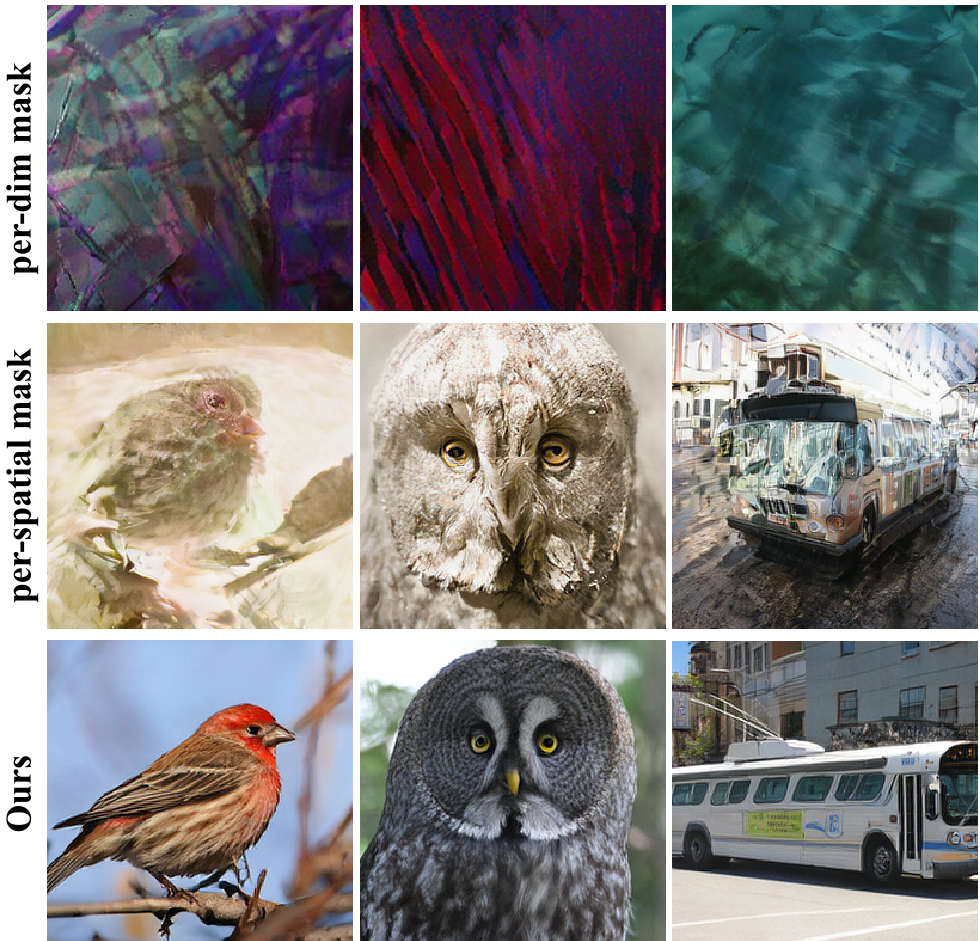 图 2: 不同掩码策略的定性对比。可以看到 CubiD 的 Per-element 策略(底行)在细节和一致性上远超其他方案。
深度洞察:迈向统一多模态的终局
CubiD 的成功传递了一个重要信号:Token 不需要为了生成而牺牲语义。
作者在消融实验中证实,如果使用“按维度掩码(Per-dim)”或“按位置掩码(Per-spatial)”,生成质量会大幅崩溃。这暗示高维视觉表征内部存在一种类似“全息”的结构:只有在特征立方体中进行全方位的观察和预测,模型才能理解物体纹理与几何结构的深层联系。
局限性与未来
尽管 CubiD 非常强大,但它目前依赖于冻结的预训练编码器(如 DINOv2),这使得生成的细节上限受限于编码器的重建能力(目前约为 18dB PSNR)。未来的突破口可能在于如何端到端地学习这种支持 Cubic Diffusion 的高维离散表征,从而进一步缩小离散生成与连续扩散模型(如 Stable Diffusion)之间的质感差距。
总结:CubiD 为离散视觉生成提供了一套高效、可扩展且符合直觉的范式。它告诉我们,处理海量数据时,只要掩码策略足够聪明,维度不再是负担,而是强大的语义资产。