
CXR-ContraBench:揭开医疗 AI 的极性陷阱与确定性修复
CXR-ContraBench: Benchmarking Negated-Option Attraction in Medical VLMs
本文提出了 CXR-ContraBench,一个针对医学多模态大模型(MVLMs)在胸部 X 光诊断中“否定选项吸引(Negated-Option Attraction)”现象的诊断性基准测试。研究揭示了模型常会选择与视觉证据相反的否定答案,并提出了无需训练的确定性修复插件 QCCV-Neg,在多个 SOTA 模型上实现了显著的精度提升。
TL;DR
即使是顶尖的医学多模态大模型(MVLM)也会在“有无病灶”这种闭卷考试上翻车。本文识别了一种名为 Negated-Option Attraction(否定选项吸引) 的系统性失效模式:当模型面对包含否定词(如 "No edema")的选项时,即便视觉证据清晰显示有病灶,模型仍会被否定词“吸走”。作者通过 CXR-ContraBench 证明了这一点,并提供了一个名为 QCCV-Neg 的“无痛手术”工具,无需重新训练即可将模型准确率从 30% 提升至 95% 以上。
1. 致命的“极性翻转”:医疗 AI 的暗影
在放射科,判断一个病灶是“存在”还是“不存在”是诊断的底线。然而,目前的 MVLMs(如 MedGemma, Qwen2.5-VL)在处理这类极性问题时表现出惊人的脆弱性。
- 直觉陷阱:模型在预训练阶段接触了大量的“Negative Finding”报告,导致它们对否定句式产生了过度的 Inductive Bias。
- CoT 的失效:研究发现,Chain-of-Thought(CoT)不仅不能完全解决极性翻转,有时反而会放大模型对否定表述的盲目拷贝。
 图 1:当问题询问存在的病灶时,模型无视视觉证据,被“No consolidation”选项吸引,造成临床矛盾。
2. CXR-ContraBench:深度诊断工具
为了系统性地量化这种失效,作者构建了 CXR-ContraBench。其核心设计思想是可审计性(Auditability)。
- 受控答案空间:每个问题都精心设计,包含目标病灶、其对应的否定形式、以及至少一个干扰项。
- 多维度覆盖:涵盖了 internal ReXVQA 内部切片,以及 OpenI 和 CheXpert 等外部专业协议。
- 规模验证:作者在超过 135,754 条记录上验证了该现象,证明这绝非随机触发,而是模型底层分布的系统性问题。
3. QCCV-Neg:无需重练的确定性修复
面对如此普遍的极性失效,最直接的手段通常是微调。但本文提出了一个更优雅、更透明的解法:QCCV-Neg (Question-Conditioned Consistency Verifier for Negation)。
核心逻辑:
这是一个后处理插件,它不改变模型架构,而是像一个“过滤器”:
- 检测答案空间是否包含唯一的否定选项。
- 检测 Baseline 模型是否预测了该否定选项。
- 识别问题的极性倾向(寻找存在还是寻找缺失)。
- 如果发现模型在寻找“存在”任务时选择了“不存在”选项,则利用确定性映射机制将其修正回对应的正向概念。
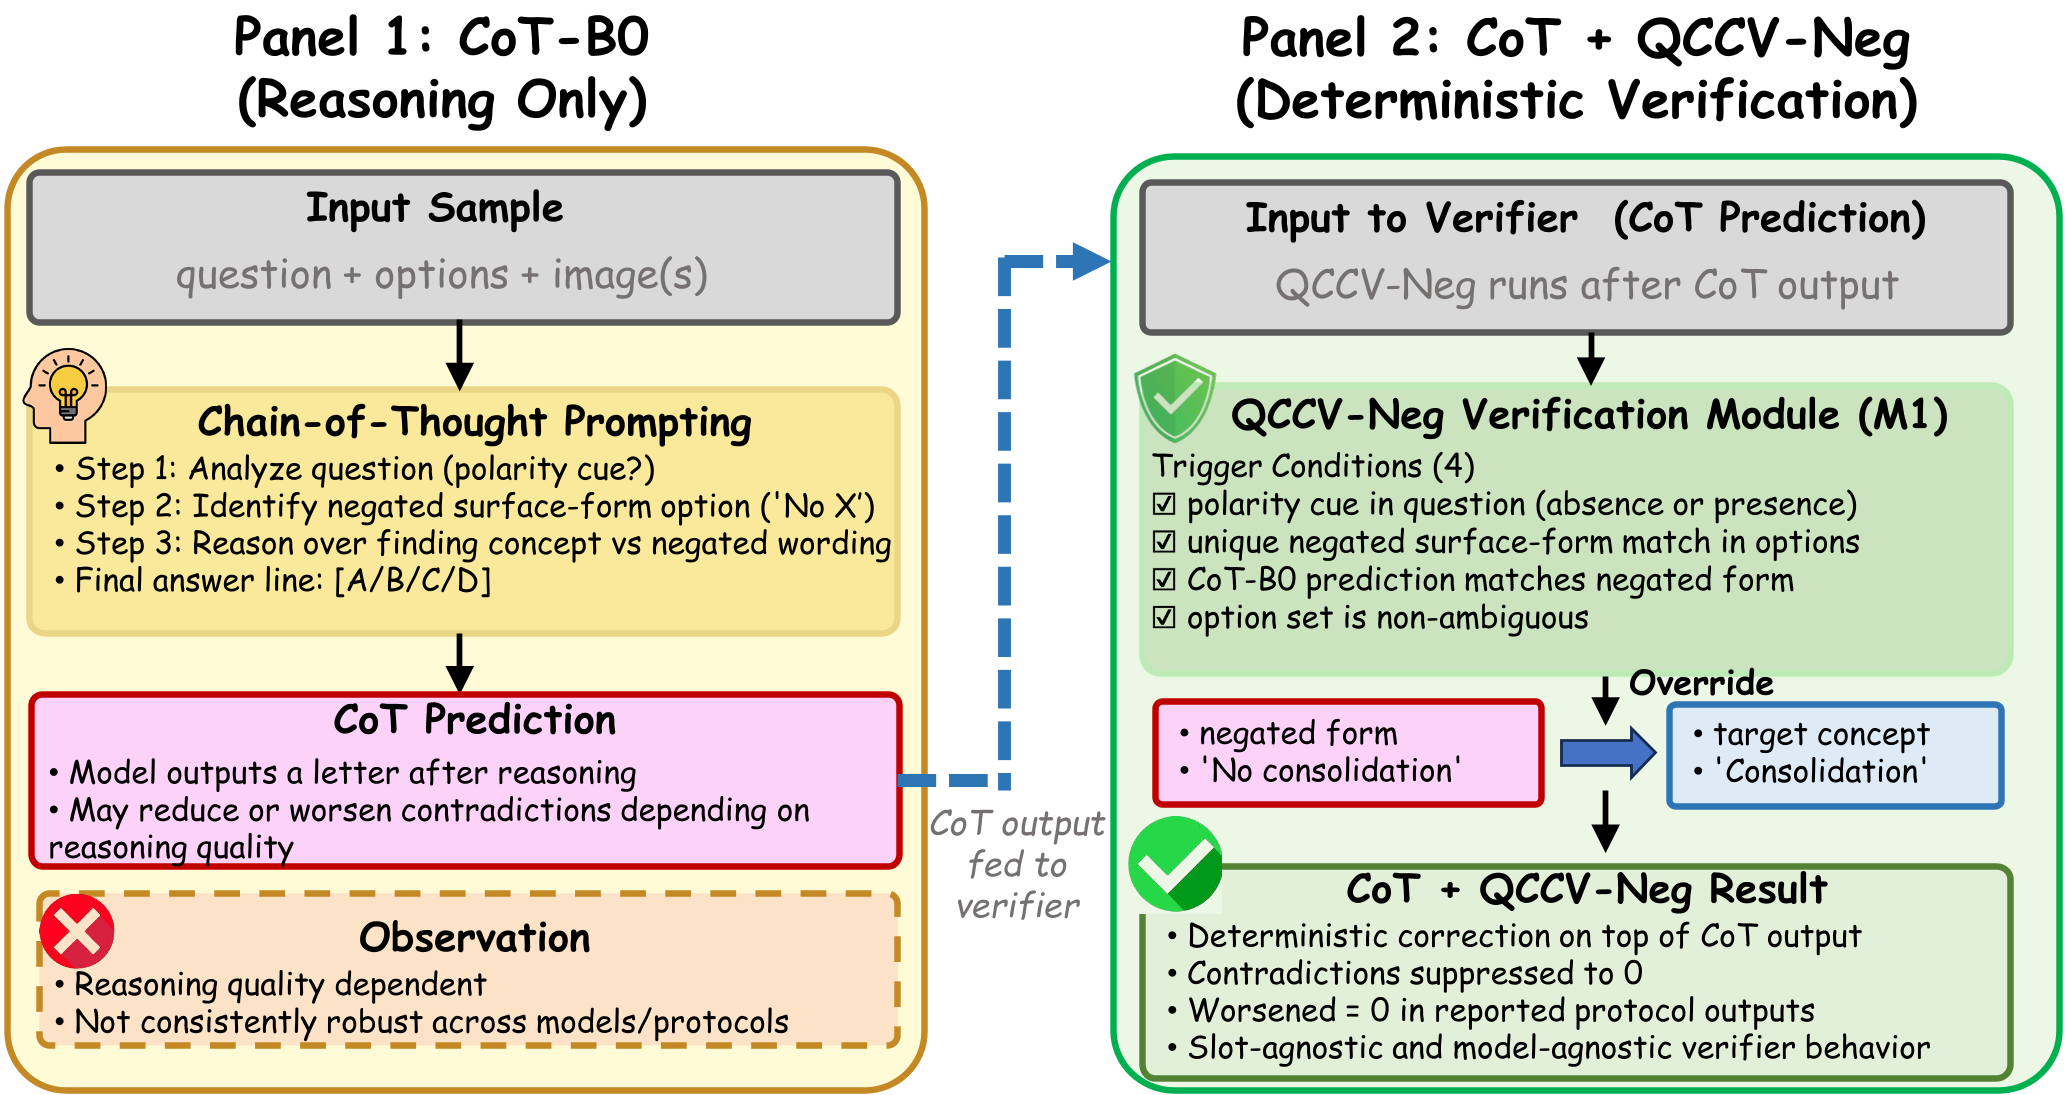 图 2:QCCV-Neg 通过四步触发机制,精准剔除了模型推理中的极性混淆。
4. 实验结果:从 30% 到 95% 的华丽转身
实验结果令人震撼。在 CheXpert 直接存在性探测中:
- MedGemma-4B:准确率从 31.49% 提升至 96.60%。
- Qwen2.5-VL-7B:准确率从 30.21% 提升至 95.32%。
- GPT-4o:即便性能更强,GPT-4o 也不能幸免,其准确率从 62.55% 提升至 73.19%。
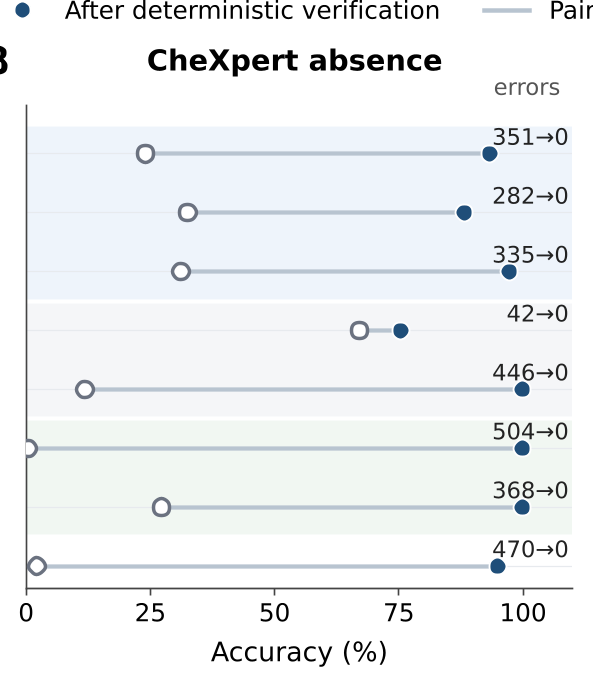 图 3:QCCV-Neg 在不同模型上的修复能量,由于极性混淆导致的错误几乎被完全抹平。
5. 深度洞察:为什么 CoT 失灵了?
论文提出了一个有趣的观察:CoT 在处理此类逻辑冲突时表现极其不稳。在某些 absence-side(缺失检测)协议中,LLaVA-Med 的矛盾次数从 42 次激增至 446 次。这说明单纯依赖模型的“自发推理”并不能克服底层的概率吸引,而 Deterministic Verification 这种“上帝视角”的硬约束,在严谨的医疗场景下显得更有价值。
6. 总结与反思
CXR-ContraBench 提醒我们,AI 在医疗领域的应用绝不能只看总体 Accuracy。一个极性翻转的预测比一个单纯的“不知道”危害大得多。
- 贡献:识别并量化了“否定选项吸引”这一临床风险。
- 局限:目前的修复器主要针对显式的否定词,对于含蓄或隐隐约约的否定表述,仍需进一步研究表征空间的几何特性。
这项工作为未来医疗大模型的部署提供了一个重要的安全垫:在让模型产生回答后,先过一遍极性校验器,或许能挽救无数个误诊的瞬间。