
[CVPR 2026] R-C2:当 MLLM 开始“左右互搏”,跨模态推理迎来新突破
R-C2: Cycle-Consistent Reinforcement Learning Improves Multimodal Reasoning
本文提出了 R-C2,一种利用跨模态循环一致性(Cross-Modal Cycle Consistency)进行强化学习的训练框架。该方法通过在图像和文本模态间执行“答案→查询→答案”的双向验证,为多模态大模型(MLLM)提供密集的无标签奖励信号,在 ScienceQA 和 ChartQA 等多个基准测试中将推理准确率最高提升了 7.6 个点。
TL;DR
面对多模态大模型(MLLM)在处理同一内容(如 HTML vs 网页截图)时经常“精神分裂”输出矛盾结果的痛点,Rutgers 等团队提出了 R-C2 框架。它摒弃了传统的多数投票,通过执行反向推理(答案回推问题)和跨模态验证(换个模态找答案),构建了一个强大的自监督闭环,显著提升了模型的逻辑一致性与推理准确率。
背景定位:解决 MLLM 的“逻辑内耗”
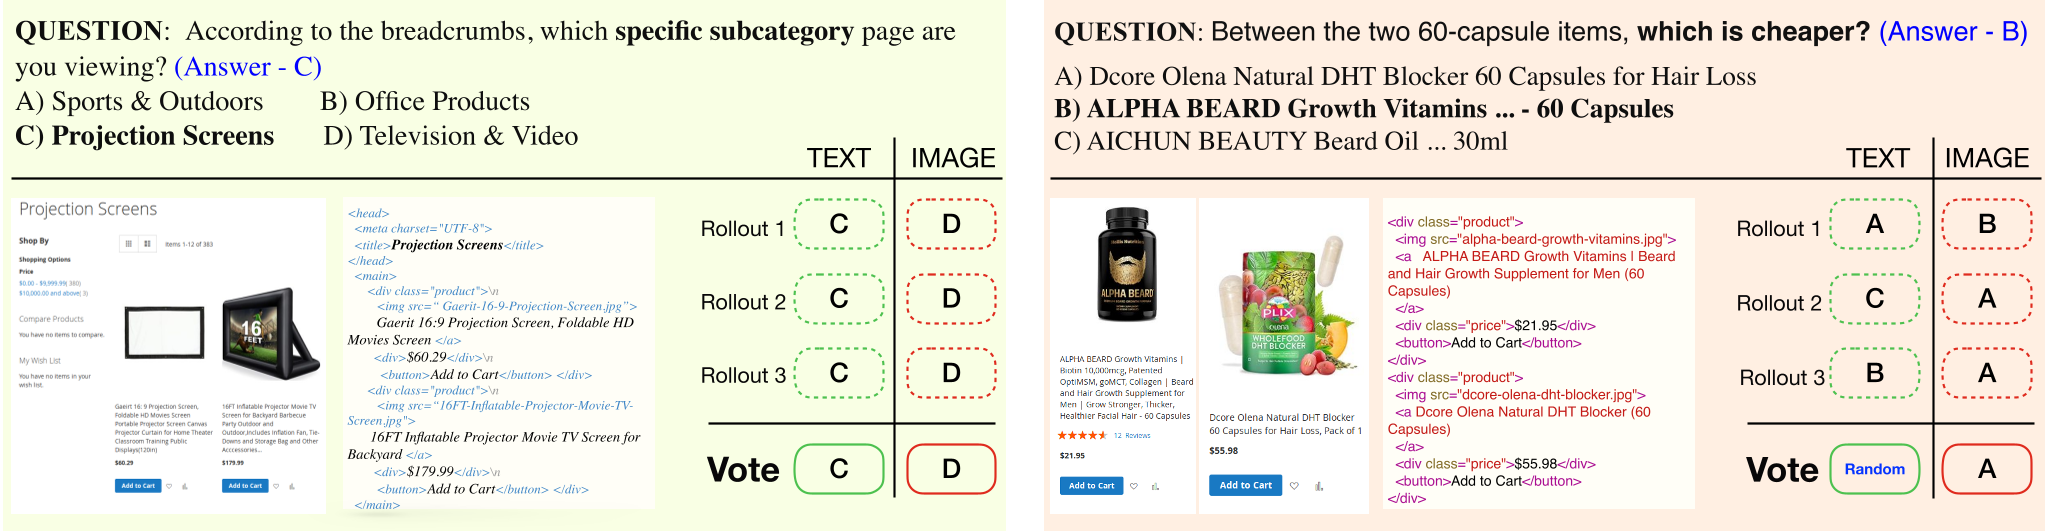
现有的多模态模型虽然参数量巨大,但往往处于“人格分裂”状态:给它看一张图表,它说 A;给它看该图表的原始数据表,它可能反手就说 B。这种**模态鸿沟(Modality Gap)**是当前通用人工智能(AGI)稳健性的一大障碍。
过去的研究倾向于通过大规模指令微调来弥补,但这成本极高。最近流行的 RL 进化(如 DeepSeek-R1 模式)则依赖于数学或代码等可验证的奖励(Verifiable Rewards)。但在通用的视觉问答中,什么是“对”的?很难定义。
痛点深挖:为什么“多数投票”行不通?
在单模态领域,常用的 R-zero 框架通过多次采样取众数(Majority Voting)作为伪标签。但在多模态场景下,这会引发 “错误放大”:
- 系统性偏见:如果模型在视觉上自带某种偏见,采集再多样本也只是在强化错误。
- 不稳定的共识:当图片给出 A,文本给出 B,投票结果就会在两个错误边缘左右横跳。
核心方法:R-C2 的“循环一致性”大法
R-C2 的核心 Insight 是:不一致性不是失败,而是天然的监督信号。
1. 架构解析:四路循环验证
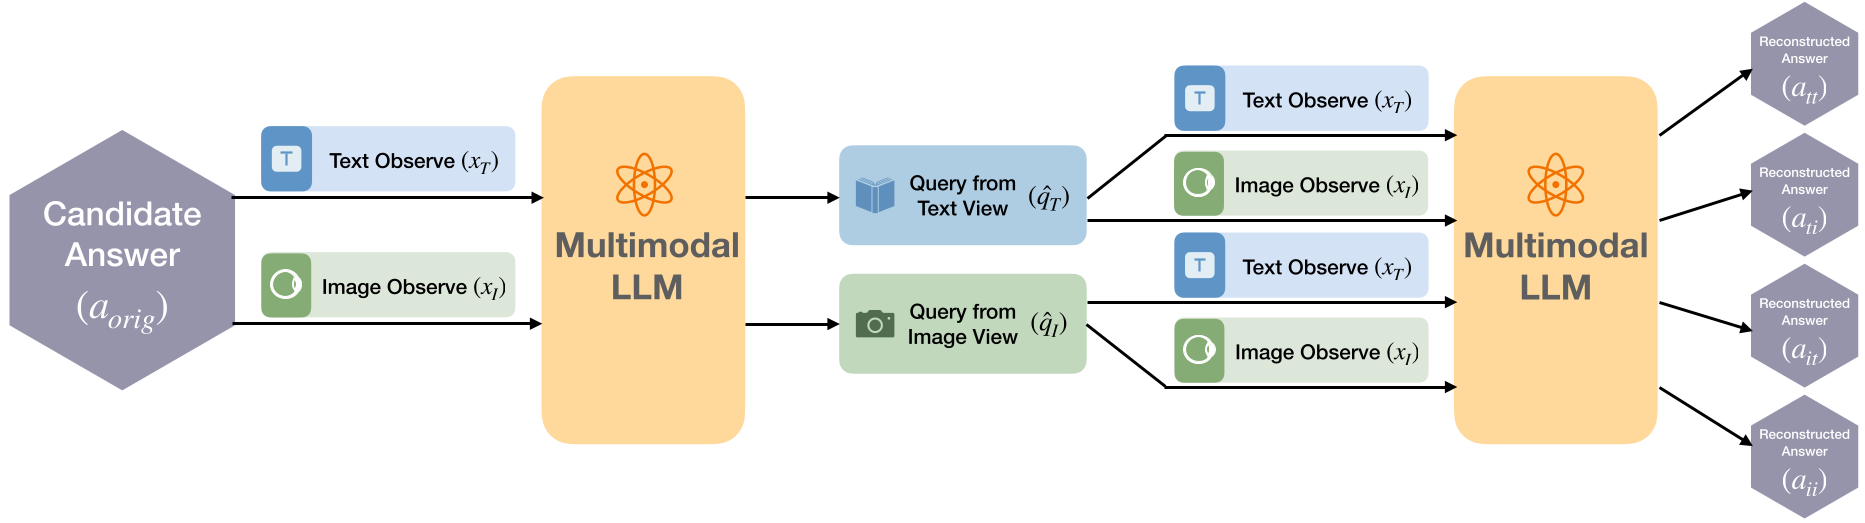
R-C2 将推理过程定义为一个闭环(Cycle):
- Backward Step(反向步):从候选答案 出发,结合当前模态内容,反向推导出一个“好的问题” 。
- Forward Step(正向步):将生成的 喂给另一个模态的内容,看模型能否重新推导出原始答案 。
框架建立了四种路径:T→T, I→I(内部稳定性)和 T→I, I→T(跨模态对齐)。
2. 密集奖励机制
利用 GRPO(Group Relative Policy Optimization)算法,R-C2 给予那些能够完成“逻辑闭环”的路径以正向奖励。这意味着模型必须学会:无论信息以什么形式呈现,其背后的语义逻辑必须合一。
实验与结果:不只有准确率的提升
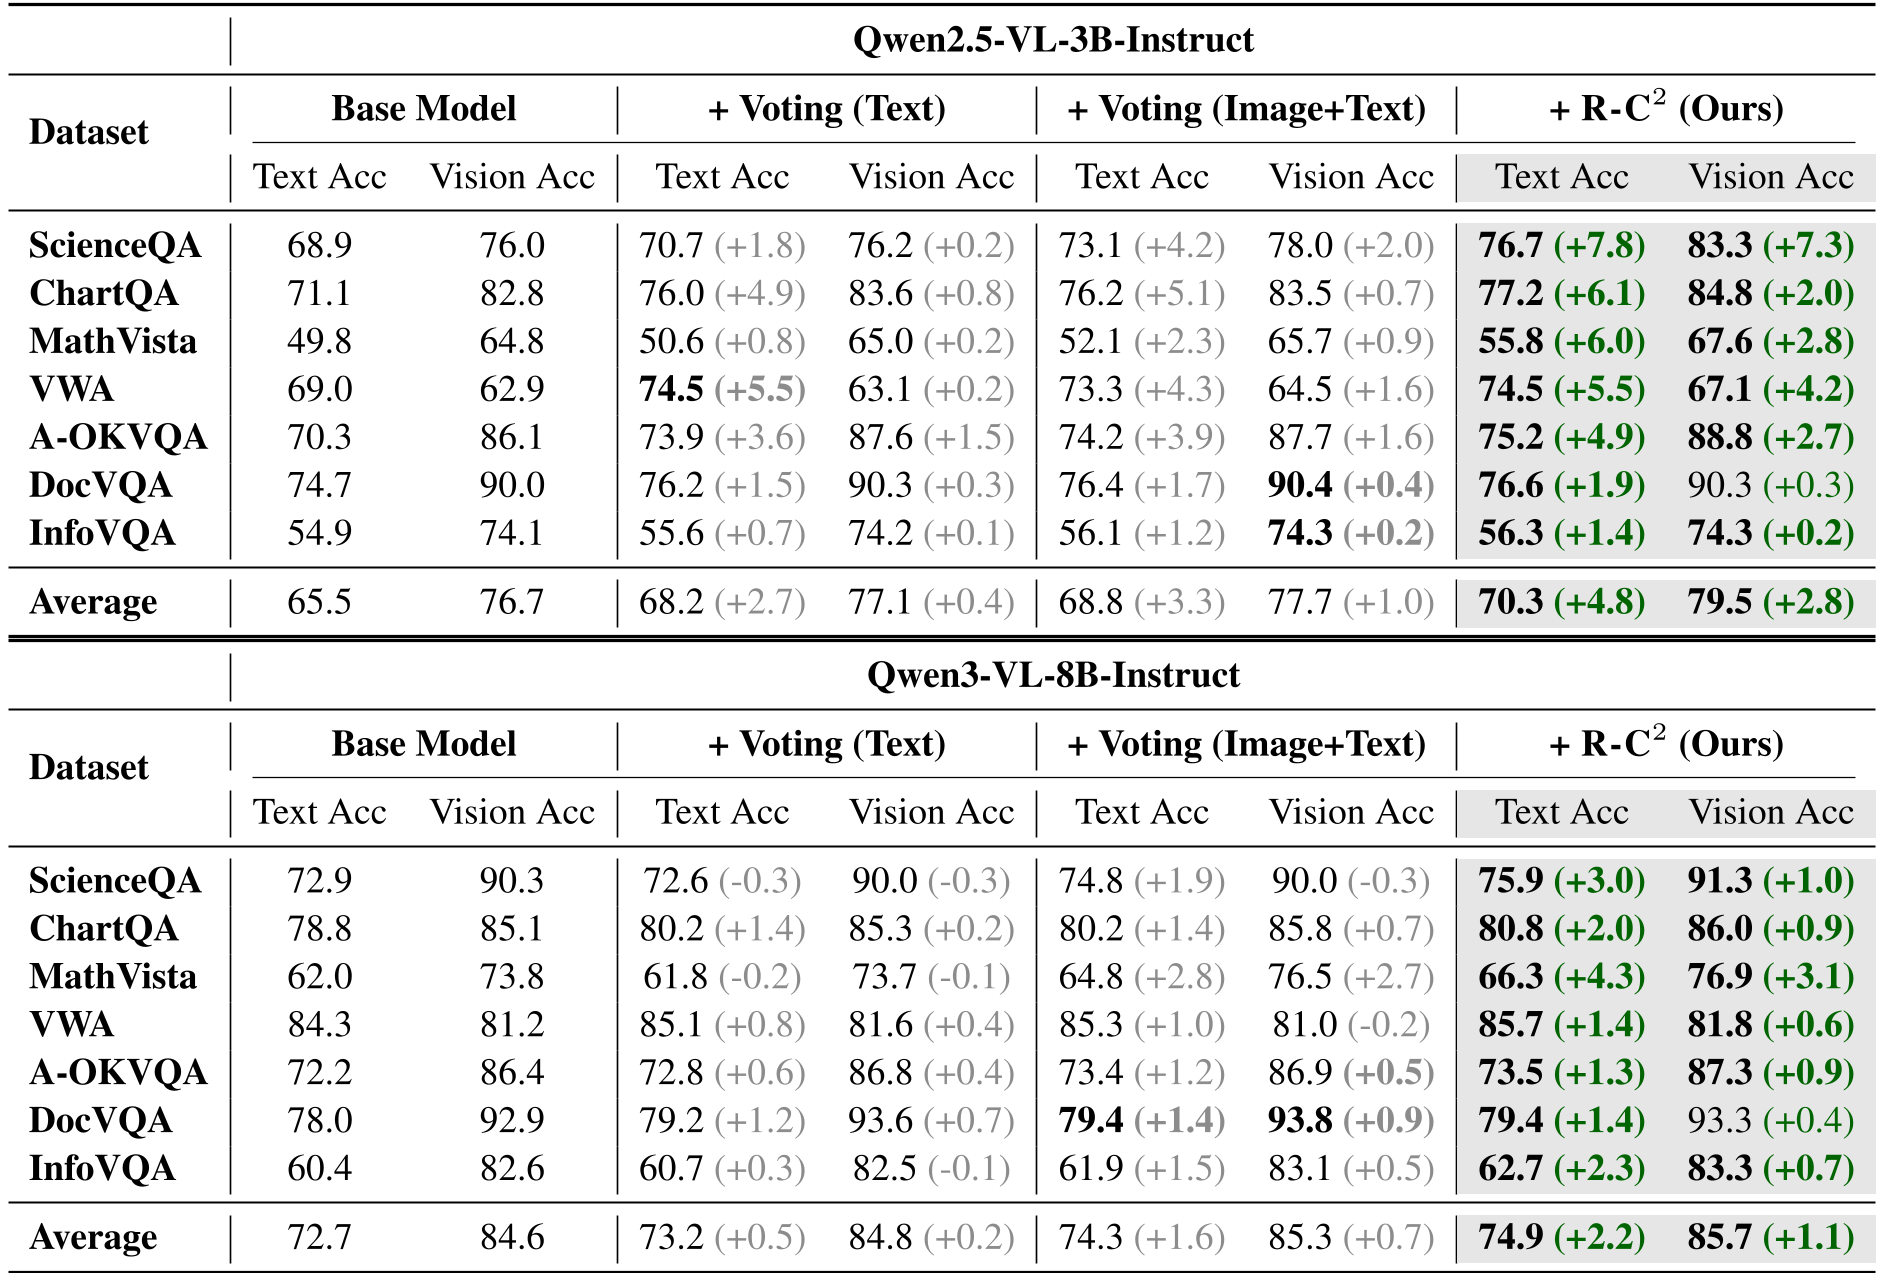
研究团队在 Qwen 系列模型上进行了大规模测试,效果惊人:
- 性能飞跃:在 ScienceQA 上,3B 模型的 Text/Vision 准确率分别提升了 7.8 和 7.3 个点。
- 一致性增强:在 A-OKVQA 测试中,模态预测的一致性提升了 12.5%。
深度洞察:冲突竟是药引?
作者做了一个非常有意思的消融实验(Figure 7):增加训练集中“跨模态不一致”的比例,模型反而学得更好。这种**冲突数据(Disagreement Data)**起到了“困难样本(Hard Examples)”的作用,逼迫模型在最纠结的地方进行对齐,从而实现了比单纯训练“一致数据”更高的稳健性。
总结与局限性
R-C2 证明了 MLLM 可以通过“逻辑自洽”实现自发性的进化。这比单纯刷榜更具启发性——模型不再只是死记硬背图文对,而是在尝试构建一种** structurally consistent(结构化一致)**的世界理解。
局限性:虽然 R-C2 在选择题和简答题上表现优异,但在开放性极强的创意生成任务中,如何定义“循环一致”仍是一个挑战。此外,该方法目前主要针对离线训练,如何实现高效的在线即时强化学习仍有待探索。
未来展望:随着 Agent 任务(如浏览网页、操控手机)的爆发,R-C2 这种要求在视觉截图和底层代码间保持高度一致的方法,极有可能成为未来视觉 Agent 的标配补丁。