
[arXiv 2026] 拒绝大而无当:长文本推理的“原子化”解耦与强化学习之路
A Decomposition Perspective to Long-context Reasoning for LLMs
本文提出了 AbR (Anchor-based Reasoning) 框架,通过将复杂的长文本推理分解为五种“原子能力”,并利用强化学习(RL)在 4k 规模的合成数据上进行针对性训练。该方法使 DeepSeek-R1-distill-32B 在 Loogle 和 LongBench-v2 等六大长文本基准测试中平均提升了 7.7%。
TL;DR
处理 128k 甚至 1M 的上下文,仅仅靠“记住”是不够的。本文提出了一种全新的视角:长文本推理并非单一技能,而是由一系列“原子能力”组成的层级频谱。作者通过自动合成 4,000 条高质量原子任务数据,配合 GRPO 强化学习,成功让 32B 模型在长文本表现上逆袭 235B 的巨型模型。
背景定位
目前长文本领域存在一个尴尬的现象:模型的上下文窗口(Context Window)越来越大,但实际的推理质量(Reasoning Efficacy)却跟不上。很多模型能通过简单的“大海捞针”(NIAH)测试,但在面对干扰信息或需要多步计算的财务报表分析时却频频翻车。本文通过 AbR (Anchor-based Reasoning) 框架,一针见血地解决了“高质量训练数据难求”且“任务目标模糊”的问题。
痛点深挖:为什么“大海捞针”不再灵了?
作者指出,现有的长文本训练存在三个核心局限:
- 任务颗粒度太粗:直接拿真实的长文档做微调,模型很难学会区分什么时候该检索,什么时候该推理。
- 检索天花板:简单的 NIAH 是长文本的基石,但由于缺乏对抗性,模型容易受到“诱导噪声”的干扰(Anti-Interference 瓶颈)。
- 验证成本高:真实长文本数据的 Ground Truth 极其难以自动化验证,导致训练效率低下。
核心方法论:原子能力拆解
作者将长文本推理从低到高分为五个等级,这构成了本文最核心的 Atomic Skill Taxonomy:
- Foundational Retrieval (NIAH):大海捞针,最基本定位能力。
- Anti-Interference:在相似的干扰项中精准识别目标。
- Global Integration:跨文档的信息聚合。
- Relational Reasoning:理解文本背后的逻辑结构(如数据库 Join 操作)。
- Dynamic State Tracking:最难的一环,需要一边检索一边计算,并维护中间状态。
自动化数据流水线 (AbR Framework)
为了训练这些能力,作者设计了一个“锚点嵌入”方案:先生成逻辑蓝图(JSON),再根据模板生成可执行的数学表达式,最后合成带有随机噪声的超长文档。
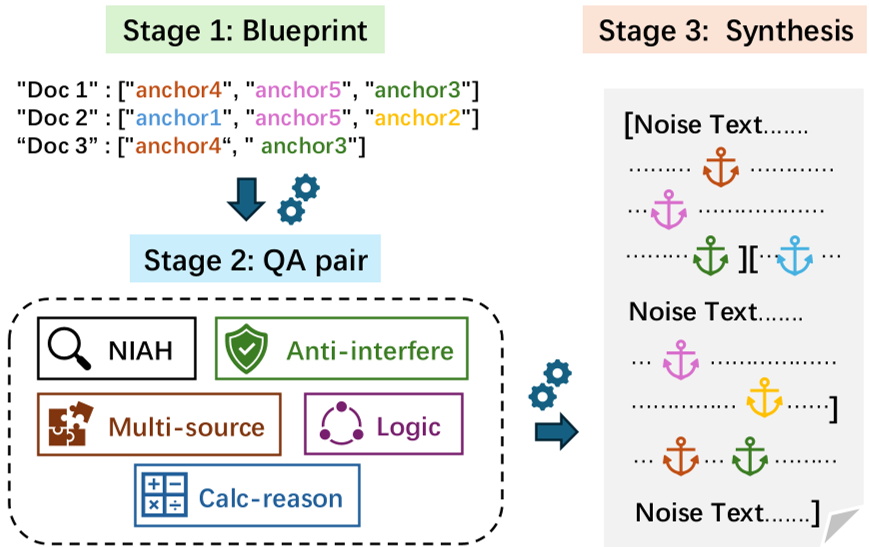 图 1:AbR 框架通过三阶段流水线实现可控、可验证的长文本数据合成。
实验战绩:以小博大的胜利
实验结果非常震撼。在 DeepSeek-R1-distill-32B 上应用该方法后,其在多个硬核榜单(如 LongBench-v2, Loong)上的表现显著超越了 DeepSeek-V3.1 和 Qwen3-235B。
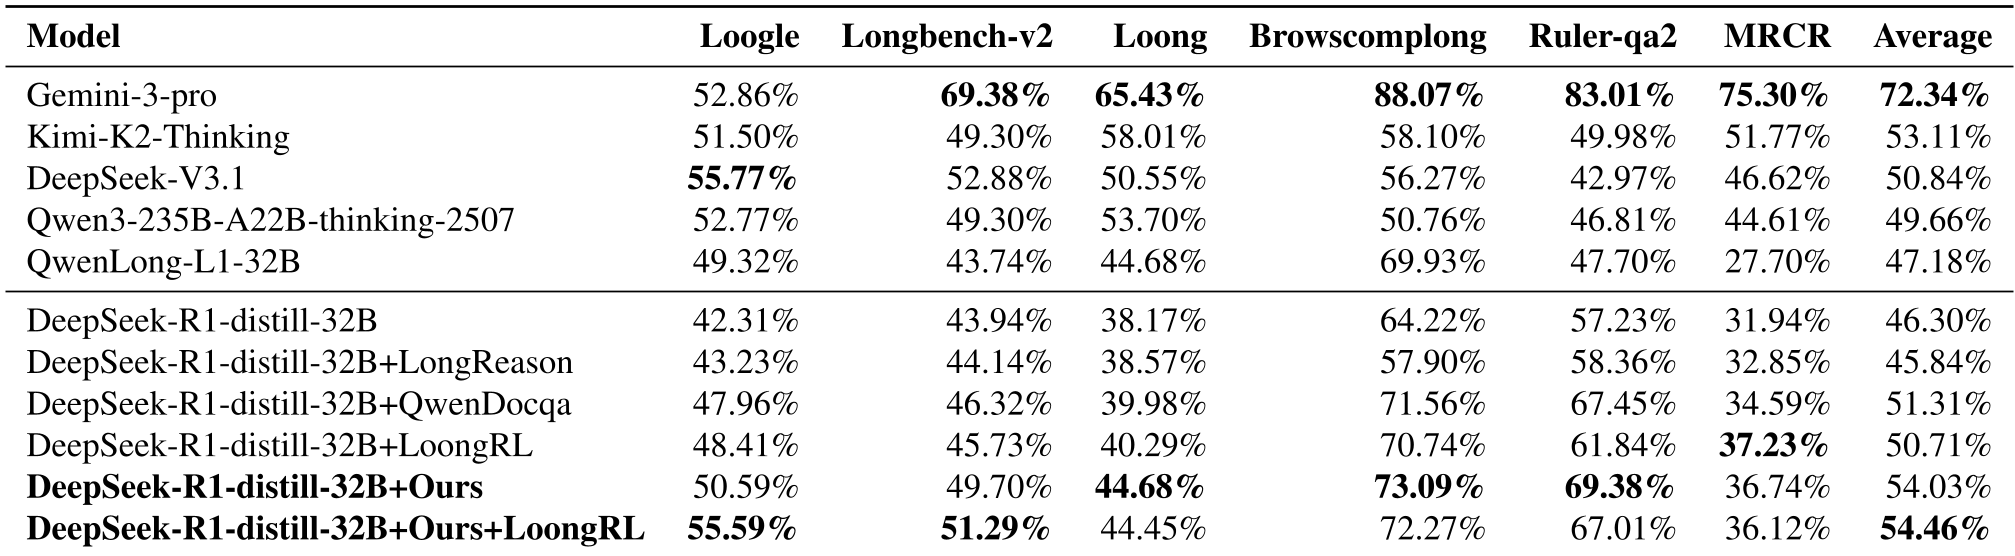 表 1:在各个长文本基准测试中,本项目方法(Ours)均展现出显著的领先优势。
深度洞察:能力间的“非正交性”
通过消融实验,作者发现了一个有趣的现象:
- Global Integration 是“稳定剂”:去掉它,模型在所有原子任务上的表现都会下滑。
- 逻辑与计算的层级性:移除逻辑推理模块后,模型的计算性能下降远比反之更严重(如下图热图所示)。这说明,高阶的动态状态追踪必须建立在扎实的逻辑结构理解之上。
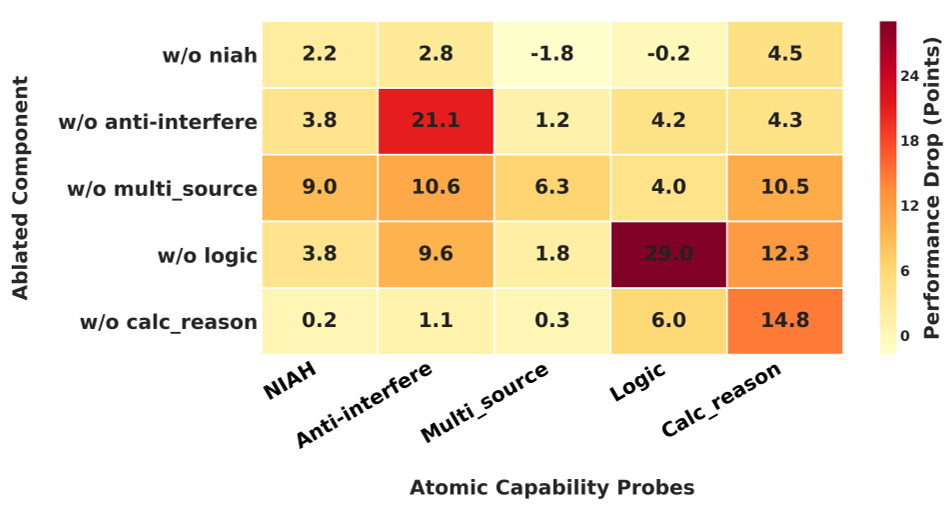 图 2:原子能力间的相互依赖性分析,展示了逻辑推理的基础支撑作用。
总结与局限
这项工作证明了:长文本能力的提升不一定需要海量的真实数据,精巧设计的合成数据结合 RL 路径更加高效。
局限性:虽然本文在合成数据上取得了巨大成功,但在处理具有极高领域专业性(如医学或法律语料中的隐式逻辑)时,这种基于“锚点”的显式逻辑是否能完美迁移,仍需进一步验证。
未来启示:未来的 LLM 长文本优化或许应更加关注“思维链(CoT)”在超长上下文中的持久性,而不仅仅是注意力机制的线性化。