
DSCache:解耦缓存构建,让离线大模型精通流式视频理解
Decouple and Cache: KV Cache Construction for Streaming Video Understanding
本文提出了 Decoupled Streaming Cache (DSCache),一种无需训练的 KV Cache 构建机制,旨在将离线预训练的多模态大模型(MLLMs)适配到流式视频理解任务中。该方法通过解耦“累积过去”和“即时当前”缓存,在 StreamingVQA 任务中实现了 SOTA 性能,平均准确率提升 2.5%。
TL;DR
在处理无限长度的视频流时,现有的 MLLM 常因为 KV Cache 的“统一更新”导致旧信息干扰新信息的编码,且难以应对位置编码异常。DSCache (Decoupled Streaming Cache) 通过解耦“累积历史”与“即时感知”,并引入位置无关编码,在无需任何训练的前提下,让预训练模型在流式视频 QA 中实现了 2.5% 的精度跃升,同时保持了极低的推理成本。
痛点与动机:为什么“统一缓存”不够好?
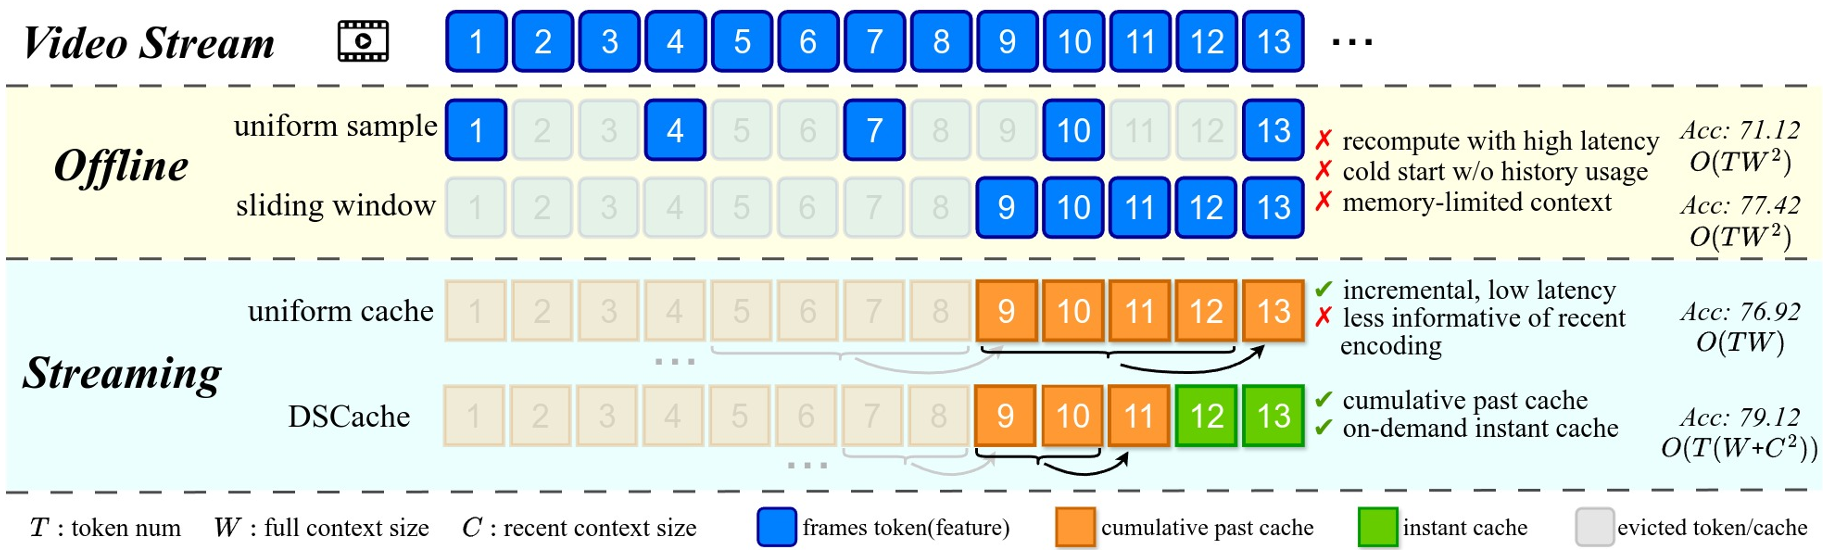
在流式视频场景中,模型需要以恒定的显存处理无限长的输入。现有的方法通常使用统一的 KV Cache 更新逻辑。然而,作者通过深入分析发现两个致命缺陷:
- 累积效应(Cumulative Effect):在统一更新模式下,新生成的 KV Cache 是基于包含旧信息残余的过去缓存构建的。这导致近期(Instant)的输入特征被历史“污染”,使得模型对当前发生的细节变得迟钝。
- 位置溢出与断裂:标准 RoPE 编码假设位置是连续且有上限的。流式场景中的缓存剔除会导致 Position ID 不连续,长期运行还会导致 ID 超出预训练范围,引发模型逻辑混乱。
核心方法论:Decouple and Cache
1. 双层缓存架构
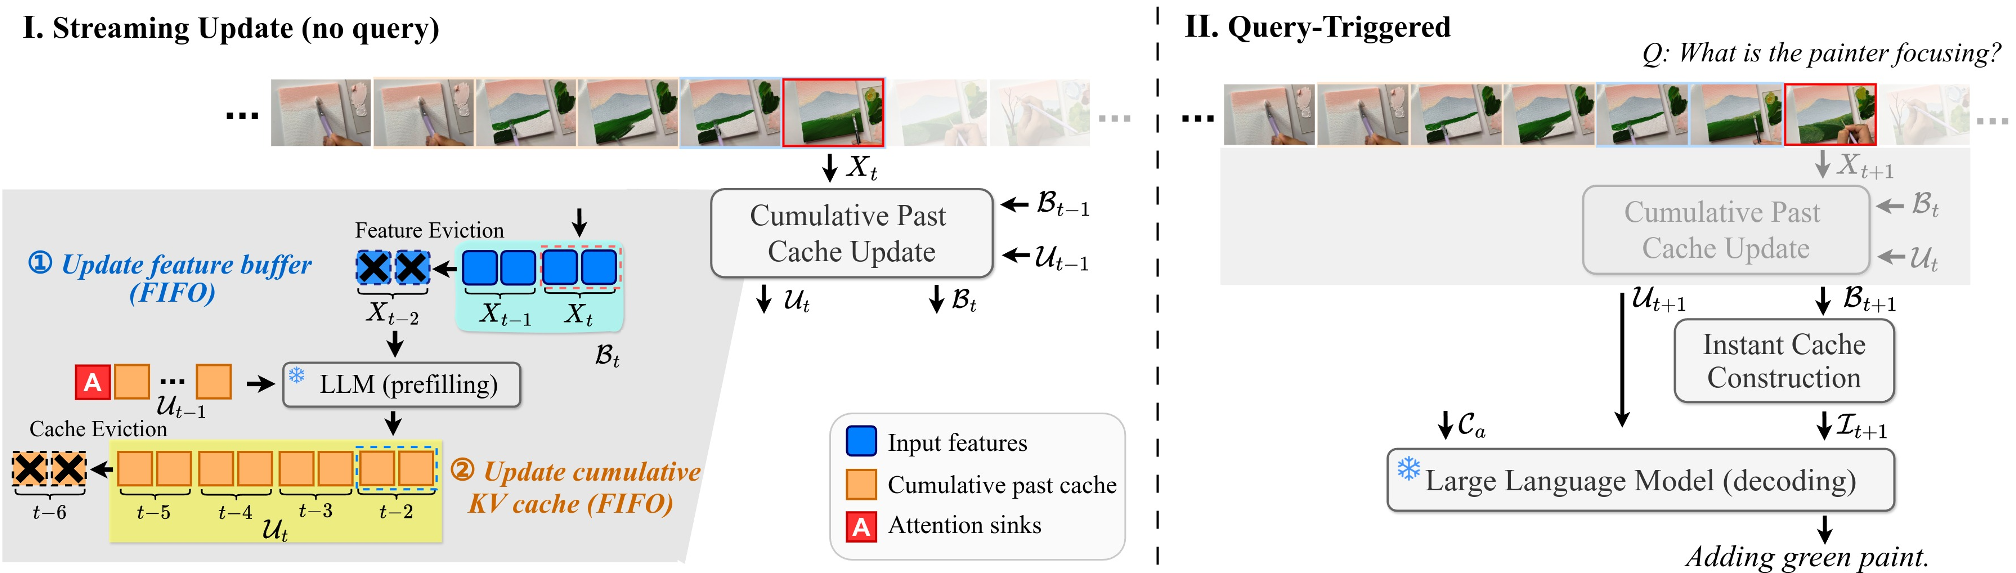
DSCache 的核心直觉是:给“最近看到的”开个特权通道。
- Feature Buffer:维护一个固定大小(如 4 帧)的原始特征缓冲区,不进行 KV 变换。
- Cumulative Past KV Cache:存储被踢出缓冲区后的历史信息的 KV Cache。
- Instant KV Cache:仅在用户提问时,从 Feature Buffer 独立生成近期 KV Cache。这种“按需构建”确保了近期信息的纯碎性,不受历史残余干扰。
2. 位置无关编码 (Position-Agnostic Encoding)
为了解决位置外推问题,DSCache 存储的是未应用位置变换的原始 KV 向量。
- 动态分配:只有在计算 Attention 的瞬间,才会根据当前窗口中 Token 的相对顺序,给它们实时穿上“位置外套”(RoPE)。
- 物理直觉:正如 Proposition 4.2 所证明,只要保持相对距离一致,这种延迟应用位置信息的方法与标准离线推理在数学上是等价的,这使得模型能够处理无限长的序列而不会出现 Position Overflow。
实验与结果:更精准、更高效
SOTA 表现
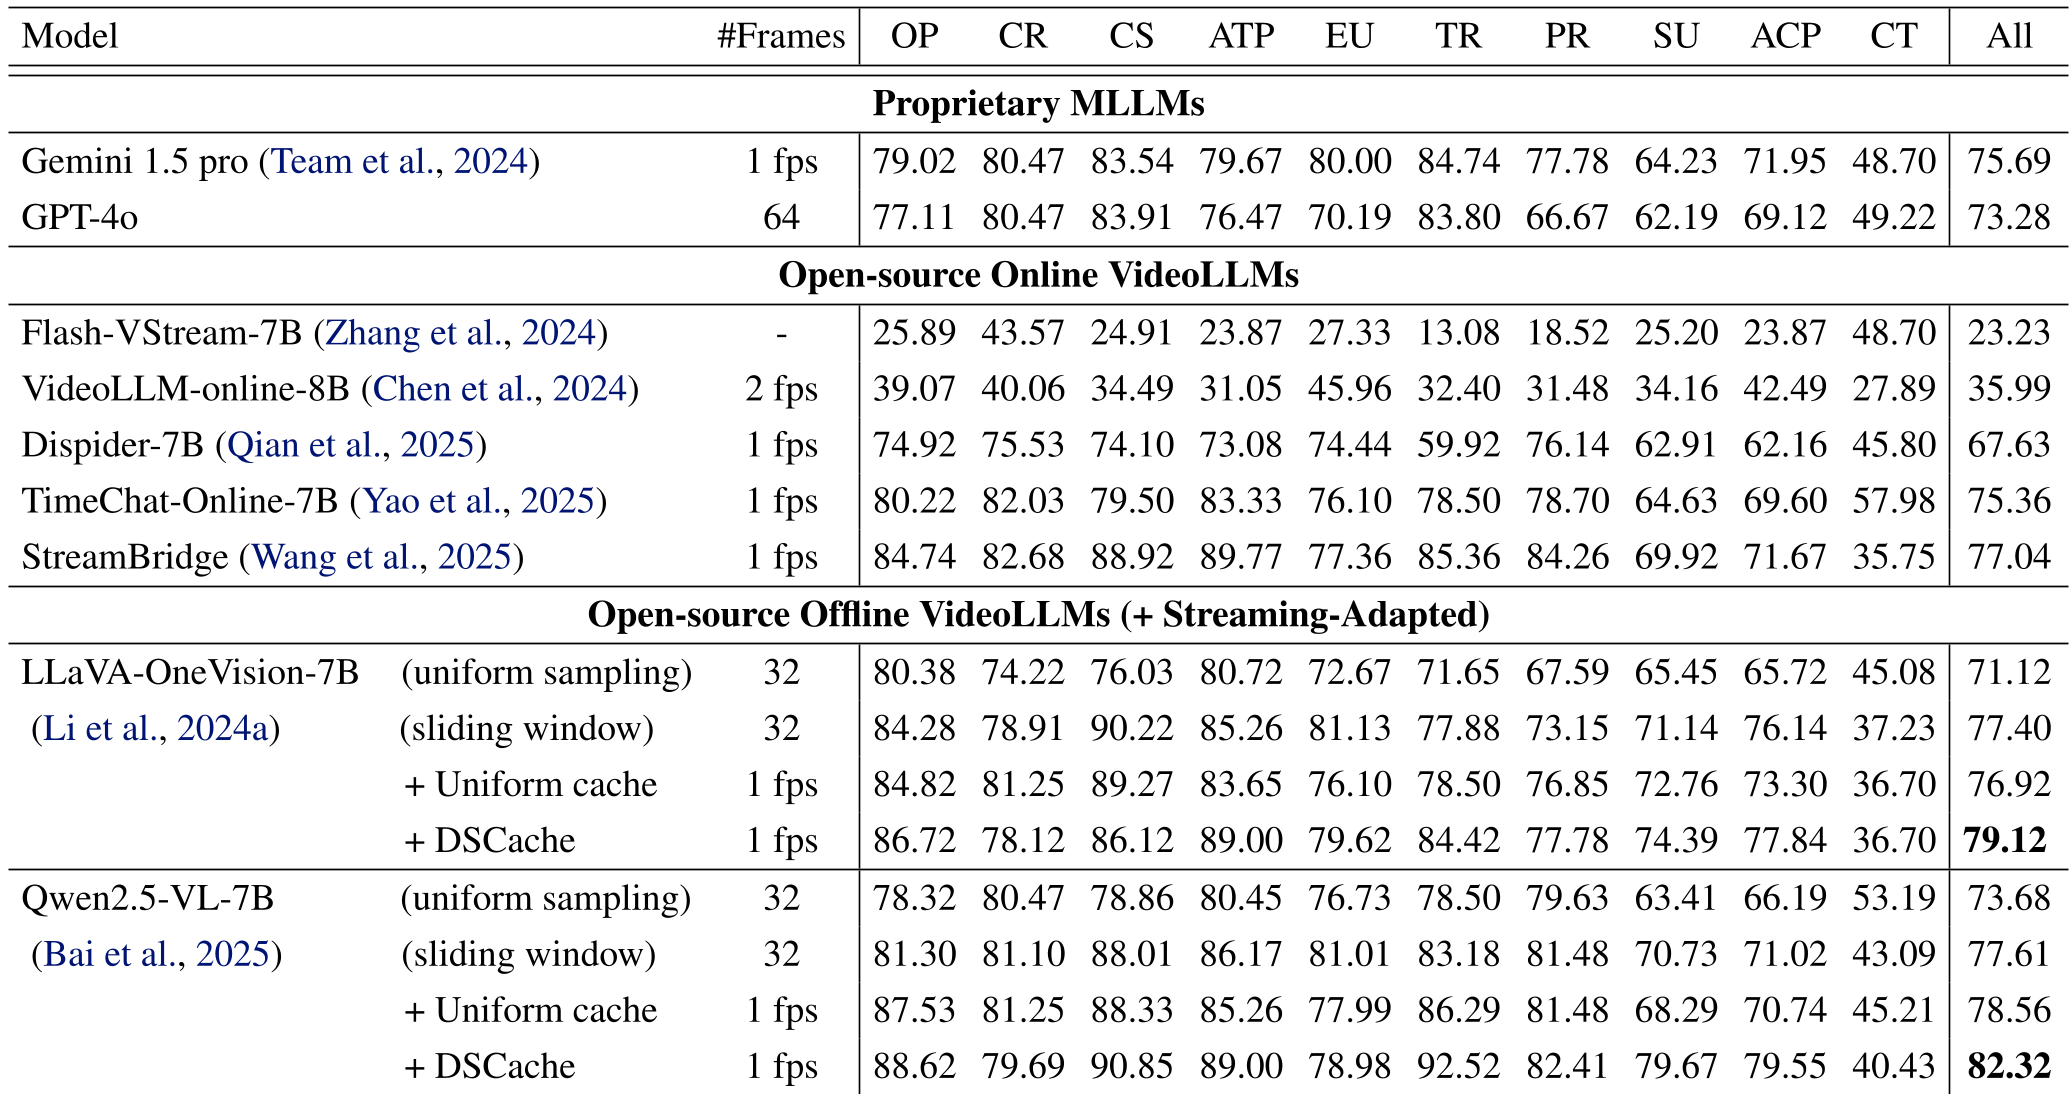
在 StreamingBench 和 OVO-Bench 上,DSCache 基于 LLaVA-OV 和 Qwen2.5-VL 等模型,全面碾压了传统的流式 baseline 和开源的在线 VideoLLM。特别是在空间理解(SU)和动作感知(ACP)上,性能提升分别高达 6.5% 和 6.7%。
性能平衡
- 内存:相比离线模型频繁重计算需要的大量显存,DSCache 将显存固定在 16-17GB 左右。
- 延迟:虽然重计算 Instant Cache 会增加少量预填充(Prefilling)时间,但总响应时间(~0.3s)远优于离线模型(~2.85s),且仅在查询时触发,完全满足实时交互需求。
深度洞察:缓存相似性的启示
作者在补充材料中展示了一个有趣的实验:比较流式缓存与单帧离线缓存的 Cosine Similarity。结果显示,传统的统一缓存相似度较低,说明它确实丢失了当前帧的保真度。而 DSCache 通过解耦逻辑,成功将注意力分配中“近期权重”从 45% 提升到 67%,这解释了其为何在细节捕捉上更胜一筹。
局限性与未来展望
虽然 DSCache 在近期理解上更强,但在涉及超长跨度推理(如 Causal Reasoning)时,仍受限于整体 context window 的大小。未来的工作可能会结合更高级的压缩或检索机制(如结合本文提到的 ReKV 或 InfiniPot-V),在保持近期高保真度的同时,进一步强化超长历史的召回。
总结:DSCache 用一种近乎“逻辑修补”的高雅方式,解决了 MLLM 在流式场景下的水土不服。这种 training-free 的特性,使其在当前大模型高速更迭的背景下具有极高的落地工程价值。