
深度时间序列预测:从自相关性建模看 SOTA 的演进逻辑
Deep Autocorrelation Modeling for Time-Series Forecasting: Progress and Prospects
本文由浙江大学、北京大学及牛津大学等机构合作,系统综述了深度时间序列预测中的核心特性——自相关性(Autocorrelation)。文章从模型架构(针对历史序列自相关)和学习目标(针对标签序列自相关)两大维度,提供了首个以自相关性为中心的统一研究框架。
TL;DR
时间序列预测的本质是什么?这篇来自 ZJU、PKU 等团队的资深综述给出了一个精准的答案:自相关性(Autocorrelation)建模。本文不仅拆解了如何构建能“读懂”历史的神经架构,更首创性地探讨了如何设计能“尊重”未来标签相关性的损失函数(Learning Objectives),打通了学术界在架构设计与目标优化之间的壁垒。
1. 核心矛盾:被忽视的“自相关偏置”
在深度预测领域,大部分人的直觉是设计更复杂的 Transformer 变体。然而,作者指出一个致命痛点:大多数模型在训练时使用的 MSE 损失函数潜意识里假设预测的每一刻是独立的。
根据论文中的 定理 5.1 (Autocorrelation Bias),如果标签序列 的条件协方差矩阵 不是对角阵(即步与步之间有相关性),普通的均方误差(TMSE)就会产生偏置。这意味着,即便你的模型架构再强,错误的“考卷”(Loss Function)也会限制其上限。
2. 架构演进:如何更好地捕捉历史(History Autocorrelation)
为了让模型更有效地捕捉历史观察值之间的依赖,研究界经历了从局部到全局的范式转移。
- RNN 到 SSM (State Space Models):由于传统 RNN 的并行性差且存在内存瓶颈,最新的 Mamba 等模型通过结构化状态动力学(如 HiPPO 初始化)实现了近乎无损的历史压缩。
- CNN 的大核复兴:现代卷积结构(如 ModernTCN)借鉴了计算机视觉中的大核(Large-kernel)设计,通过扩张有效感受野(ERF)来捕捉高阶自相关。
- Transformer 的 Patch 革命:单点序列缺乏语义,PatchTST 等方法通过 Tokenization(时间分片)将局部自相关性封装进 Token,从而让 Self-attention 能在语义层面建模。
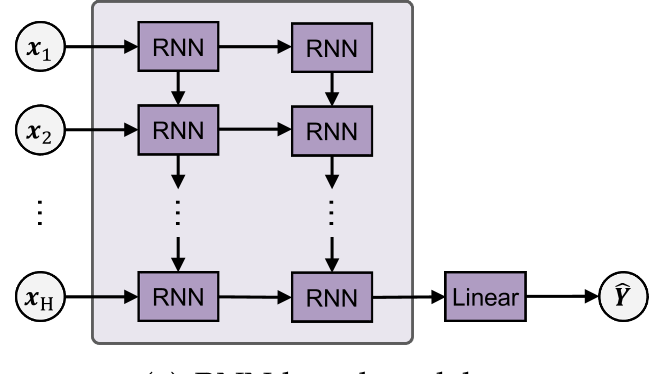 图 1:从 RNN、CNN 到领域特定架构的演进路线
3. 学习目标:如何“对齐”未来(Label Autocorrelation)
这是本综述最具洞察力的部分。作者将处理未来标签相关性的策略分为四类:
- 似然估计 (Likelihood Estimation):通过标签变换(如 FreDF 在频率空间解耦相关性)或直接对协方差矩阵 进行建模。
- 形状对齐 (Shape Alignment):不仅看点对点的误差,更看整体轮廓。SoftDTW 允许模型在时间轴上产生轻微偏移,只要“形状”对,就能获得较低的惩罚。
- 分布平衡 (Distribution Balancing):利用 Wasserstein 距离或对抗训练(GAN)确保预测分布 与真实分布 的一致。
- 条件生成 (Conditional Generation):扩散模型(Diffusion)和自回归模型通过逐步预测,天然地利用了前一步的结果作为下一步的条件,从而完美契合自相关结构。
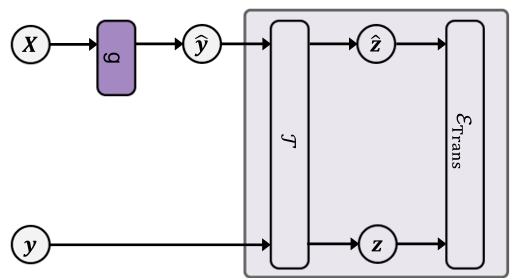 图 2:标签变换(Label Transformation)的两种主流实现路径
4. 深度洞察:时序基础模型(Foundation Models)的未来
文章最后对未来的研究方向给出了深刻启示:
- 轻量化与解耦:如果能通过 PCA 或正交变换提前消除自相关性带来的数据冗余,或许极简单的线性模型就能超越巨型 Transformer。
- Tokenization 的本质:目前的 Patch 方案仍显粗糙。如何结合多尺度、非平稳特性的自相关性设计自适应 Tokenizer,是时序大模型成功的关键。
- 生成式范式的统一:Sundial 等模型证明了条件流匹配(Flow Matching)在处理高维自相关分布时的优越性,这可能预示着预测任务向生成任务的全面转型。
总结
这篇论文不仅是一份文献清单,它更像是一个坐标系。它告诉我们,无论是改进 ResNet 还是堆叠 Transformer 层,如果不能触及“自相关性建模”这个物理直觉,所有的努力都只是参数量的堆砌。对于工程实践者来说,关注 Loss Function 的优化(如引入频率对齐或分布对齐) 往往比修改模型层数带来的增益更快、更直接。
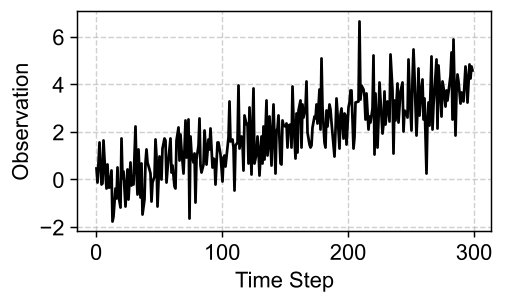 图 3:不同时序模式(随机游走、趋势、周期、季节性)下的自相关函数 (ACF) 表现