
[DeepMind 新作] Delightful Policy Gradient:解决分布式 RL 训练中的“有毒”数据偏移
Delightful Distributed Policy Gradient
总结
问题
方法
结果
要点
摘要
本文提出了 Delightful Policy Gradient (DG),一种旨在解决分布式强化学习中数据污染问题的改进策略梯度方法。该方法通过引入“Delight”(优势值与惊奇度的乘积)作为门控机制,在无需行为概率的情况下,实现了对罕见成功经验的放大和对高惊奇度失败经验的抑制。
TL;DR
在大规模分布式强化学习(RL)中,训练数据往往来自版本过时、甚至存在 Bug 的 Actor。这种数据偏移(Off-policy)会导致梯度方向严重偏差。DeepMind 研究员 Ian Osband 提出的 Delightful Policy Gradient (DG) 抛弃了依赖行为概率(Behavior Probabilities)的传统修正路线,转而通过“惊喜感”与“收益”的非对称门控,通过抑制罕见的失败并放大罕见的成功,实现了在极端噪声环境下的稳健学习。
背景定位
该工作是针对当前大模型(如 DeepSeek-R1, OpenAI o1)后训练阶段核心系统挑战的算法修补。在分布式架构中,Actor 和 Learner 之间难以保持绝对同步,DG 的提出为这类“不完美分布式系统”提供了一种极简且高效的梯度赋权方案。
痛点深挖:为什么重要性采样(IS)还不够好?
传统的策略梯度方法(如 REINFORCE, PPO, V-trace)试图通过概率比率 来修正分布差异。但这存在两个致命缺陷:
- 概率不可知:在复杂的分布式栈中,Actor 取样时的精确概率往往由于模型版本、量化偏差或系统 Bug 而变为不可知的。
- 对称性陷阱:重要性采样会平等地处理“意外的成功”和“意外的失败”。但在实际训练中,Learner 最怕的是那些它明明已经知道是“错”的动作(高惊奇度失败)却由于 Actor 的 Bug 或过期而反复出现,从而主导并拉歪了梯度方向。
核心方法:Delightful Gate 的物理直觉
DG 的核心直觉非常简单:看这个样本能教给 Learner 什么,而不是看它是谁产生的。
它定义了一个指标 Delight (Delight = Advantage × Surprisal):
- Surprisal (惊奇度):。衡量该动作在 Learner 视角下有多意外。
- Delight (愉悦度):。如果一个意外的动作带来了高额回报,这就是“极大的愉悦”;如果意外动作导致了惨败,则是“极端的惊吓”。
公式实现:
DG 通过一个 Sigmoid 函数对更新进行门控:
abla_ heta \log \pi_ heta(A_t | H_t)$$  *(注:DG 仅在标准梯度前增加了一个基于当前策略的标量权重 $w_t$)* 这种设计的妙处在于: - **正向激发**:当 $U_t > 0$ 且动作很罕见时,$w_t o 1$。 - **负向抑制**:当 $U_t < 0$ 且动作很罕见时,$w_t o 0$。模型学会了忽略那些“莫名其妙”的失败,专注从意外的成功中发掘新策略。 --- ## 实验与结果 ### 1. MNIST 诊断任务 研究者将 MNIST 分类模拟为 Contextual Bandit,并人为加入 Actor 延迟。 * **结果**:当延迟 D=1000 时,REINFORCE 完全崩溃(90% 错误率),具备精确行为概率的 PG 也只有 8% 的精度,而 DG 在不使用任何重要性权重的情况下,惊人地维持在 2% 左右。 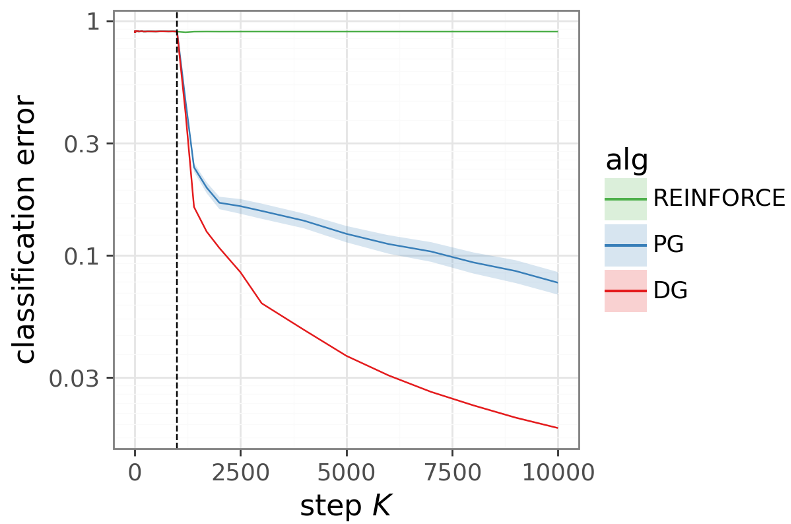 *(图左:DG 的分类误差随延迟增加保持稳定;图右:DG 的梯度方向与理想梯度的余弦相似度显著更高)* ### 2. Transformer 序列任务:Token Reversal 在更接近大模型推理的 Token 翻转任务中,作者引入了四种摩擦(Frictions):**Actor 过时、代码 Bug、奖励损毁、稀有发现**。 * **SOTA 对比**:在所有干扰同时存在的情况下,DG 在序列长度 $H=13$ 时依然能找到完美解,而 PMPO 只能到 $H=8$,PPO 仅能处理 $H=5$。 * **计算优势**:随着任务变难,DG 展现出了“数量级”级别的计算效率提升。 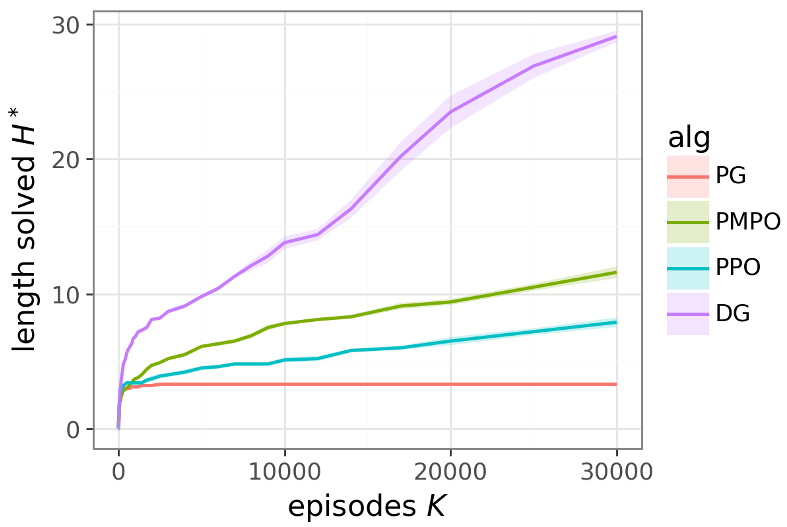 *(如图所示,DG(Delightful)解决复杂序列问题的能力随训练步数显著超越了 PPO 和 PMPO)* --- ## 深度洞察:自我强化的动力学 论文在第 4 节给出了严谨的数学证明:**DG 的优势在于其能够将“污染”转化为一种随策略提升而缩小的“重叠矩”(Overlap Moment)。** 这形成了一个**自我强化循环**: 1. 策略变好。 2. 模型对错误动作的 Surprisal 更高。 3. DG 门控更有效地滤除这些错误样本。 4. 梯度更纯净,策略进一步变好。 这种“非对称抑制”是任何 sign-blind(对正负号不敏感)的重赋权方法(包括精确的重要性采样)都无法模拟的特征。 ## 总结与局限性 **Takeaway**:DG 证明了在分布式 RL 环境下,追求“精确修正”Actor 分布偏差可能是方向性的错误。相反,利用 Learner 自身的惊奇感进行过滤,能更本质地保护梯度免受“意外失败”的毒化。 **局限性**:目前实验主要在小规模(MNIST, 50K 参数 Transformer)上进行。虽然其数学逻辑具有普遍性,但在超大规模训练(如万亿参数模型)中的超参数 $\eta$ 敏感性和稳定性仍需实践验证。 --- **资深主编点评**:“Delightful”这个命名不仅有趣,而且精准。它捕捉到了强化学习的本质——从意外的惊喜中学习,同时对荒谬的失败保持警惕。