TL;DR
在 LLM 预训练中,激活值的稳定和权重的正则化通常由 RMSNorm 和 Weight Decay 这类外在的“脚手架”来维持。本文提出了 MACRO (Msign-Aligned Constrained Riemannian Optimizer),证明了通过将模型权重显式约束在特定的数学流形(如 Frobenius 球面或谱球面)上,可以完美替代上述启发式机制。MACRO 不仅能让模型在没有可学习归一化层的情况下稳定训练,还能在 1B 规模的实验中超越当前最强的 Muon 优化器。
背景定位
目前大规模预训练的稳定性很大程度上归功于工程上的各种“Trick”。虽然近期有研究尝试引入流形约束(Manifold Constraints),但往往面临计算效率低(需要复杂的子循环)或缺乏严谨理论支撑的问题。MACRO 成功地在**严谨性(黎曼几何)与工程可行性(单循环 GPU 高效实现)**之间找到了甜点区。
痛点深挖:我们为什么需要 Norm 和 Weight Decay?
在标准的 LLM 架构中:
- 激活值爆炸:如果没有层归一化,网络层数增加会导致激活值尺度失去控制。
- 权重漂移:Weight Decay 在物理直觉上是为了防止权重无限增长,并诱导一种所谓的“旋转均衡(Rotational Equilibrium)”。
作者通过深度拆解发现:流形约束本质上通过几何边界直接封锁了这两个问题的源头。
方法论详解:几何上的“降维打击”
MACRO 通过一种单循环的黎曼优化框架,在每一步更新中将梯度投影到流形的切空间上。
核心公式直觉:
abla_{\mathcal{M}} \mathcal{L}(\mathbf{W}_{t}))$$
$$ \mathbf{W}_{t+1} = \mathcal{P}_{\mathcal{M}} (\mathbf{W}_t - \eta_t c R \cdot O_t) $$
这里的 $O_t$ 是在流形切空间内找到的最速下降方向。通过将权重限制在半径为 $R$ 的球面上,MACRO 强制锁定了**相对学习率 (Relative Learning Rate)**。这意味着权重的模长永远不变,所有的参数更新都变成了单纯的方向旋转。
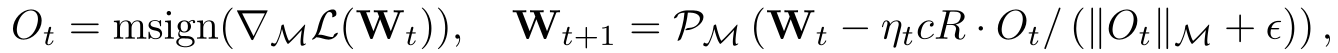
*上图:MACRO 的核心更新逻辑,展示了如何通过切空间投影(Tangent Space Projection)保持几何一致性。*
## 实验与结果:彻底告别 RMSNorm?
研究最惊人的发现之一是:当完全移除可学习的 RMSNorm 参数后,传统的 Muon 优化器立即触发 NaN 报错崩溃,而 MACRO-spec(谱球面约束)依然能稳定运行。
### 关键实验数据:
在 330M 模型的实验中:
- **Muon (基础版)**: 在标准学习率下直接 Diverge (NaN)。
- **MACRO-spec (谱球面)**: 不仅稳定,其验证损失(2.739)甚至逼近了带有完整归一化层的模型。
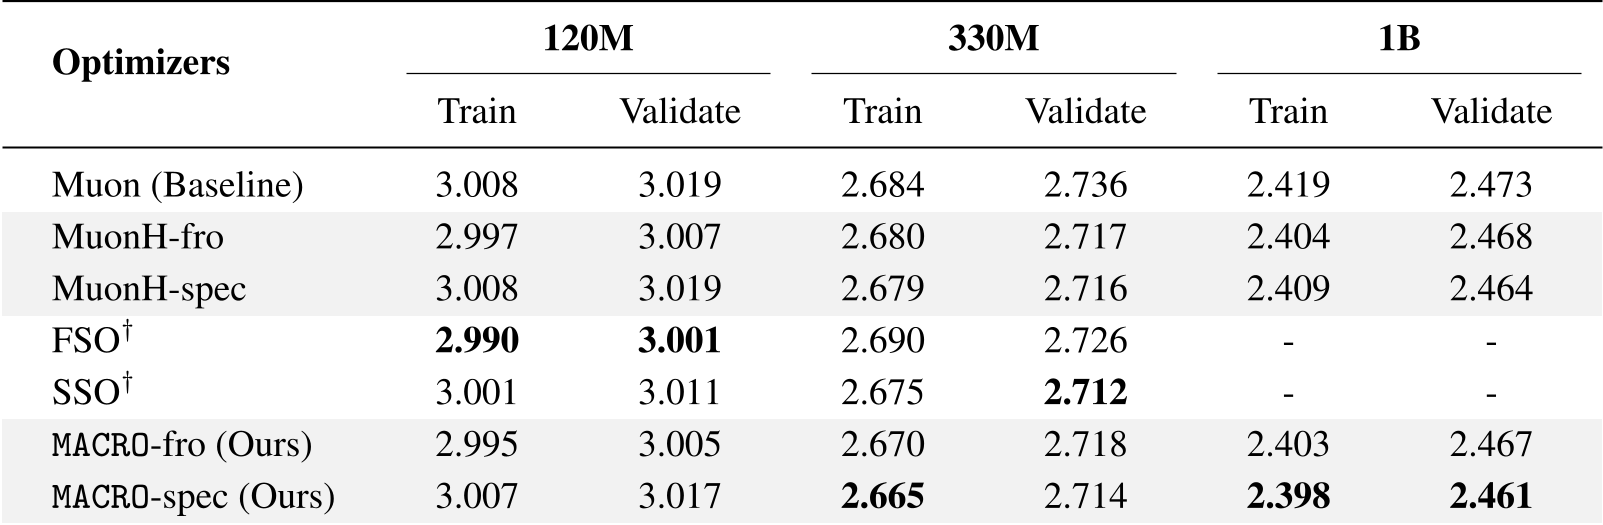
*表:在不同规模(120M, 330M, 1B)下,MACRO 相比基准优化器在训练与验证损失上的优势。*
### 深度洞察:Spectral vs Frobenius
- **Spectral Sphere (谱球面)**:控制的是最坏情况(Worst-case)的激活缩放,在没有 Norm 层时表现最稳劲。
- **Frobenius Sphere (F-球面)**:控制的是平均激活水平,更适合与标准架构结合使用。
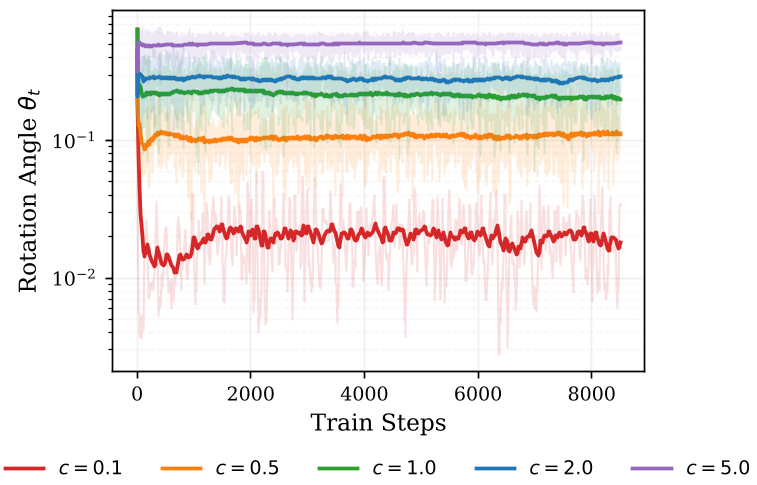
*图:Spectral 约束下的自适应旋转平衡。与 Weight Decay 缓慢进入平衡态不同,MACRO 从第一步起就强制处于旋转稳态。*
## 总结与局限性
**Takeaway**: MACRO 证明了“约束”优于“惩罚”。流形几何约束不仅是理论上的优美,在实际训练超大规模模型时,它能提供比手工调参 Weight Decay 更强的鲁棒性。
**局限性**: 目前 MACRO 对所有层使用了统一的约束半径。由于不同 Transformer 模块(如 Self-attention 与 FFN)的动态特性不同,未来需要研究如何实现“层敏感(Layer-wise)”的自适应流形约束,以填补移除归一化层后那最后一点点的性能差距。