
[Nature-Inspired] 视频推理的真相:不是“帧的串联”,而是“步的演化”
Demystifing Video Reasoning
本文对扩散视频生成模型的推理机制进行了深度解密。研究发现,视频模型的推理并非此前认为的按帧展开(Chain-of-Frames),而是在扩散去噪过程中逐步涌现的,作者将其命名为 "步骤链"(Chain-of-Steps, CoS)。
TL;DR
长期以来,我们认为视频模型之所以能“思考”,是因为它像人类看电影一样一帧帧处理逻辑。但这篇来自 SenseTime 和 NTU 的最新研究《Demystifying Video Reasoning》彻底颠覆了这一认知:视频推理实际上是沿着扩散去噪的步骤(Steps)发生的,而非时间帧(Frames)。 研究定义了 Chain-of-Steps (CoS) 机制,并揭示了模型在去噪早期如何像生物大脑一样并行模拟多种可能性。
痛点深挖:时序逻辑的陷阱
此前的研究(如 ChronoEdit)倾向于将视频能力归功于所谓的 Chain-of-Frames (CoF),即认为逻辑是随着视频时间的流逝而逐帧建立的。但这种假设在面对需要“全局观”的逻辑任务(如走迷宫、物体遮挡、三维旋转)时显得捉襟见肘。如果逻辑只存在于帧间,那么对单一帧的扰动应当是致命的,而对去噪步骤的扰动则应当相对温和。事实恰恰相反。
核心直觉:Chain-of-Steps (CoS)
作者通过解码扩散过程中每一个 Step 的预测原始状态(Estimated Clean Latent ),观察到了令人震惊的一幕:
- 多路径探索 (Multi-Path Exploration):在去噪的前 1-5 步,模型并不会直接确定一条路径。在迷宫任务中,你会看到几个模糊的轨迹同时存在。这极像生物大脑在做决策前的“模拟演练”。
- 叠加态 (Superposition):模型会同时生成物体旋转的不同状态、不同大小的重叠物,并在去噪中后期通过“剪枝”压制错误的假设,收敛到唯一解。
 图 1:迷宫求解中的 CoS 过程。早期步骤并行探索多条路径,中期开始剪枝,晚期确定唯一正解。
方法论:层级功能的演化
为了验证 CoS,作者针对 Diffusion Transformer (DiT) 进行了深入的剖析。通过对 40 层 Transformer 的 Token 激活进行可视化,研究发现模型内部存在自发的功能专业化:
- 浅层 (0-9层):负责背景建模与全局结构感知。
- 中层 (20-29层):推理发生的“震中”。这里负责处理物体交互、逻辑关系和语义对齐。
- 深层 (30-39层):负责潜变量的细节加固与生成优化。
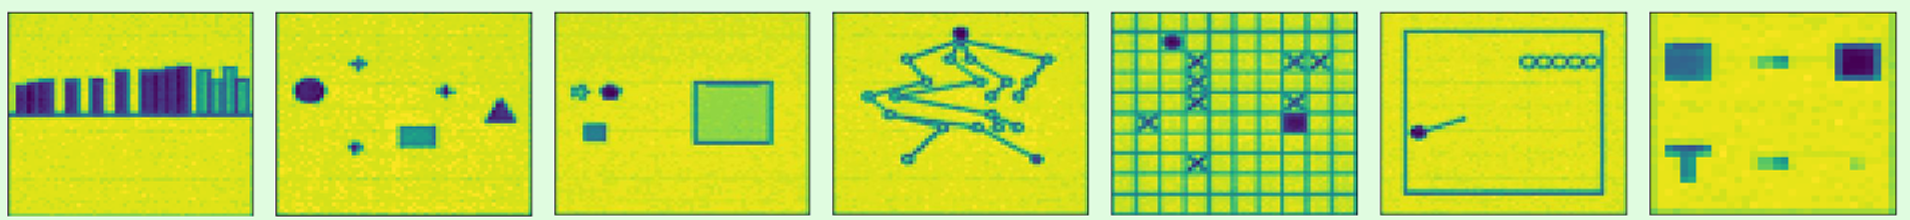 图 2:层级可视化。可以清晰看到感知到推理的过渡。
关键证据:噪声扰动实验
这是一个教科书般的消融实验。作者对比了“按步注入噪声”和“按帧注入噪声”:
- 按步扰动:推理得分骤降至 0.3 以下。
- 按帧扰动:模型表现出惊人的鲁棒性,因为它可以通过双向注意力(Bidirectional Attention)从其他未受扰动的帧中恢复逻辑。 结论:扩散步骤才是推理生成的垂直轴心。
实验与结果
基于这一发现,作者提出了一种 Training-Free Ensemble 策略。既然模型在早期会随机探索路径,那么使用 3 个不同的随机种子运行模型,并在最关键的推理层(20-29层)对潜变量进行空间平均,不就能集思广益了吗?
结果表明,这种无需任何重新训练的方法直接将 VBVR-Wan2.2 的性能提升了 2%。在复杂的 3D 旋转和物体永久性任务中,这种“专家多数投票”机制能有效滤除单次生成的随机错误。
 表 1:在 VBVR-Bench 上的 SOTA 表现。
深度洞察:视频模型作为“快慢思考”的结合体
这项工作最令人兴奋的地方在于,它将扩散模型的迭代过程(Iteration)与认知心理学中的“慢思考”联系了起来。扩散步骤不再仅仅是为了提升画质,它通过时空全注意力的“多次循环”,完成了一次次逻辑自校正(Self-correction)。
局限性分析:尽管 CoS 解释了推理的发生,但对于超长视频,计算量依旧巨大。视频模型的推理成本远高于 LLM 的 Token 生成。
未来展望:如果推理是在去噪中发生的,我们是否可以设计专门的“推理步骤引导(Reasoning Guidance)”?或者在推理密集层注入更强的计算资源?视频模型或许是实现物理世界通用智能(World Model)的捷径。
本文由资深学术主编重构。如需引用,请参考原论文:Wang et al., "Demystifying Video Reasoning", 2026.