
重新审视扩散模型的泛化:从“为什么不记忆”到“学到了什么”
Understanding diffusion models requires rethinking (again) generalization
本文探讨了扩散模型(Diffusion Models)的泛化机制,指出其与监督学习存在本质不同:在扩散模型中,记忆训练集与生成新样本是互斥的。研究通过 CIFAR-10 上的实证分析,揭示了模型容量、数据集大小及优化参数对“泛化”与“记忆”切换的影响。
TL;DR
在生成式 AI 领域,扩散模型(Diffusion Models)的泛化能力一直带有某种神秘色彩。传统的监督学习理论认为模型可以过拟合但依然泛化(Benign Overfitting),但在扩散模型中,过拟合就意味着“死记硬背”——直接复制训练集,失去生成新样本的能力。本文认为,扩散模型之所以在实践中表现优秀,很大程度上是因为记忆延迟:在大规模数据集上,模型在还没来得及开始“背书”之前,就已经学到了足够好的特征。
痛点深挖:生成模型与监督学习的本质差异
在监督学习中,损失函数趋于零通常是好事。但在基于 Score Matching 的扩散模型中,如果训练损失降到极致,模型学到的 Score Function 会指向一个个孤立的训练样本点。
- 冲突性:记忆(Memorization)与新颖性(Novelty)在扩散模型中是互斥的。
- 指标局限:传统的 Train-Test Gap 无法衡量生成质量。即使模型在背书,它的 Test FID 可能依然很好看,因为训练集和测试集在统计分布上本来就很接近。
核心实验:预测与现实的碰撞
作者在 CIFAR-10 上通过调整数据集规模(N)和模型参数(P),观察模型从“生成新图像”转向“复制训练图”的临界点。
1. 意料之外的 Double Descent
经典理论预测损失下降后会平稳,或在过拟合时 test loss 上升。但在实验中,作者观察到了 Distributional Double Descent(分布空间内的双峰下降)。
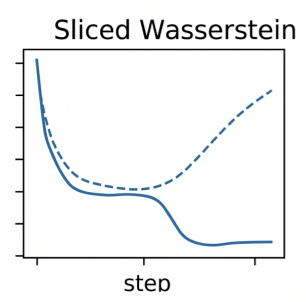 这种现象在训练和测试集上同时出现,说明它不是由容量过剩引起的经典过拟合,而是由优化动力学驱动的某种中间状态。
2. 线性扩展法则
实验证实了一个关键结论:记忆触发的时间 与数据集大小 呈线性关系。
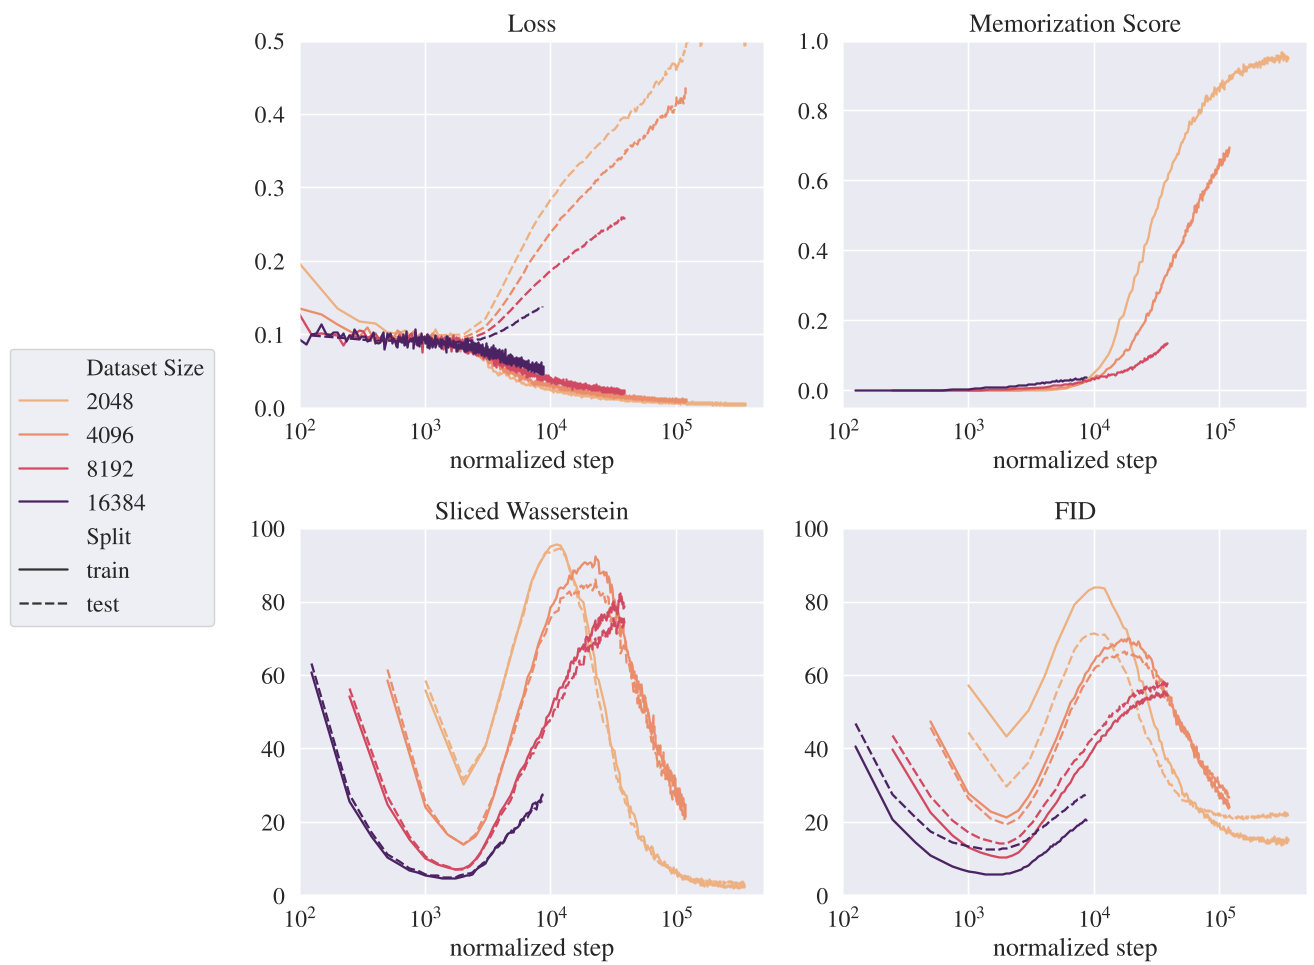
- 启示:在大规模数据集(如 LAION)上,模型还没跑到 训练就结束了。这意味着“早停”(Early Stopping)是扩散模型不记忆的最强隐式正则化工具。
方法论:优化超参数的隐式力量
除了数据集大小,优化器的选择决定了模型在“背书之前”能达到多高的上限。
- 学习率(Learning Rate):较大的学习率不仅延缓了记忆,还显著提升了峰值保真度。这与 Edge of Stability 理论呼应,即大步长能避开那些过于“尖锐”的局部最小值(即单点记忆点)。
- Batch Size:较小的 Batch Size 带来的随机噪声虽然不改变记忆速度,但能让模型在训练中达到更好的 FID。
深度洞察与总结
论文通过实证研究揭示了扩散模型泛化的三个真相:
- 大规模即正义:数据集越大,记忆越晚发生,泛化窗口期越长。
- 容量的双刃剑:增加模型参数(P)会提升生成质量,但也会加速记忆的到来。
- 指标失灵:FID 对“复制”不敏感,这为未来的评估技术提出了挑战。
局限性与展望
扩散模型理论正在经历一场“哥白尼式旋转”:我们不再纠结模型为什么不记忆,而是在问:在记忆发生前的这段时间内,模型是如何在流形上移动并捕获数据结构的? 这种从静态容量分析到动态轨迹分析的转向,将是下一代生成模型理论的核心。
Takeaway: 如果你希望扩散模型不“抄袭”,增大数据集、使用较大的学习率以及适时的早停是目前最有效的实践准则。