
DINO Soars:无需遥感数据训练,DINOv3 也能统治遥感分割 SOTA
DINO Soars: DINOv3 for Open-Vocabulary Semantic Segmentation of Remote Sensing Imagery
本文提出了 CAFe-DINO,一种利用 DINOv3 基础模型进行遥感(RS)图像开放词汇语义分割(OVSS)的新方法。该方法通过代价聚合(Cost Aggregation)和无训练特征上采样(AnyUp),在无需任何遥感数据微调的情况下,刷新了多个遥感分割基准的 SOTA 记录。
TL;DR
传统的遥感图像分割模型往往依赖于在卫星/航拍数据上的二次预训练。休斯顿大学的研究者提出 CAFe-DINO,通过将高性能视觉基础模型 DINOv3 与精心设计的**代价聚合(Cost Aggregation)及特征上采样(AnyUp)**相结合。该模型仅在自然图像(COCO-Stuff 子集)上进行微调,就在多个遥感标准测试集上全面超越了那些在数百万张遥感图像上训练过的专用 SOTA 模型。
视觉大模型的“降维打击”:为什么自然图像模型能做遥感?
长期以来,遥感(RS)社区一直认为由于俯视视角、多光谱特性和分辨率差异,必须开发领域特定的基础模型(如 Prithvi, DOFA)。然而,DINOv3 的出现挑战了这一认知。DINOv3 在 10 亿张图像上通过自监督学习,学到了极其鲁棒的特征表达。
但问题依然存在:直接利用 DINOv3 生成的文本-图像相似度图(Similarity Map)非常模糊,在复杂的遥感地物(如密集的楼房、细碎的植被)中表现不佳。
CAFe-DINO:解锁遥感能力的金钥匙
为了解决这一痛点,CAFe-DINO 提出了三个核心改进:
1. 架构解析 (Architecture Focus)
CAFe-DINO 的核心逻辑是:“提取原始相似度 -> 空间与类间聚合 -> 高清上采样”。
- 代价聚合模块 (Cost Aggregation):模型将 DINOv3 输出的低分辨率相似度图视为“代价卷(Cost Volume)”。首先使用 Swin Transformer 块进行空间细化,随后通过通道注意力机制建模不同类别之间的语义依赖。这样,即使某个类别(如“低矮植被”)在原始图中激活很弱,系统也能根据周围的“建筑”或“道路”通过逻辑推理将其精准定位。
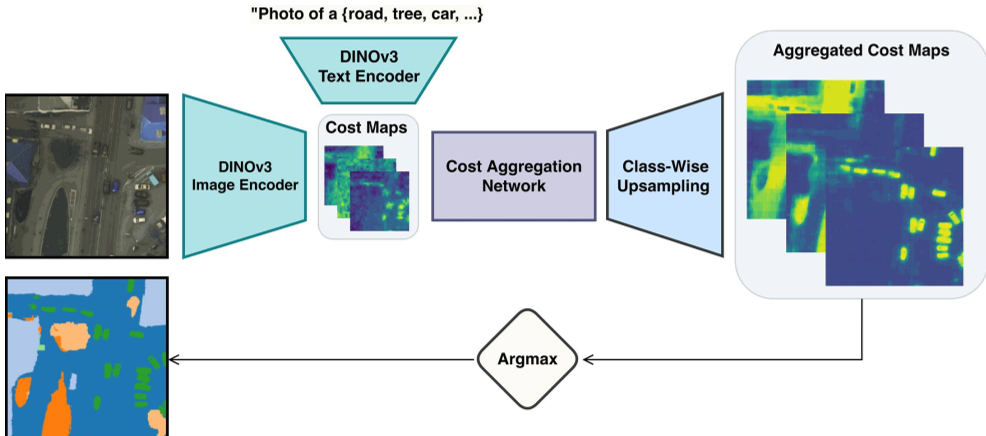 图 1: CAFe-DINO 总体架构。将 DINOv3 相似度图通过聚合与上采样转化为最终分割。
2. 无训练特征上采样 (AnyUp)
这是 CAFe-DINO 保持“RS-free”训练的关键。传统的上采样层(如卷积转置)如果针对自然图像训练,很容易在遇到遥感图像时失效。作者引入了 AnyUp,这是一种模型无关(Model-agnostic)的上采样技术,直接利用原图作为引导来提升特征分辨率,无需在遥感数据上微调也能获得清晰的边界。
实验战绩:无需“入乡”,亦能“随俗”
CAFe-DINO 在包括 Potsdam, Vaihingen, LoveDA 等主流遥感数据集上进行了严苛的 Zero-shot 测试。
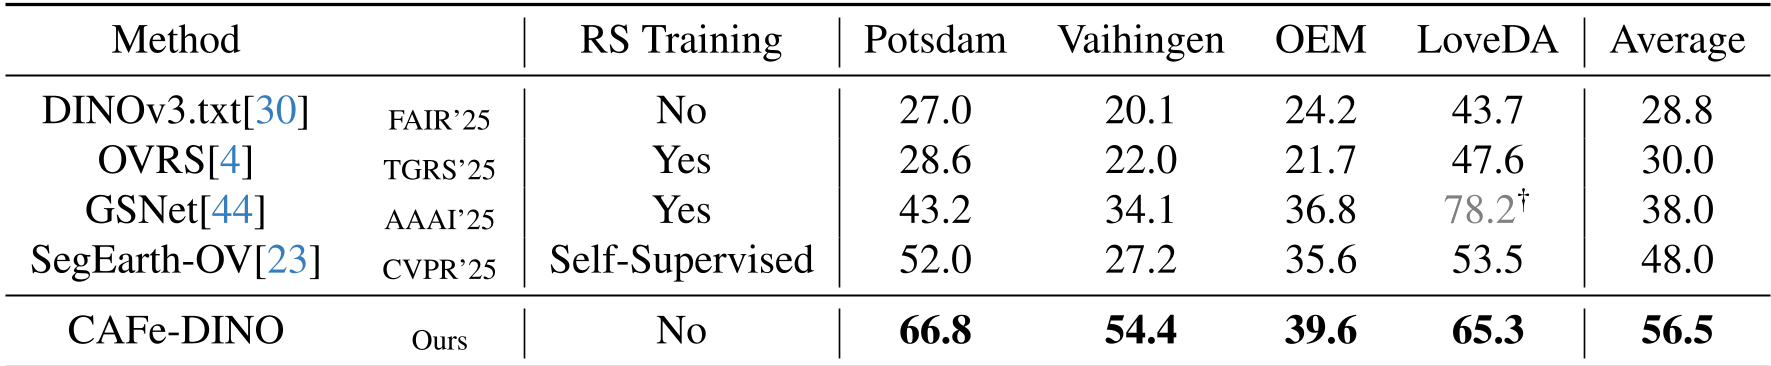 表 1: 与当前最强遥感 OVSS 模型的对比。可以看到 CAFe-DINO 在即使不使用遥感数据训练的情况下,平均 mIoU (56.5%) 远超 GSNet (38.0%)。
核心洞察:聚合的力量
如图 5 所示,原本 DINOv3.txt 在“低矮植被(Low Veg.)”类别上几乎是一团模糊的噪声。但在经过代价聚合模块后,预测图变得清晰且准确。这种“逻辑修补”能力让模型在面对从未见过的地面纹理时,依然能通过全局上下文做出专业判断。
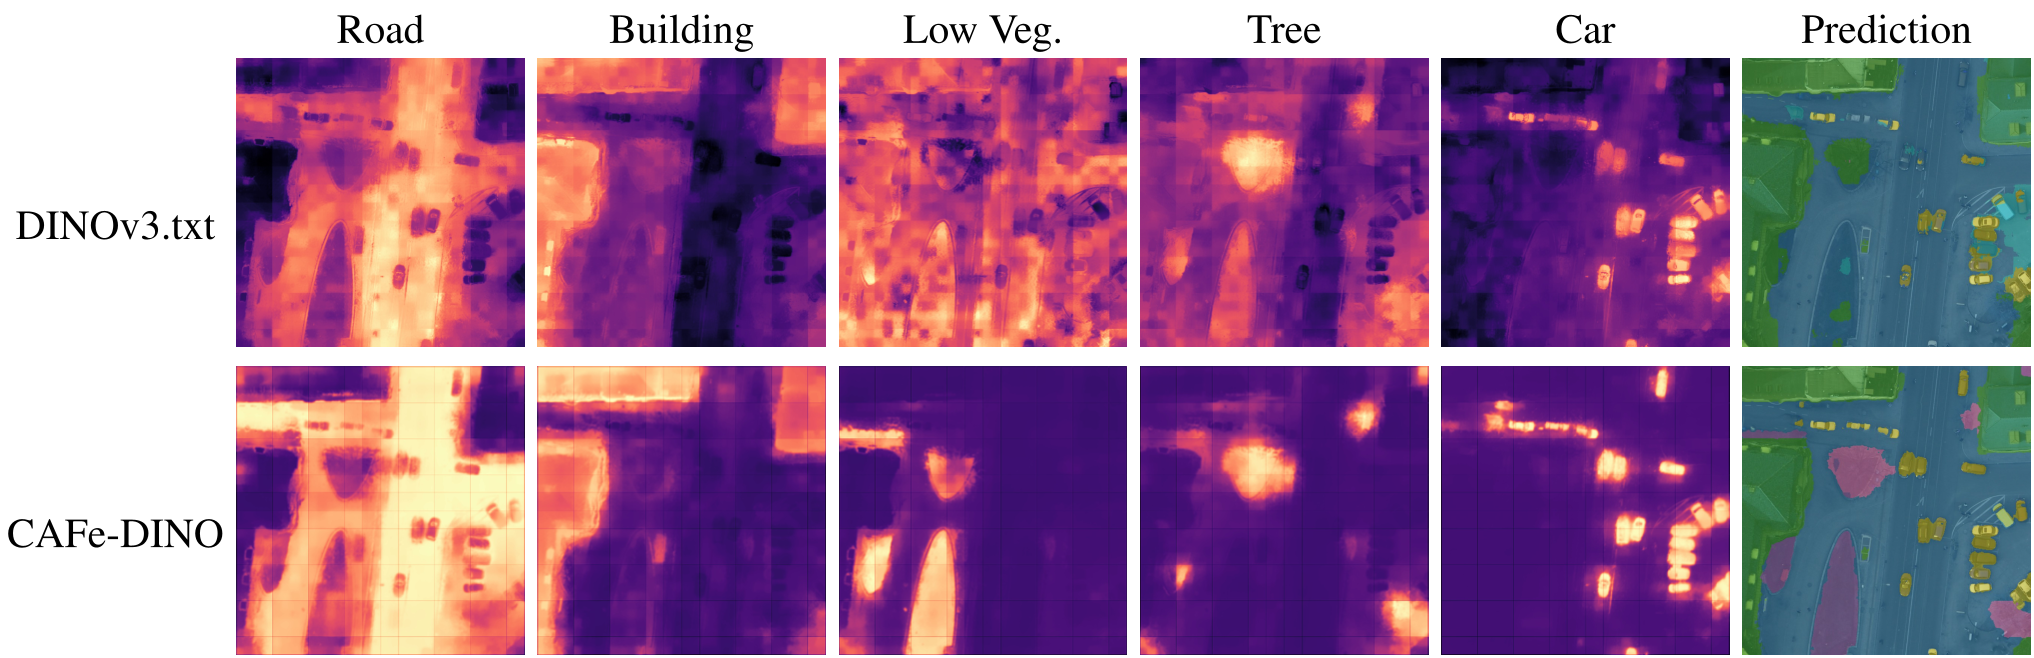 图 2: 聚合前后的对比。底层(CAFe-DINO)的概率图显著比顶层(原始 DINOv3.txt)更干净、对比度更高。
深度洞察与总结
为什么这个工作很重要?
CAFe-DINO 的成功本质上是参数规模与通用表征对比领域特定微调的胜利。它告诉我们一个深刻的启示:在视觉基础模型时代,针对特定垂直领域(如医疗、遥感)做大规模数据预训练的边际效应正在递减。相比之下,如何通过精巧的非参数化或轻量化模块(如 AnyUp)引入领域特定的 Inductive Bias 反而更加高效。
局限性与挑战
尽管 CAFe-DINO 在城市地景中表现近乎完美,但在农村/自然地物(如区分“草地”和“农田”)时偶尔会失手。这说明自然图像语料库中对于相似纹理地物的语义区分度仍然不足。未来的改进方向可能在于引入多光谱(Multispectral)维度,由于辅助光谱信息能提供物理层面的材质区分,有望彻底解决纹理混淆问题。
Takeaway: 如果你还在为遥感数据标注难而头疼,CAFe-DINO 提供了一条全新的道路:抱紧 DINOv3 的大腿,做好特征聚合。