
LIMEN:超越奖励设计,用 LLM 自动进化强化学习的观测与奖励接口
Discovering Reinforcement Learning Interfaces with Large Language Models
本文提出了 LIMEN,一个利用大语言模型(LLM)指导的进化框架,用于自动发现强化学习(RL)任务的完整接口(包括观察映射 ϕ 和奖励函数 R)。在 XLand-MiniGrid 和 MuJoCo 任务中,LIMEN 仅凭轨迹级的成功指标便能从原始仿真状态自动合成高效的可执行程序接口,展现了超越单一组件优化的 SOTA 性能。
TL;DR
在强化学习(RL)中,智能体能“看到什么”(观测)和“想要什么”(奖励)共同决定了学习的成败。传统方法往往固定观测,仅通过 LLM 优化奖励。LIMEN (Learning Interfaces via MDP-guided EvolutioN) 突破了这一局限,它首次实现了从原始仿真状态出发,利用 LLM 进化出完整的、可执行的观测与奖励程序接口。实验表明,单方面的优化在面对复杂任务时极易崩溃,而“观测-奖励协同进化”是实现稳健学习的必经之路。
1. 痛点:被忽视的“观测工程”
虽然近年来诸如 Eureka 等工作在自动奖励设计上取得了巨大成功,但它们都预设了一个完美的观测空间。然而,现实是:
- 原始状态陷阱:仿真的原始状态(Raw State)往往是杂乱无章的张量,缺乏物理直觉。
- 单一优化的局限:如果观测中缺少目标物体的相对位置,无论奖励函数设计得多么精巧,智能体也无法学会导航。
- 人工瓶颈:手动编写特征描述(ϕ)和奖励函数(R)是 RL 落地最耗时的环节。
2. 核心方案:LIMEN 的协同进化架构
LIMEN 将接口发现视为一个双层优化问题(Bilevel Optimization):
- 外层:LLM 提出候选的 Python 程序对 。
- 内层:在由接口诱导出的 MDP 中训练 PPO 智能体,并以最终成功率反馈给外层。
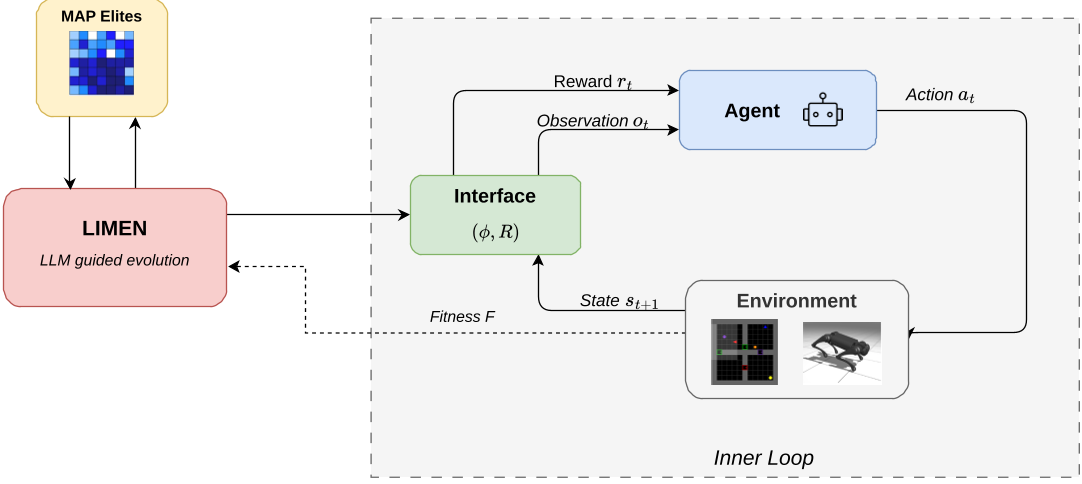
质量-多样性存档 (MAP-Elites)
为了防止陷入局部最优,LIMEN 并不只保留最好的一个接口,而是维护一个 MAP-Elites 存档。它根据“观测维度”和“奖励程序复杂度(AST 节点数)”将候选接口分类存放,确保搜索空间覆盖了从“简洁有效”到“复杂精细”的多种策略。
3. 实验发现:为什么必须联动?
作者在 XLand-MiniGrid(逻辑推理)和 MuJoCo(物理控制)上进行了严苛的对比实验。
观测 vs 奖励的瓶颈差异
研究发现了一个非常有趣的现象:
- 组合推理任务(如物体搬运)是“观测受限”的:
- 即使奖励设计得再好,如果观测中没有物体间的相对位置(Relational structure),性能依然低迷。
- 连续控制任务(如机器人避障)是“奖励受限”的:
- 传感器原始数据通常足够,但由于动作空间大,稀疏的成功奖励(Sparse Reward)根本无法提供足够的梯度信息。
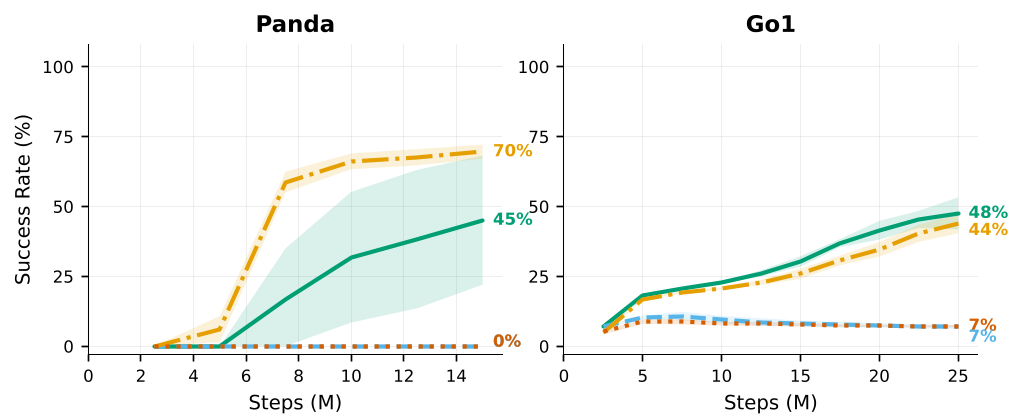
从上图可以看出,LIMEN (Joint) 在所有任务中均处于领先地位。特别是在 Hard 任务中,Sparse Baseline 和 Reward-only 几乎完全失效,而 LIMEN 依然能稳定学到。
4. 深度洞察:LLM 悟出了什么?
通过分析进化的代码,研究人员发现 LLM 自动“重新发明”了许多 RL 专家的常用技巧:
- 观测端的“感知增强”:自动计算相对几何特征、归一化距离以及阶段指示器。
- 奖励端的“里程碑设计”:设计阶段性奖金(Milestone bonuses)来引导智能体完成多步任务,例如在 quadruped(四足机器人)实验中,LLM 会先引导其站立,再引导其平衡。
5. 局限性与未来展望
尽管 LIMEN 表现惊艳,但它目前仍依赖于 JAX 环境带来的并行训练加速,因为进化算法需要频繁的内层训练。此外,对于纯视觉输入(Pixel-based)的接口发现仍是挑战。
总结
LIMEN 证明了 “接口即程序” 的观点。通过将 LLM 的先验知识注入到进化循环中,我们不仅能得到表现更强的智能体,还能得到可解释、可移植的代码接口。这标志着 RL 正在从“调参时代”迈向“接口自动化工程时代”。
注:本文提到的主要算法包含 MAP-Elites, PPO 及基于 LLM 的程序合成技术。