
[DeepMind] 你的梯度“心动”了吗?Kondo Gate 开启训练版投机采样
Does This Gradient Spark Joy?
本文提出了 Kondo Gate,一种基于前向传播信号“Delight”(优势度与惊讶度的乘积)来动态过滤 Policy Gradient 反向传播样本的机制。该方法在 MNIST 和 Transformer 序列任务中能跳过 97% 的反向传播,同时保持甚至超越 SOTA 的学习效率。
TL;DR
在传统的强化学习中,每一条采样数据都会触发一次代价高昂的反向传播(Backward Pass)。但事实上,绝大多数数据都是“废话”。Google DeepMind 的最新研究提出了 Kondo Gate,借鉴近藤麻理惠(Marie Kondo)的收纳哲学——“只留下让你心动(Spark Joy)的样本”。通过仅对产生 Delight(惊喜与价值的交集) 的样本进行训练,模型在减少 97% 反向计算量的同时,依然刷新了 SOTA 战绩。
痛点深挖:昂贵的“废话”计算
目前的强化学习算法(如 PG, PPO)在处理每一个样本时都是“一视同仁”的:
- 确定性动作的重复:如果模型已经学会了某个动作并表现良好,重复训练只是在浪费算力。
- 预料之中的失败:对于那些模型已经知道要避开的坑,强行计算梯度并不会带来额外收益。
作者指出,反向传播的成本通常是前向传播的 2-4 倍,在超大规模模型中甚至更高。如果能有一种“前哨机制”,在前向传播阶段就判断出该样本是否值得学习,就能极大释放算力。
核心机制:Delight 与 Kondo Gate
1. 什么是 Delight(喜悦)?
作者定义了一个核心信号 :
- Advantage ():衡量动作比预期好多少。
- Surprisal ():动作的稀有程度 ()。
只有当一个出人意料的动作产生了极高价值时,Delight 才会达到峰值。这对应了人类学习中的“顿悟”时刻。
2. Kondo Gate 算法流程
系统引入了一个“计算价格” 。模型先进行一次代价极小的正向传播,计算该样本的 。
- 如果 :样本“闪闪发光”,立即执行反向传播。
- 如果 :样本无趣,直接丢弃,不计梯度。
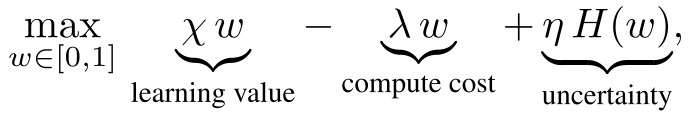
这种机制被称为“训练版的投机采样(Speculative Decoding for Training)”:用廉价的前向筛选,保护昂贵的反向更新。
实验解析:100倍的算力差距
MNIST 诊断实验
在 MNIST 任务中,作者设置了 的门控率(即只处理 3% 的反向传播)。
- 结论 A:在正向传播空间(资源充足感官)下,Kondo Gate 与全量更新(Full DG)轨迹几乎重合,远超标准 PG。
- 结论 B:在反向传播空间(真实算力消耗)下,Kondo Gate 仅需百分之一的计算量就达到了同等精度。
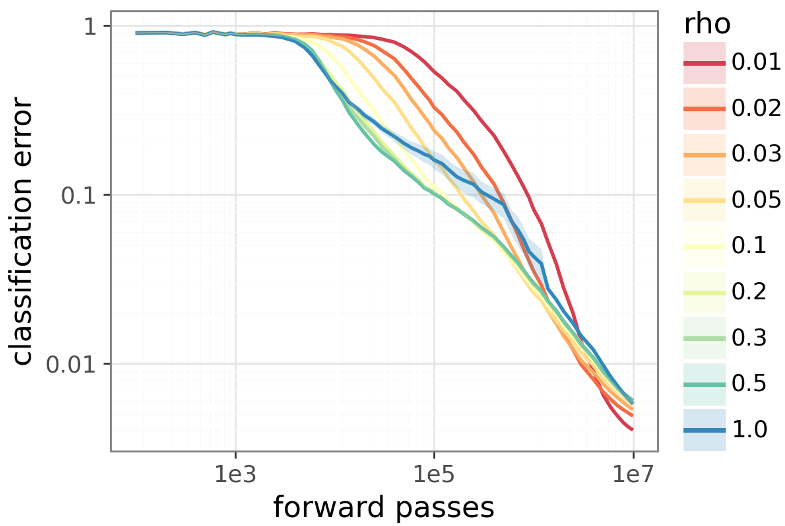 (b 轴清晰显示,达到同等误差,Kondo Gate 只需要 1/100 的反向步数)
Transformer 序列任务:解决更难的问题
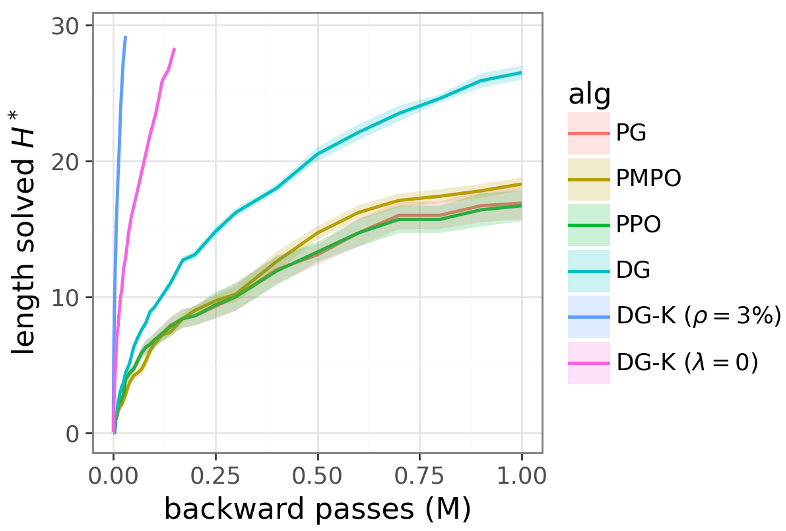
在更复杂的 Token Reversal(序列翻转)任务中,随着序列长度 的增加,有用信号变得越来越稀疏。
- 发现:Kondo Gate 竟然比 Full DG 表现更好!这是因为门控机制有效地过滤掉了由于随机漫步产生的“噪声梯度”,让模型专注于真正的逻辑突破。
深度洞察:为什么乘法而非加法?
很多之前的研究(如 PER)尝试用 这样的加法公式来筛选。但论文通过数学推导(Proposition 2)证明:
- 加法会错序:如果不小心调节超参数,加法可能会让模型优先学习那些“虽然稀有但完全错误”的样本。
- 乘法是逻辑与:Delight 只有在“有用”且“新颖”时才生效。这种 Sign-consistency 确保了门控在任何博弈环境下都是鲁棒的。
局限性:警惕“赌徒陷阱”
尽管 Kondo Gate 表现惊人,但它面临一个名为 Gambling Pathology 的失效模式。如果某个次优动作具有极高的奖励方差(偶尔能中大奖),模型可能会将其误认为是“突破”,从而自信地陷入局部最优。
总结与展望
Kondo Gate 的成功预示着 AI 训练的一个新范式:我们不缺数据,我们缺的是对数据的精准评估。
未来的大模型训练,或许不再需要每一块 H100 都在进行繁重的 Backprop。绝大多数时候,它们只需要通过一个轻量化的“心动探测器”扫一眼数据,然后只在真正关键的时刻,才动用全部算力进行深度学习。
Takeaway:如果你在做 RLHF 或者超长文本训练,是时候考虑引入前向筛选门控了。别让无用的梯度,磨灭了模型的“灵光一现”。