
DFP:突破 ODE 限制,基于 Wasserstein 梯度流的一步生成式策略
Drifting Field Policy: A One-Step Generative Policy via Wasserstein Gradient Flow
本文提出了漂移场策略(Drifting Field Policy, DFP),这是一种基于非 ODE 架构的一步生成式强化学习策略。该方法将策略更新建模为向软目标策略演化的 Wasserstein-2 梯度流,在 Robomimic 和 OGBench 等 12 项复杂机器人操作任务中刷新了 SOTA 记录。
TL;DR
在机器人操作任务中,如何既能捕捉多峰动作分布,又能实现极速推理?传统的扩散模型(Diffusion)虽然表现优异,但其依赖 ODE 轨迹的特性在 RL 微调时面临信用分配难和推理性性能受限的瓶颈。Drifting Field Policy (DFP) 另辟蹊径,抛弃了时间步概念,直接将策略更新定义为概率空间上的 Wasserstein 梯度流。它仅需一步前向演化即可生成动作,并以 95.8% 的平均成功率在 12 项复杂任务中横扫 SOTA。
痛点深挖:为什么 ODE 架构在 RL 中“步履维艰”?
目前的生成式策略(如 Diffusion Policy, Flow Matching)在行为克隆(BC)阶段表现惊人,但在从离线过渡到在线强化学习时,由于其参数化方式是定义在时间索引的向量场(Velocity Field)上的,存在以下隐忧:
- 轨迹信用分配压力:当 Critic 给出一个动作奖励信号时,该信号必须逆着 ODE 轨迹“扩散”到所有的中间步骤,这增加了学习的方差和复杂度。
- 自一致性约束:一步生成的扩散模型变体(如 Consistency Models)在更新时需要维持轨迹各处的一致性,这种全局拟合负担使得模型很难快速适应不断变化的 Q 值目标。
核心洞见:直接在概率空间“漂移”
DFP 的核心是将策略渲染为一个简单的映射 。它的独特之处在于其训练目标:漂移场(Drifting Field)。
1. Wasserstein 梯度流的物理直觉
作者证明了,漂移场的更新方向等效于在 Wasserstein-2 空间中最小化 的最速下降路径。
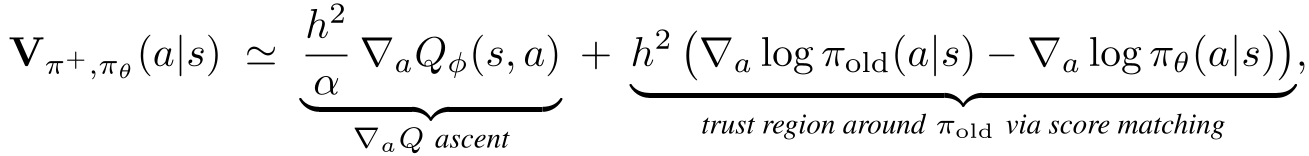 (上图公式展示了漂移场的结构分解: 的上升支柱 + 得分匹配正则项)
这个分解非常优雅:
- 吸引力 (Attraction):将生成的动作拉向高 Q 值区域,相当于执行 梯度上升。
- 排斥力 (Repulsion):从当前采样的低效区域推开,并保持与旧策略的信任区域限制(Trust Region)。
2. 易处理的 Top-K 替代方案
理想的目标策略 包含难以计算的配分函数。DFP 提出了一个简单得令人惊讶的方案:从旧策略中采样 个候选动作,选出 Q 值最高的 个作为“正样本”。 这种 Top-K 漂移损失 不仅在理论上有误差上界保障(见论文 Proposition 1),而且在实验中表现出极强的鲁棒性。
实验战绩:全线超越
DFP 在 Robomimic 和 OGBench 上与五类强基线进行了对比。
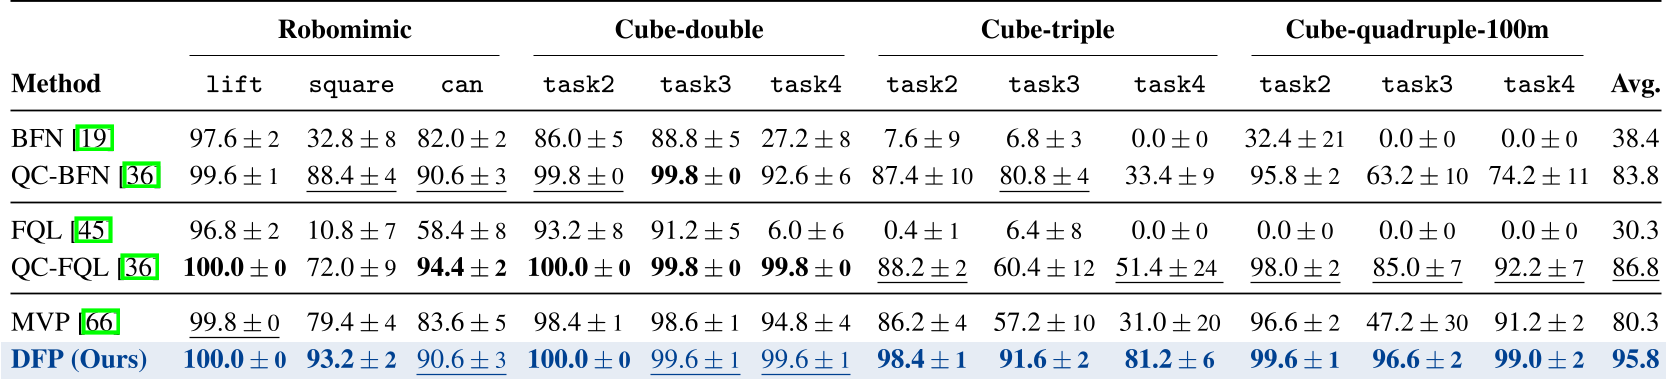
关键结论:
- 更强的 BC 能力:即使不开启 RL 微调(仅使用 BC 漂移损失),DFP 的表现也优于基于 MeanFlow 的方法,这归功于其原生的一步生成架构对多峰分布更好的刻画能力。
- 高效微调:在长序列任务(如 Cube-Triple/Quadruple)中,DFP 的领先优势巨大。在 Cube-Triple-Task4 这种极难任务中,DFP 将成功率由基线的 31% 直接拉升至 81.2%。
- 协同效应:消融实验显示,同样的 Top-K 监督如果套用在 ODE 架构(如 MeanFlow)上,性能提升微乎其微。这印证了“非 ODE 参数化 + 概率空间梯度下降”才是真正的黄金搭档。
深度解读
DFP 的成功不仅仅是由于“一步生成”比“多步扩散”快,更重要的是它改变了监督信号的作用方式。在 DFP 中,由于没有轨迹积分的干扰,奖励信号(通过 Critic 选出的 Top-K 动作)直接作用于网络的输出层。这种直接的输出层监督比扩散模型在速度场(Velocity Field)上的间接监督要高效得多。
局限性与未来展望
尽管 DFP 在模拟器中表现无敌,但仍有挑战:
- Critic 依赖性:由于利用 Top-K 采样,如果 Critic 估计不准,策略会迅速偏离。
- 复杂观测:目前主要针对低维状态空间,在端到端视觉控制(Visual RL)中的表现还有待验证。
总结:DFP 让我们重新思考生成式 AI 在控制领域的本质。当“时间轨迹”成为累赘时,勇敢地抛弃它,转而拥抱流形上的梯度流,或许才是通向高性能实时机器人的捷径。