
[CVPR 2025] DRoPS: 预扫描先验助力单目 3D 动态重建突破,极端视角不再“崩坏”
DRoPS: Dynamic 3D Reconstruction of Pre-Scanned Objects
本文提出了 DRoPS,一种利用静态预扫描(Pre-scan)作为几何与外观先验的单目动态 3D 重建方法。该方法将 3D Gaussian Splatting (3DGS) 与深度运动先验 (Deep Motion Prior) 结合,在处理高幅度肢体动作时,其渲染质量和 3D 追踪精度显著超越了当前的 SOTA 模型。
TL;DR
动态场景的 3D 重建一直是计算机视觉的圣杯任务。DRoPS (Dynamic 3D Reconstruction of Pre-Scanned Objects) 提出了一种聪明的折中方案:利用一个静态的“预扫描”作为外挂先验,配合 3D Gaussian Splatting 和 CNN 运动网络,解决了单目视频重建中“看前不顾后”的顽疾。实验证明,它在复杂人体动作和动物动画的重建质量上,以碾压姿势超越了之前的 SOTA。
1. 动机:单目重建的“三座大山”
从单目视频重建动态 3D 物体极其困难,原因有三:
- 观察缺失:单目相机只能看到物体的一面,背面完全是黑盒。
- 运动歧义:2D 像素的移动既可能是因为相机在动,也可能是物体在变形。
- 正则化难题:为了让物体不动得“太离谱”,通常需要复杂的手工约束(如 As-rigid-as-possible),但这些约束往往过于死板。
DRoPS 的直觉很简单:如果我们提前知道这个物体静止时长什么样(预扫描),那么动态重建的任务就退化为“如何让这个已知的几何体动起来”。
2. 核心技术:表面对齐的高斯网格与 CNN 运动先验
2.1 结构化表面对齐 (Surface-aligned Grid)
不同于传统 3DGS 中杂乱无章的高斯点云,DRoPS 将高斯原语组织在像素网格上。
- 构建方式:通过虚拟立体相机在预扫描模型周围拍摄,将深度图反投影,形成与表面严密贴合的网格。
- 价值:这种组织方式让每个高斯点有了确定的“邻居”,为后续使用卷积神经网络(CNN)处理运动数据扫清了障碍。
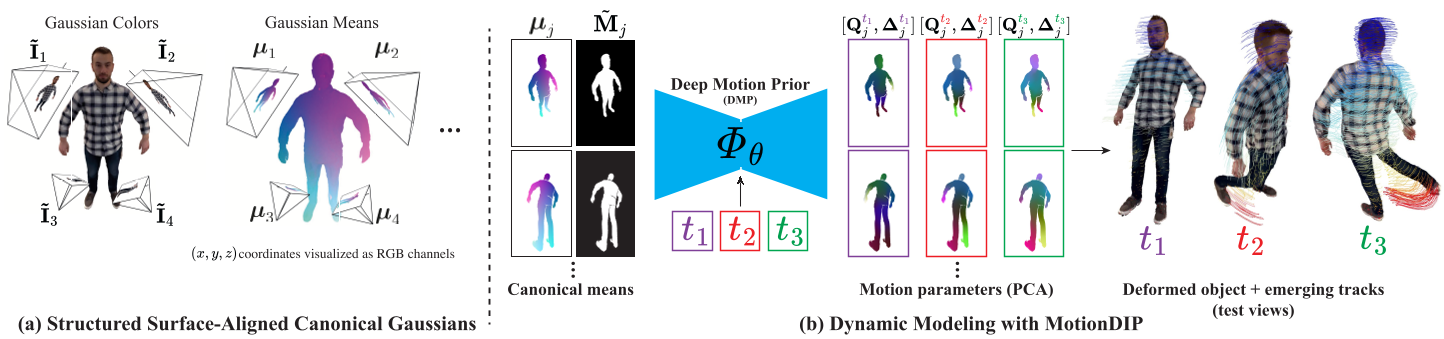 图 1:DRoPS 整体框架。左侧为结构化高斯构建,右侧为基于 CNN 的运动预测网络。
2.2 Deep Motion Prior (DMP)
这是本文最妙的一手。作者放弃了直接优化每个点的位移,而是训练一个 U-Net。
- 输入:参数化的 canonical 坐标网格。
- 输出:每一帧的 6-DOF 变形(旋转 + 位移)。
- 为什么有效?:CNN 天生具有空间归纳偏置(Spatial Inductive Bias)。因为卷积核在局部滑动,相邻像素的输出自然是相关的。这相当于给物体的运动自动加上了一层“局部平滑”和“相干性”滤镜,不需要手动写复杂的数学公式来约束运动。
3. 实验战绩:无惧极端视角
为了测试真实性能,作者在 Panoptic Studio 等数据集上进行了严苛测试。他们不仅看训练视角的还原度,更关注从物体背面、侧面等“极端视角”看过去模型是否崩坏。
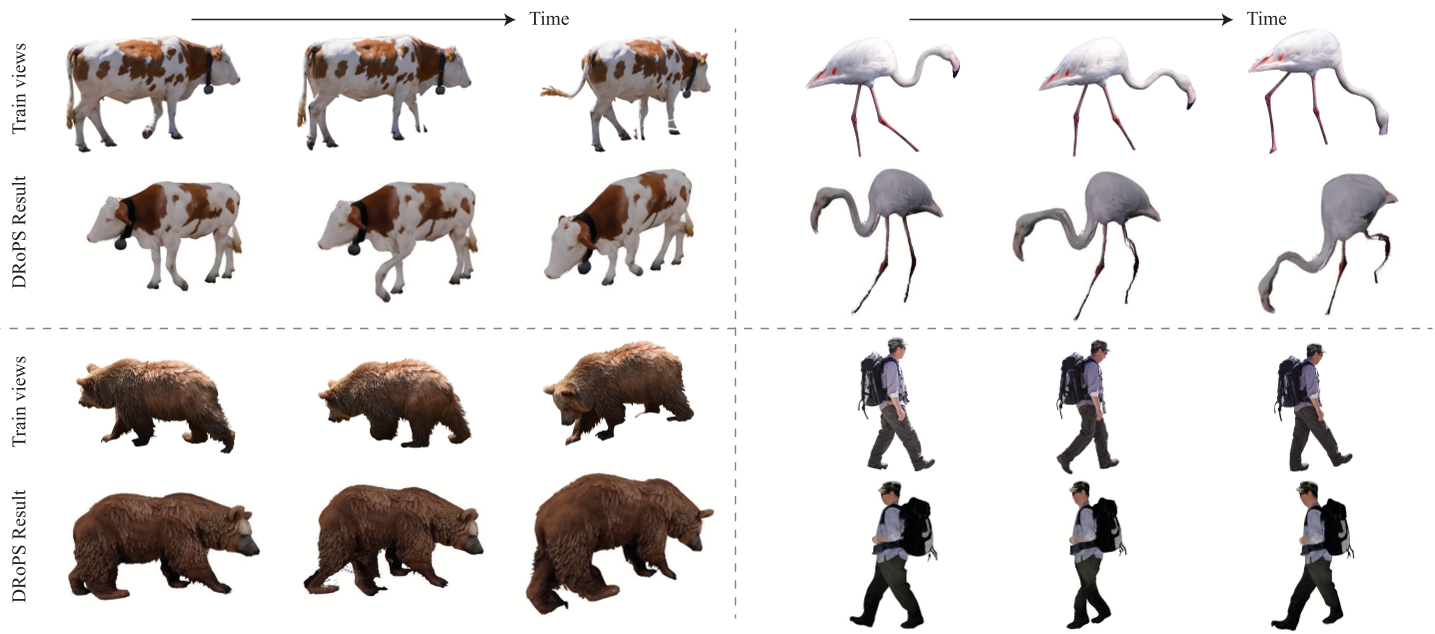 图 2:对比实验。可以看到 HiMoR 和 OriGS 在极端视角下出现了明显的几何扭曲或模糊,而 DRoPS 依然保持了锐利的边缘和准确的几何。
关键量化指标:
- 渲染质量:PSNR 相比基线提升了 1.0 dB 以上。
- 3D 追踪能力:在 TAP-Vid-3D 追踪任务中,DRoPS 的误差(EPE)大幅降低,展示了其对物理运动的精准建模。
4. 更多玩法:从 Text-to-Video 到 4D 重建
DRoPS 不仅仅能处理录好的视频。配合现在的生成式 AI(如 Trellis),我们可以:
- 用一张图生成静态 3D 模型(作为预扫描)。
- 用一段文字生成 2D 视频。
- 用 DRoPS 将两者结合,变成一个高质量的 4D 动画资产。
总结与洞察
DRoPS 的成功再次印证了学术界的一个趋势:结构化数据(Grids) + 深度学习偏置(CNN/Transformers) > 乱序点云 + 经验正则化。
尽管 DRoPS 目前主要针对单个前景物体,且对透明物体或拓扑改变(如爆米花炸开)处理乏力,但它为单目 4D 重建建立了一个极高性能的基准。对于 AR/VR 行业来说,这种“拍个照+拍段视频”就能获得高质量 3D 动画的技术,具有极高的落地潜力。