
EA-WM:重塑机器人世界模型的运动感知,让视频生成符合物理常识
EA-WM: Event-Aware Generative World Model with Structured Kinematic-to-Visual Action Fields
本文提出了 EA-WM,一种事件感知的生成式机器人世界模型。该模型通过创新的“结构化运动到视觉动作场”(KVAFs)将低维机器人控制信号映射到图像域,并结合事件感知双向融合机制,在 WorldArena 评测中显著提升了生成视频的物理保真度与几何准确性。
TL;DR
复旦大学与中关村人工智能研究院的研究团队推出了 EA-WM (Event-Aware Generative World Model)。通过将机器人的低维动作信号转换为结构化运动到视觉动作场 (KVAFs),该模型打破了数值控制与视觉感知之间的障碍。配合事件差分潜变量监督 (EDLS),EA-WM 不仅能画出逼真的视频,更能精准模拟机器人与物体之间的物理交互,在 WorldArena 榜单上刷新了 SOTA 记录。
核心痛点:为什么 AI 预测的机器人总是“穿模”?
在当前的机器人研究中,视频生成模型被视为构建“世界模型”的基石。然而,现有的模型(如 CogVideoX、Wan 系列)在根据动作预测未来画面时,常会出现机器人手臂变形、物体凭空位移或抓取动作不符合几何逻辑的问题。
本质原因在于:域不匹配 (Domain Misalignment)。 传统的做法是将动作(如 7 自由度的关节角度)由 MLP 编码为几个抽象的 Token 喂给 Transformer。对于模型而言,它很难将这几个数字与屏幕上成千上万个像素点的空间移动建立起物理联系。
核心创新点 1:KVAF —— 让动作“可视化”
EA-WM 的天才之处在于不再强迫模型去猜数字背后的含义,而是直接将动作画出来。
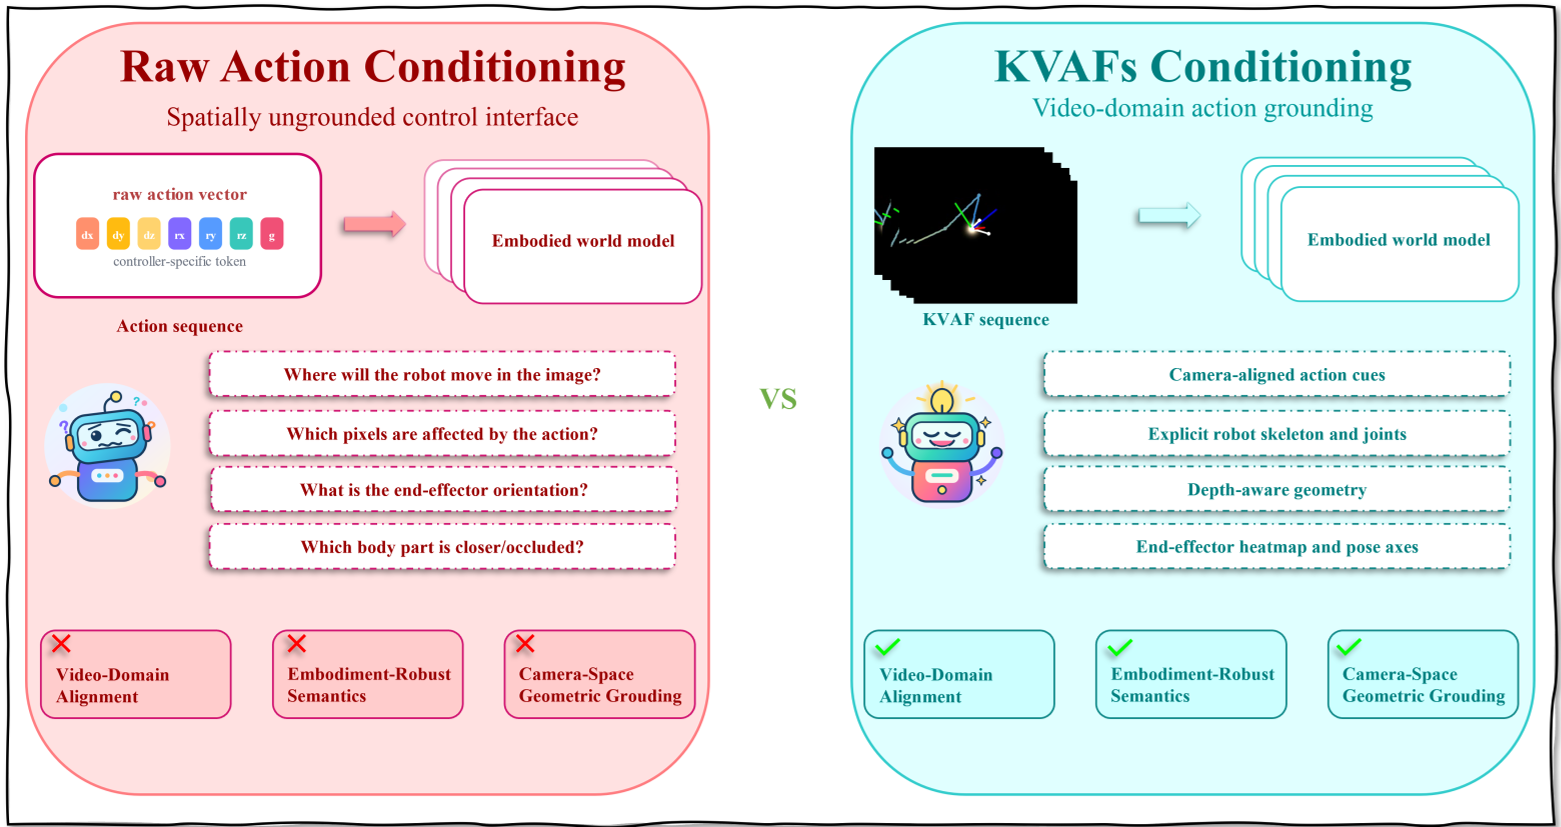
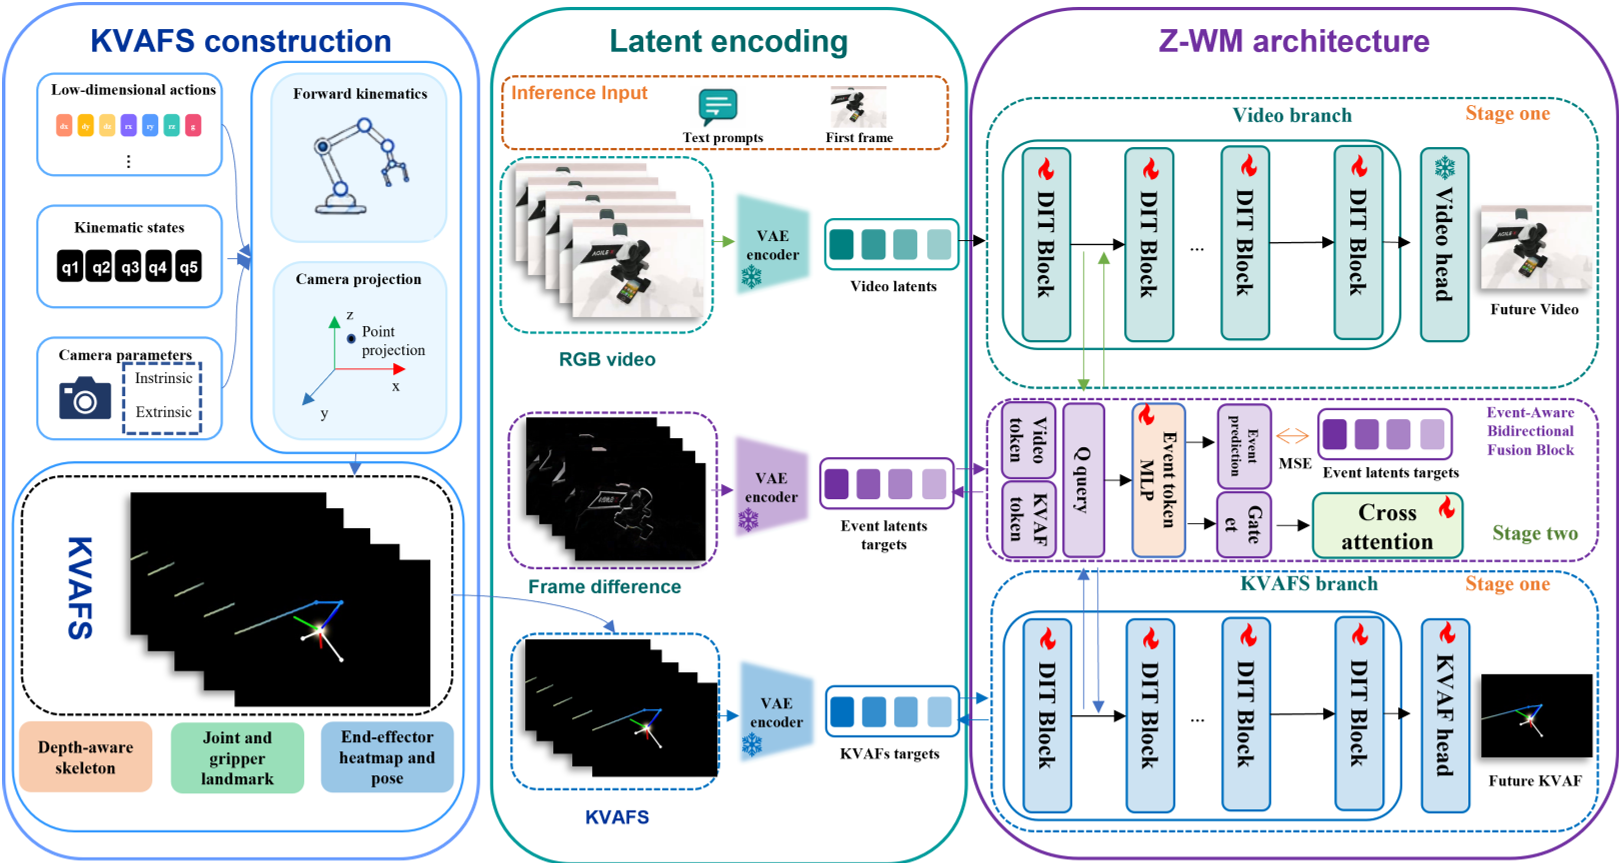
研究者通过结构化运动到视觉动作场 (KVAFs) 技术,利用机器人运动学(Forward Kinematics)和相机投影(Camera Projection),将关节状态转化为:
- 深度感知骨架:反映机械臂的空间拓扑。
- 末端执行器热图:明确操作焦点。
- 位姿轴 (Pose Axes):提供精确的旋转与进场方向。
这使得动作信号与生成的视频帧处于完全相同的图像域和潜空间中,从根本上降低了模型的学习难度。
核心创新点 2:EDLS —— 捕捉交互的“瞬间”
仅仅有动作表现是不够的,世界模型必须理解“碰撞”和“交互”。EA-WM 引入了事件差分潜变量监督 (EDLS)。
该机制通过计算连续帧之间的像素差分(Temporal Difference),并以此作为监督信号。这样做的逻辑直觉是:像素变化最剧烈的地方,通常就是机器人与物体发生交互的地方。通过这种方式,模型学会了动态分配注意力,重点关注抓取、放置等关键交互瞬间。
实验结果:全方位的 SOTA 表现
在最具权威性的机器人世界模型基准 WorldArena 上,EA-WM 在物理遵循、3D 准确性和可控性等维度均大幅领先。
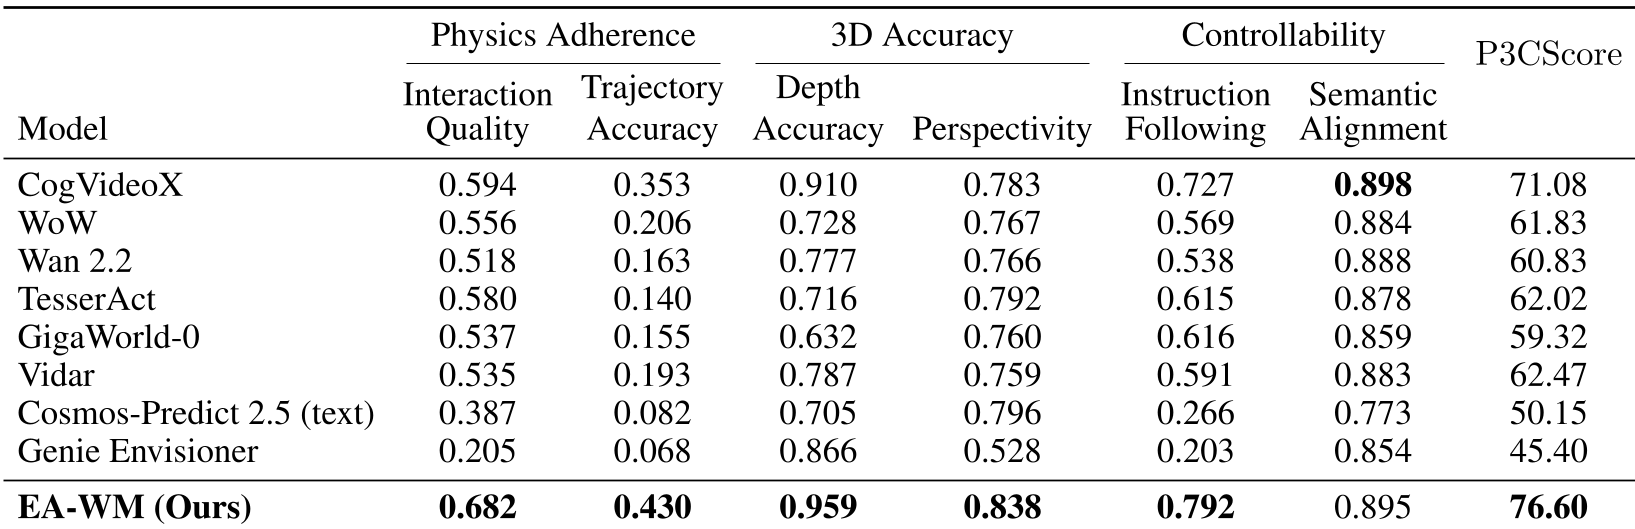
- P3CScore:达到 76.60,领先此前最强的 CogVideoX 近 8%。
- 物理相容性:交互质量得分提升至 0.682,有效解决了生成视频中常见的物体闪现和机械臂漂移问题。
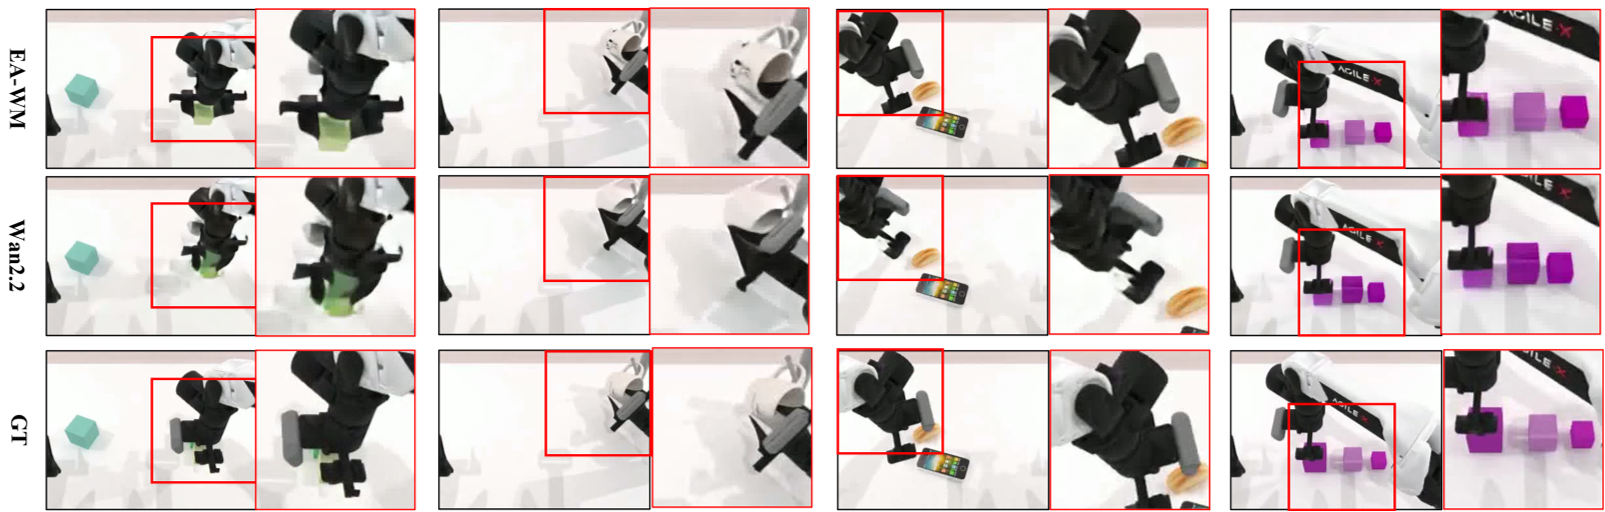
从定性结果来看(见下图),EA-WM 生成的夹爪与物体接触关系非常坚实,不仅保持了物体的几何特征,还完美对齐了任务指令。
总结与洞察:迈向更真实的模拟
EA-WM 的成功证明了:在具身智能任务中,显式的空间几何先验不仅重要,而且必须以模型易于消费的形式(如图像域 Action Field)存在。
局限性:尽管在模拟器中表现完美,但 KVAF 依赖于精确的相机标定和运动学日志。若在真实场景中存在传感器噪声或严重的视觉遮挡,其性能可能会受限。
未来展望:研究团队指出,下一步将探索如何将“物体侧”的几何信息也纳入 Action Fields,从而实现更精细的接触建模,或许这正是通往通用物理模拟器的关键钥匙。