
[Google DeepMind] 高效探索:实现 RLHF 1000 倍数据效率增益的炼金术
Efficient Exploration at Scale
本文由 Google DeepMind 团队提出,旨在通过在线学习与信息定向探索(Information-Directed Exploration)提升 RLHF 的数据效率。核心方法结合了认知神经网络(ENN)处理奖励不确定性与“肯定性微推”(Affirmative Nudge)机制,在 Gemma 模型上仅需不到 2 万条标签即可达到传统离线 RLHF 使用 20 万条标签的性能,实现 10 倍以上效率提升。
TL;DR
在 LLM 的后训练(Post-training)阶段,人类反馈(Human Feedback)是极其昂贵的资源。Google DeepMind 近期发布的论文 Efficient Exploration at Scale 给出了一份震撼的答卷:通过将 RLHF 从离线的“僵化模式”转变为带有主动探索能力的“在线模式”,研究者在 Gemma 9B 模型上实现了惊人的效率跨越。目前已达成 10 倍效率提升,未来预测可达 1000 倍。
背景定位:RLHF 正在进入“主动时代”
传统的 RLHF 路径通常是:采样数据 -> 标注回复 -> 离线训练 RM -> 强化学习。这种模式的本质缺陷在于样本分布的滞后性。当模型能力进化后,旧的标注数据往往无法提供新的挑战。
DeepMind 认为,RLHF 的核心应当是 Reinforcement Learning,而 RL 的精髓在于 Exploration(探索)。
核心痛点:为什么在线 RLHF 容易“崩塌”?
在尝试将 RLHF 转为在线实时更新时,研究者通常会遇到 Tanking(性能跳水) 现象。模型在学习了一段时间后,性能会突然下滑,无法像预训练那样平滑扩展。
此外,如何挑选“有意义”的反馈也是一个难题。如果给人类看两个质量差不多的回复,或者两个高下立判的回复,得到的信号(Reinforcement Signal)往往信息量极低(Informativeness)。
方法论详解:三位一体的效率引擎
1. 肯定性微推 (Affirmative Nudge) —— 解决崩塌的解药
为了防止在线学习中的不稳定性,作者在 Policy Gradient 的更新公式中加入了一个微小的标量 。
abla \ln \pi(Y|X) $$ 这个看似简单的项能够让模型在面对不确定的反馈时保持正向的梯度,极大地缓解了参数更新过程中的“剧烈震荡”,避免了 Tanking。 ### 2. 认知神经网络 (ENN) —— 建模“我知道我不知道” 作者并没有使用单一的奖励模型,而是构建了一个包含点估计(Point Estimate)头和 100 个 Ensemble 头的 **Epistemic Neural Network**。 - **原理**:利用多个微型 MLP 头(Prior and Differential Networks)的输出差异,来衡量模型对某对回复判断的“不确定性”。 ### 3. 信息定向探索 (Information-Directed Exploration) 这是本文的灵魂。在生成训练对时,系统会生成 16 个候选回复,然后利用 ENN 挑选出**判别方差最大**的那一对(Infomax Pair)提交给人类标注。 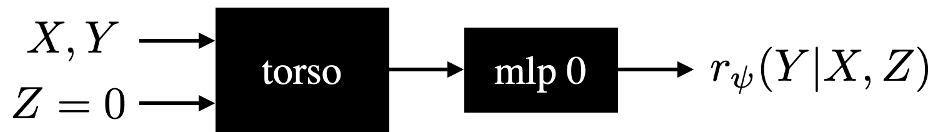 *图 1:ENN 架构,通过 100 个粒子的推理路径来评估不确定性* ## 实验与结果:重写 RLHF 的 Scaling Law 在对 Gemma 9B 的实验中,Information-Directed Exploration(IDE)的表现几乎是划时代的。 - **SOTA 对比**:如图 8 所示,IDE(图中紫线)的学习曲线远陡峭于传统的离线 RLHF(蓝线)。 - **效率跨越**:离线方法需要 200K 条数据才能达成的胜率,在线探索仅需 20K。 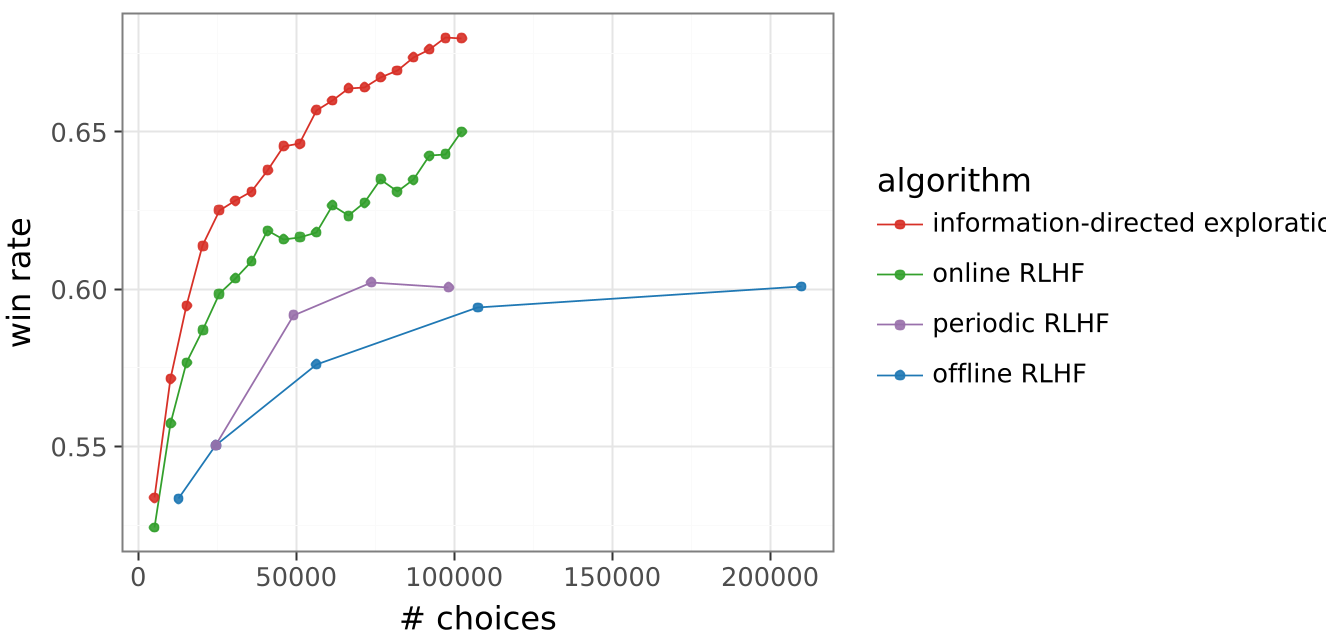 *图 2:不同算法下的胜率随人类反馈数量的变化曲线。IDE 展现了指数级的效率优势。* ### 定性分析:为什么高效? 作者展示了一个数学题的案例。离线模型给出的答案虽然看似有理有据,但逻辑混乱且结果错误;而经过高效探索对齐后的模型,能够给出更简洁、逻辑一致且完全正确的推导。这说明**主动探索能让模型更快地撞见并纠正那些微妙而关键的逻辑漏洞**。 ## 深度洞察与展望 这项工作向业界传达了一个强烈的信号:**数据质量(特别是互动产生的数据)远比数据数量重要**。 **局限性分析:** - **计算成本**:在线更新奖励模型和语言模型对推理与训练架构的吞吐量要求极高。 - **复杂性**:引入 ENN 和微推机制增加了超参数调优的难度。 **总结:** 随着大语言模型进入“超大规模对齐”阶段,单纯堆砌标注数据已不再可持续。DeepMind 的这项研究通过引入**认知不确定性**,将 RLHF 变成了一个真正的“因材施教”的过程。1000 倍的效率增量可能预示着,未来的超级对齐(Superalignment)只需极少量的精英化人类干预即可完成。