
FAN:突破离线 RL 的效率瓶颈,流策略与分布价值的高效融合
Towards Efficient and Expressive Offline RL via Flow-Anchored Noise-conditioned Q-Learning
本文提出了 Flow-Anchored Noise-conditioned Q-Learning (FAN),这是一种高效且表达力强的离线强化学习 (Offline RL) 算法。通过引入“流锚定 (Flow Anchoring)”机制和噪声条件评价器 (Noise-conditioned Critic),FAN 在保持生成模型和分布值函数优势的同时,显著提升了训练与推理效率,多项任务达到 SOTA 水平。
1. 核心速览 (Executive Summary)
TL;DR:针对离线强化学习(Offline RL)中表达力强的模型(如 Flow Matching 和 Distributional Critic)计算成本高昂的问题,本文提出了 FAN (Flow-Anchored Noise-conditioned Q-Learning)。该算法通过“流锚定”和“噪声条件评价器”,实现了仅需单次流迭代和单噪声样本的高效训练与推理。
背景定位:FAN 处于离线 RL 的 SOTA 位置,它成功地在“模型表达力”与“计算效率”这个长期存在的权衡中找到了新的最优解。它不仅在 D4RL 榜单上表现强劲,更在复杂的机器人操纵基准 OGBench 上展现了绝对的效率优势(训练提速 5-14 倍)。
2. 痛点与动机 (Problem & Motivation)
离线 RL 的核心在于 行为正则化 (Behavior Regularization),即让学到的策略不要偏离数据分布太远。
- 表达力之苦:为了拟合复杂的多峰分布,研究者引入了 Flow Matching 策略(由 ODE 驱动)和 Distributional Critics(建模完整的收益分布)。
- 效率之殇:但这带来了巨大的开销。生成一个动作可能需要 10-50 步的 ODE 积分,而评估价值则需要采样几十个分位数。这使得这些模型在实际部署时显得过于笨重。
作者的 Insight 是:我们是否真的需要通过解 ODE 才能完成正则化?我们是否可以通过将分布特征“压缩”到噪声输入中来简化价值函数的学习?
3. 方法论详解 (Methodology)
FAN 的核心设计包含两个关键支柱:
3.1 流锚定 (Flow Anchoring)
传统的流策略正则化(如 FQL)需要计算 (ODE 的终点),这涉及多次迭代。FAN 提出了一种 Flow Anchoring Loss: 这种方法将策略生成的动作 视为流路径中的一个“点”,利用速度场 进行约束,而无需解出完整的轨迹。理论证明(见 Theorem 4.3),这种方法是 Wasserstein-2 距离的有效上界。
3.2 噪声条件评价器 (Noise-conditioned Critic)
FAN 引入了一个算子 ,它将噪声向量 直接注入到 Q 函数中,定义了如下目标: 通过 上期望回归 (Upper Expectile Regression, ),FAN 能够以单样本的成本捕捉到回报分布的最优特征(即本性上确界)。
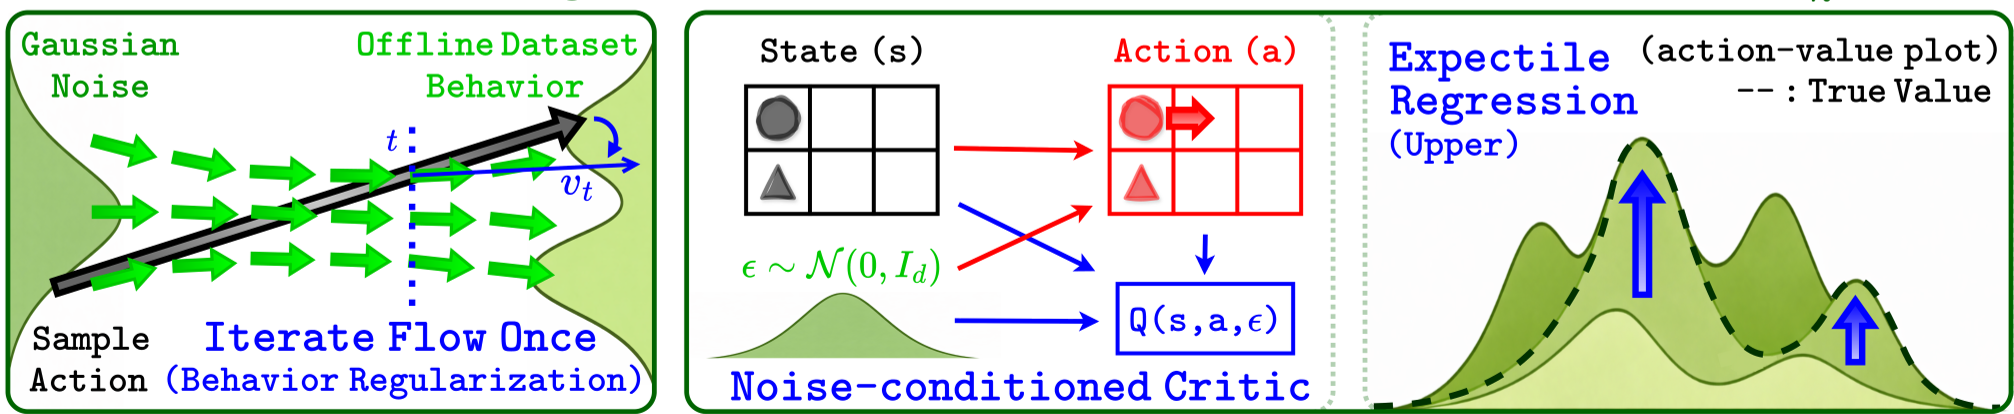 图 2:FAN 架构概览。左侧展示了流锚定机制,中间展示了噪声条件评价器,右侧为上期望回归。
4. 实验与结果 (Experiments & Results)
4.1 性能与效率的“双赢”
实验涵盖了 D4RL 和 OGBench。最令人印象深刻的是图 1 的对比:
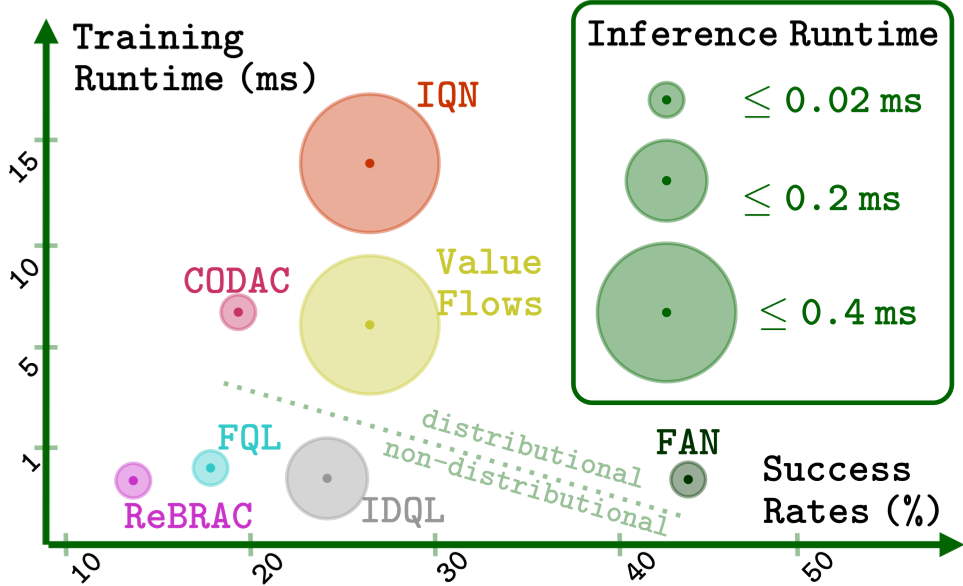 图 1:在 OGBench 任务中,FAN 在保持最高成功率的同时,训练时间(每批次耗时)显著低于其他分布 RL 方法(如 Value Flows 和 CODAC)。
4.2 训练细节与消融分析
- 推理速度:FAN 的推理 FLOPs 比基于拒绝采样的 IDQL 低了几个数量级,因为它是一次前向生成的。
- 消融实验:Figure 4 证明了 算子和 Flow Anchoring 缺一不可。只使用其中之一都会导致在复杂任务(如 Puzzle 4x4)上的性能大幅下滑。
5. 深度洞察与总结 (Critical Analysis & Conclusion)
总结 (Takeaway): FAN 证明了离线 RL 的高性能并不一定要以计算爆炸为代价。通过在算子层面进行数学优化(利用噪声模拟分布),以及在正则化层面进行直觉修补(利用速度场而非轨迹),离线 RL 算法可以既快又强。
局限性与展望: 虽然 FAN 在单任务上表现优异,但在需要极端多任务泛化或长程规划的场景下,其简化的单步流是否足够稳定仍需验证。未来的方向可能包括将 Flow Anchoring 引入到在线 RL 中,或者探索其在多模态视觉策略中的应用潜力。
结论:如果您正在寻找一种能够在机器人硬件上实时运行,且能处理复杂行为分布的离线 RL 算法,FAN 无疑是当前的最佳选择之一。