
累积量传播:解析估计如何击败 Monte Carlo 采样?
Estimating the expected output of wide random MLPs more efficiently than sampling
本文提出了一种用于估计宽随机多层感知机(MLP)期望输出的解析方法:累积量传播(Cumulant Propagation)。该方法利用累积量和 Hermite 展开构建激活分布的近似表达,在 MSE 指标上首次在理论和实验中同时超越了传统的 Monte Carlo 采样。
TL;DR
在机器学习领域,Monte Carlo (MC) 采样被视为估计期望值的“金标准”。但本文提出了一种基于累积量传播 (Cumulant Propagation) 的解析方法,证明了对于宽随机 MLP,我们完全不需要通过运行样本来估计输出。该方法不仅在理论上实现了比采样更优的计算复杂度,且在处理**罕见事件(Rare Events)**时的表现远超传统方法,为 AI 安全领域中的尾部风险控制提供了新工具。
背景定位:采样是唯一的出路吗?
长期以来,神经网络被视为“黑盒”,其非线性特征使得解析积分变得异常困难。大部分研究者选择通过增加采样量 来降低误差(误差以 下降)。本文作者则从统计物理中汲取灵感,认为如果能解析地追踪激活分布的形状(即累积量),就能跨越采样的统计噪声直接计算期望。
痛点深挖
- 二阶限制:早期的工作(如 Wright 等人的协方差传播)只能处理高斯近似,忽略了深度网络中必然出现的偏斜(Skewness)和峰度(Kurtosis)。
- 计算爆炸:高阶张量的运算开销巨大,通常随着维度 指数增长。
- 罕见事件失效:在预测概率极低(如 )的灾难性事件时,MC 采样需要天文数字级的样本量才能捕捉到一个有效数据点。
核心机制:图求和公式与 Hermite 展开
作者的核心 Insight 是将激活函数通过 Hermite 展开转化为多项式基底,并开发了一套图求和公式 (Diagram Summation Formula)。
1. 模型架构图
该算法通过网络层层推进,在每一层动态更新累积量:
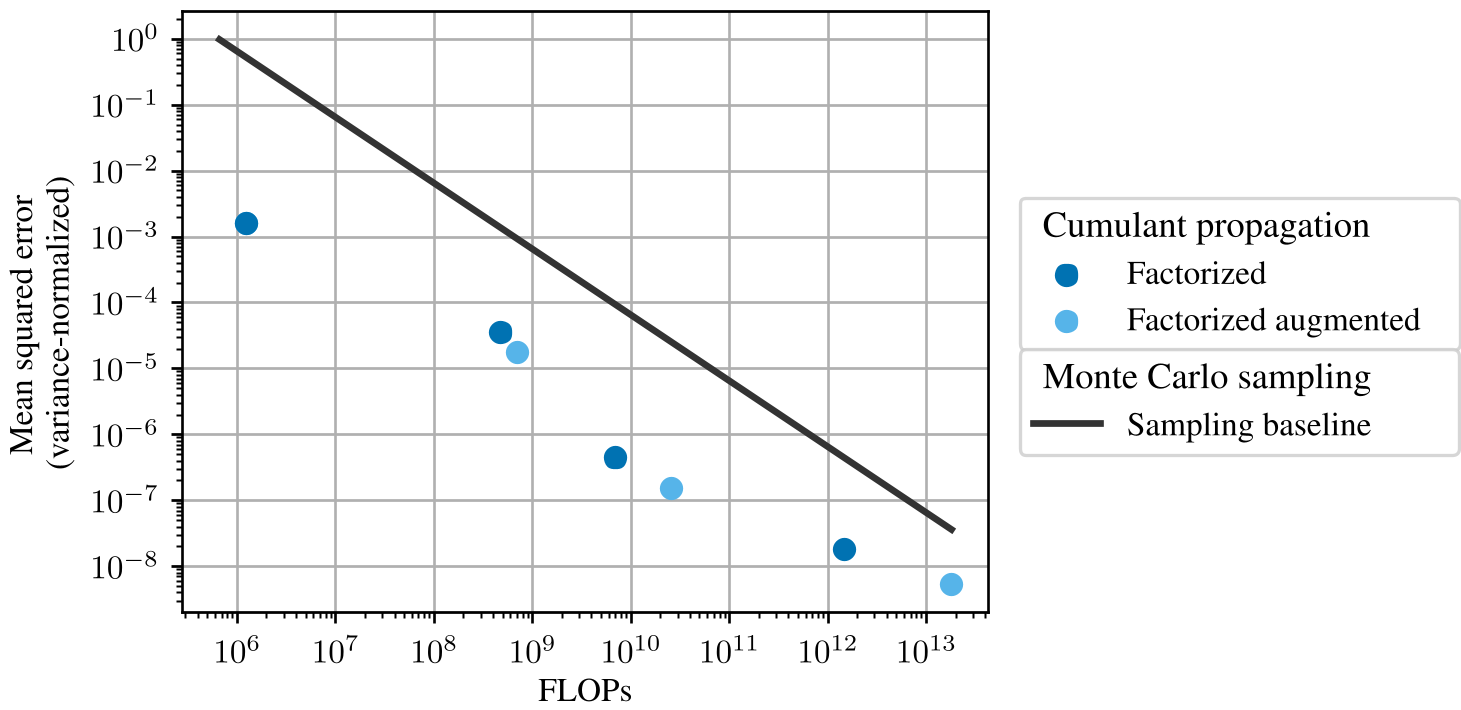 算法通过追踪激活值的统计特征而非具体样本点,实现了从输入分布到输出期望的“跨空跳跃”。
2. 数学直觉:为什么有效?
累积量 衡量了分布偏离高斯分布的程度。作者发现,在宽网络极限下,高阶累积量的量级随宽度增加而衰减()。这意味着,我们只需要追踪最关键的前几个累积量(如 ),就能以极小的开销获得极高的精度。
为了解决计算开销,作者引入了因子化算法 (Factorized Algorithm)。通过将 阶张量表示为更低维度的因子乘积,成功将单步复杂度从 降低到了 。
实验战绩
在 ReLU 网络上的对比表明,累积量传播在各种宽度和深度下均表现出极强的竞争力。
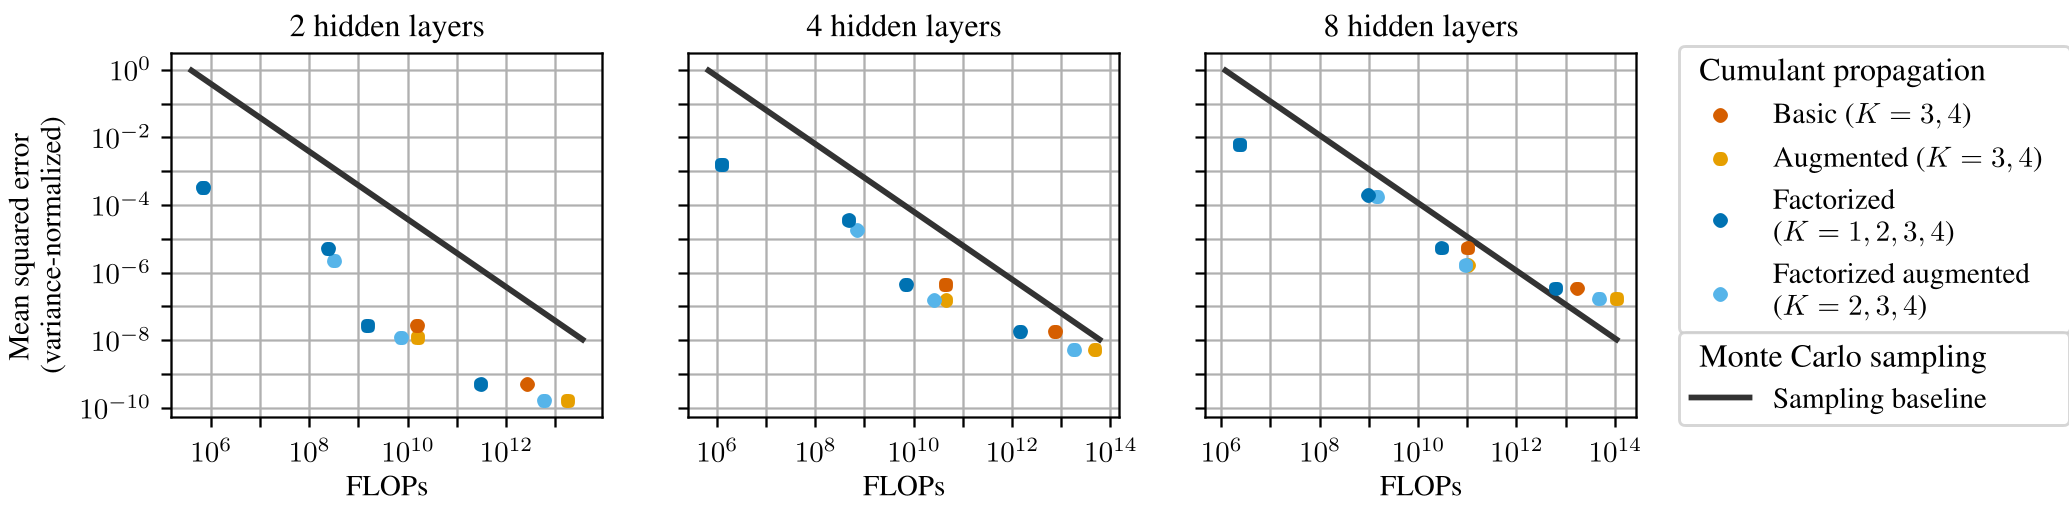 如图所示,在 4 层隐藏层、宽度 256 的设置下,因子化版本的算法(蓝色/粉色线)在相同 FLOPs 预算下,MSE 显著低于采样基线(黑色虚线)。
深度洞察:迈向“机械式训练”
本文最具影响力的启发在于其对 AI 安全的贡献。在传统的随机梯度下降(SGD)中,如果某个致命错误的触发概率极低,模型在训练期可能从未感知过该风险。而通过累积量传播,我们可以解析地计算出这些罕见负面事件的概率分布并直接进行优化(即机械式训练/Mechanistic Training)。这就像是在未见火灾前,就凭借物理机制计算出火灾风险并加固建筑,而非等待被烧后才学习。
局限性与展望
- 深度依赖:目前方法在极深网络中(如 )累积误差增长较快,优于采样的门槛越高。
- 结构化权重:目前的理论主要基于随机权重。如何处理经过梯度下降训练后具有高度结构化的权重,是下一步的研究难点。
总结:本文不仅是数学上的胜利,更是对“神经网络不可解释”这一偏见的有力反击,展示了从底层统计机制解析理解 AI 系统的无限可能。