
Token Superposition:将 LLM 预训练速度飙升 2.5 倍的“叠加态”魔法
Efficient Pre-Training with Token Superposition
本文提出了 Token-Superposition Training (TST),一种显著提升大语言模型预训练吞吐量的即插即用方法。通过在预训练初期将多个连续 Token 叠加为一个“袋(Bag)”并使用多热交叉熵(MCE)损失进行高效训练,TST 在 10B 规模模型上实现了 2.5 倍的训练加速。
TL;DR
大模型预训练昂贵的核心原因之一是“逐词消费”太慢。Nous Research 推出的 Token-Superposition Training (TST) 彻底打破了这一桎梏。它在不改变模型架构、不增加参数、不修改 Tokenizer 的前提下,通过将 Token “叠加”训练,在 10B 规模模型上实现了高达 2.5 倍 的预训练加速,且下游任务表现更优。
痛点深挖:为什么我们不能“一目十行”地训练?
传统的自回归(AR)训练要求模型在每一个位置只预测下一个 Token。这种方法虽然精确,但在超大规模数据面前显得极其低效。
- 计算浪费:模型每处理一个 Token 都要经过完整的 Transformer Block 复用,计算成本随序列长度线性增长。
- 效率瓶颈:现有的辅助损失函数(如 Multi-Token Prediction)虽然能提供更多信号,但往往增加了参数量,且在小模型上甚至会损害性能。
- 架构局限:许多优化方法修改了推理架构,导致训练好的模型无法作为通用基座直接平替。
核心直觉:Embedding 空间的“统计量”叠加
作者提出了一个大胆的设想:在训练初期,模型是否可以先学习文本的“粗略统计特征”,而不需要精确到每个词的顺序?
TST 将其分为两个阶段:
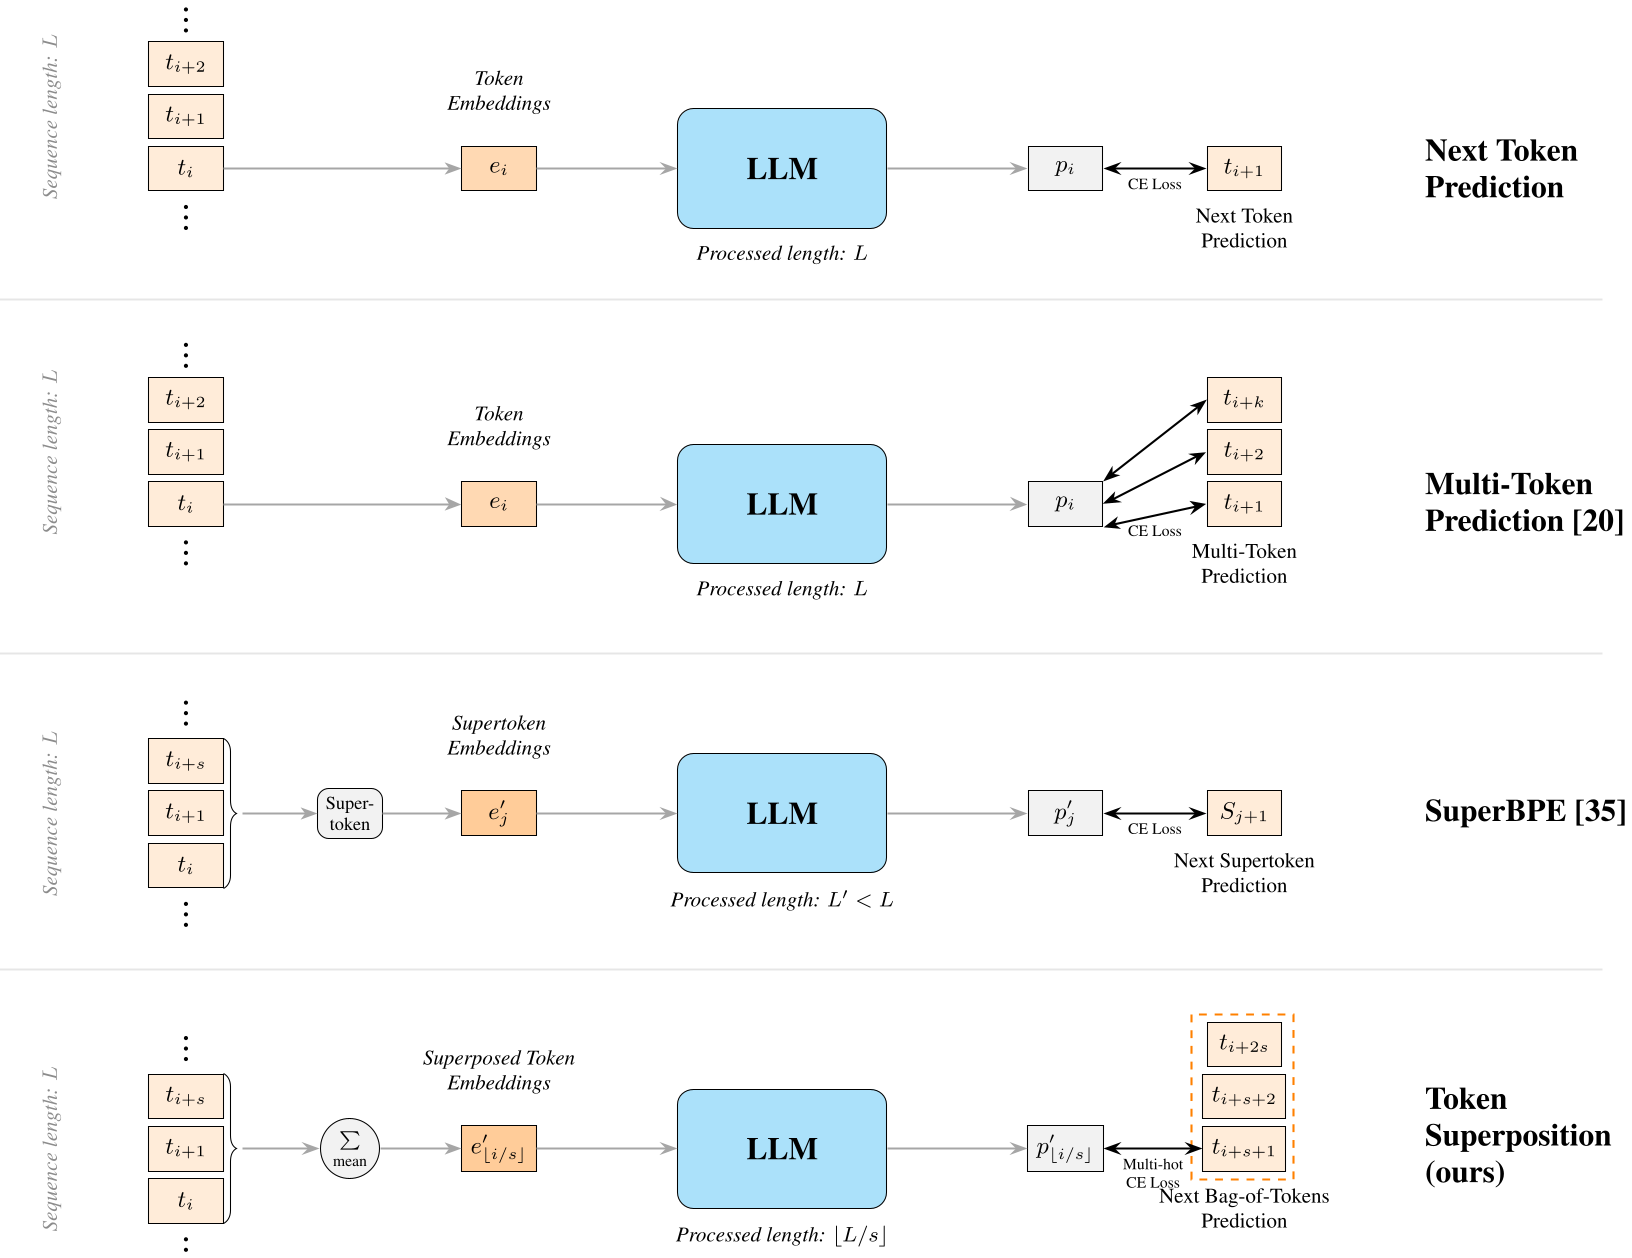
- 叠加阶段 (Superposition):模型将连续的 个 Token 的 Embedding 取平均作为输入(s-token),并尝试预测下一个包含 个词的“包”(Bag-of-tokens)。此时,模型单步 ingest 的数据量提升了 倍。
- 恢复阶段 (Recovery):在训练的中期或后期,切回标准的单 Token 预测。
关键技术点:Multi-hot Cross-Entropy (MCE)
为了配合输出端的“包预测”,作者改造了传统的交叉熵损失。MCE 赋予包内所有 Token 均等的概率目标(1/s)。这种半因果(Semi-causal)的设定让模型在相同的 FLOPs 预算下,接触到了远比基线更多的数据。
实验与结果:全方位的降维打击
实验覆盖了从 270M 到 10B 参数的模型。最令人振奋的结果出现在 10B 参数的 MoE 模型上:
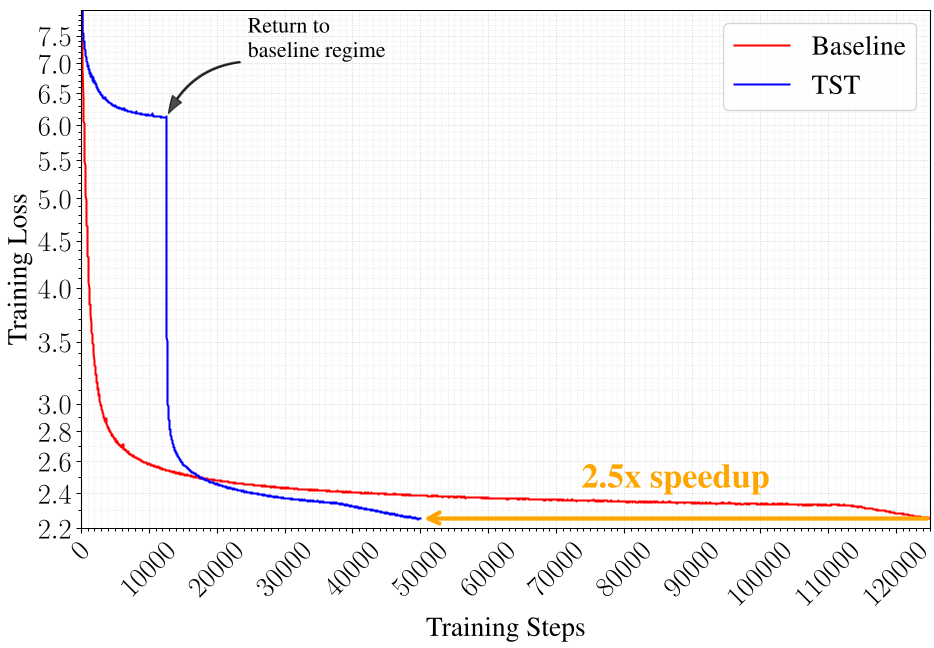
- 加速效率:在达到相同训练 Loss 的前提下,TST 仅需基线 40% 的计算时间(加速 2.5x)。
- 性能飞跃:即便经过了早期的“模糊训练”,在恢复阶段后的模型在 HellaSwag、ARC 等常识推理任务上表现甚至超过了标准训练的基线。
深度洞察:为什么这竟然有效?
通常我们认为,破坏了 Token 的时序信息会导致模型性能下降。但 TST 成功的关键在于:
- Inductive Bias 的平滑过渡:叠加阶段就像一种“预训练的预训练”,让模型先掌握语义共现和词群分布,这比直接从头学习精确序列更简单。
- 表示对齐的鲁棒性:作者发现,如果随机初始化 Embedding 或输出头,TST 的优势会立即消失(见表 2)。这说明 TST 的成功高度依赖于两阶段之间 Embedding 几何结构 的连续性。
- 正则化效应:在 Embedding 空间做加法迫使模型学习更具线性可分性的特征表示。
局限性与展望
尽管 TST 表现惊人,但它也有其局限:
- 数据消耗:由于在叠加阶段 ingest 了更多 Token,它本质上是用“数据通量”换“训练时间”。在数据极其匮乏的领域,这一优势可能减弱。
- 超参数敏感:Bag 大小 与切换比例 需要精细调优(目前推荐 ,)。
总结
TST 为我们提供了一个全新的视角:训练高效性不必以牺牲推理一致性为代价。这种“先看轮廓,再抠细节”的训练哲学,或许是大模型通往“高效预训练”的下一张门票。
本文由资深学术主编重构。更多详情请参考原文:Efficient Pre-Training with Token Superposition (Nous Research).