
EMO:让混合专家模型告别“臃肿”,开启涌现模块化新纪元
EMO: Pretraining Mixture of Experts for Emergent Modularity
本文提出了 EMO,一种旨在诱导“涌现模块化”的混合专家模型(MoE)。通过在预训练期间引入文档级专家池限制(Document-level Expert Pooling),EMO 实现了领域能力的自动解耦,使得模型可以根据需求仅激活部分专家子集(如 12.5%)而不损失显著性能。
TL;DR
传统的 Mixture-of-Experts (MoE) 模型虽然号称“稀疏”,但其专家通常只负责处理零散的语法模式,导致部署时必须“打包带走”所有权重。UC Berkeley 和 Allen AI 提出的 EMO 改变了这一现状:通过在预训练中加入 文档级专家限制,EMO 成功让模型在不牺牲总性能的前提下,自发形成了按语义领域(如法律、医疗、编程)划分的专家集群。这意味着,未来你可以根据需要,只下载并运行原始模型 12.5% 的专家,就能获得接近 100% 的性能。
痛点深挖:为什么 MoE 总是“大而无当”?
在现有的 MoE 架构(如 Mixtral 或 DeepSeek)中,路由器的决策是 Token 级别的。这产生了一个尴尬的现象:哪怕你只是让它写一段简单的 Python 代码,它在每一层仍然可能调用不同的专家来处理“if”、“: ”或缩进。这些专家学习到的是低级的词法特征(Syntactic Patterns),而非高级的领域知识(Domain Knowledge)。
因此,当你想精简模型时,无论剪掉哪一个专家,都会导致模型在某种基本语法上出现“残疾”。这就造成了 MoE 在内存受限场景下的部署难题。
Methodology:EMO 的灵光一现 —— 文档即边界
EMO 的核心思想返璞归真:既然同一个文档通常属于同一个领域,那么同一文档里的 Token 为什么不能共用一波专家?
核心机制:文档级专家池 (Document Expert Pool)
- 全局扫描:首先计算文档内所有 Token 对专家的平均偏好。
- 构建池子:为该文档选出前 个最受欢迎的专家,组成“临时专家池”。
- 强制路由:文档内的每个 Token 必须从这个大小为 的池子中选择最终激活的 个专家。
这种约束迫使路由器在训练时寻找具有“语义共性”的专家组合。随着 1 万亿 Token 的洗礼,这种结构演变成了涌现模块化 (Emergent Modularity)。
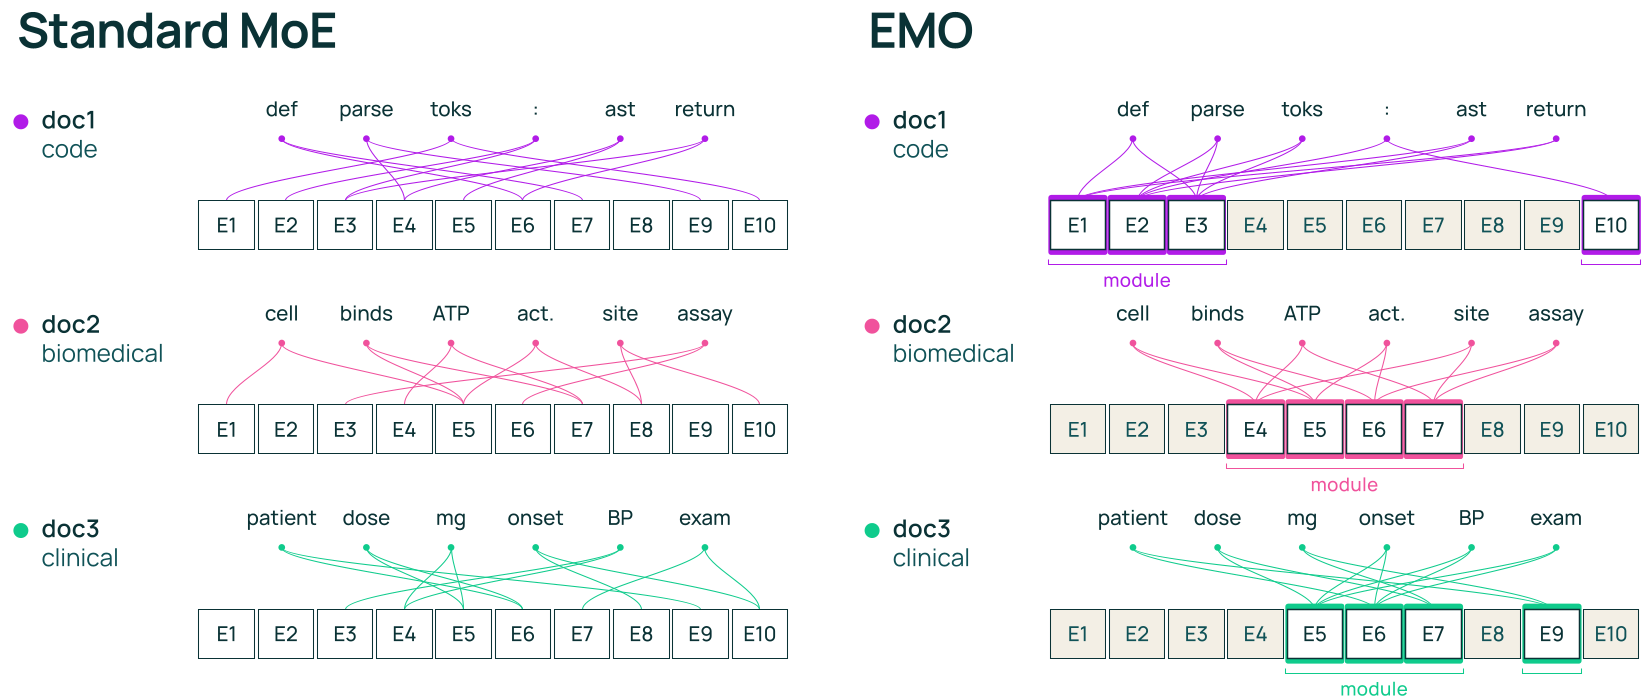 图 1:EMO 强制 Token 在文档级子池中进行路由,促进了专家间的领域化分工。
实验与结果:小即是美
研究团队训练了一个 14B 总参数(1B 激活)的 EMO 模型。结果显示,EMO 在作为全模型使用时,性能与精心调优的标准 MoE 完全一致。但真正的杀手锏在于选择性专家调用 (Selective Expert Use)。
性能不减,内存减负
- 极致压缩:在 MMLU 各项测试中,仅保留 25% 的专家,EMO 的得分几乎没有波动;即便只剩 12.5% 的专家,性能下降也控制在 3% 以内。
- 超越从头训练:对比那些专门针对小显存设计的“原生小模型”,EMO 提取出的子集在同等参数量下表现更优,这表明在大参数空间下进行模块化预训练具有显著的归纳偏置优势。
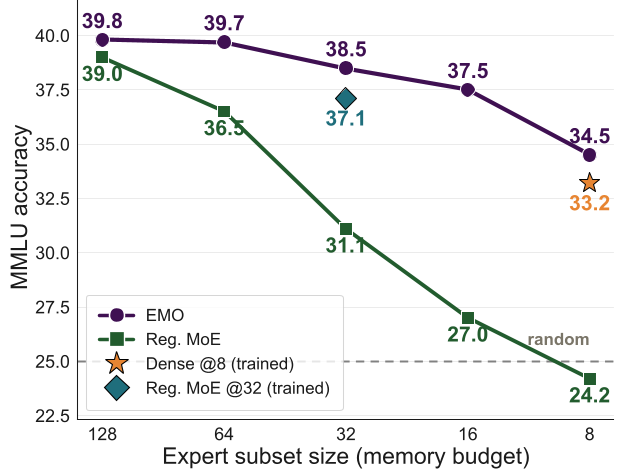 图 2:EMO 的专家子集(紫色)在内存-准确度曲线上显著优于标准 MoE 和从头训练的基线。
语义洞察:专家们到底学到了什么?
通过对预训练数据的 Token 聚类分析,作者发现了惊人的质变。
- 标准 MoE:聚类结果显示的是“介词”、“代词”、“句号”等语法类。
- EMO:聚类结果清晰地显示为“新闻报道”、“影视评论”、“美国政治”、“医学健康”。
这意味着 EMO 真正理解了知识的边界。当你向它提问医学问题时,它会非常专注地激活那几个特定的“医学博士专家”,其他“政治专家”或“娱乐专家”则可以安心休眠。
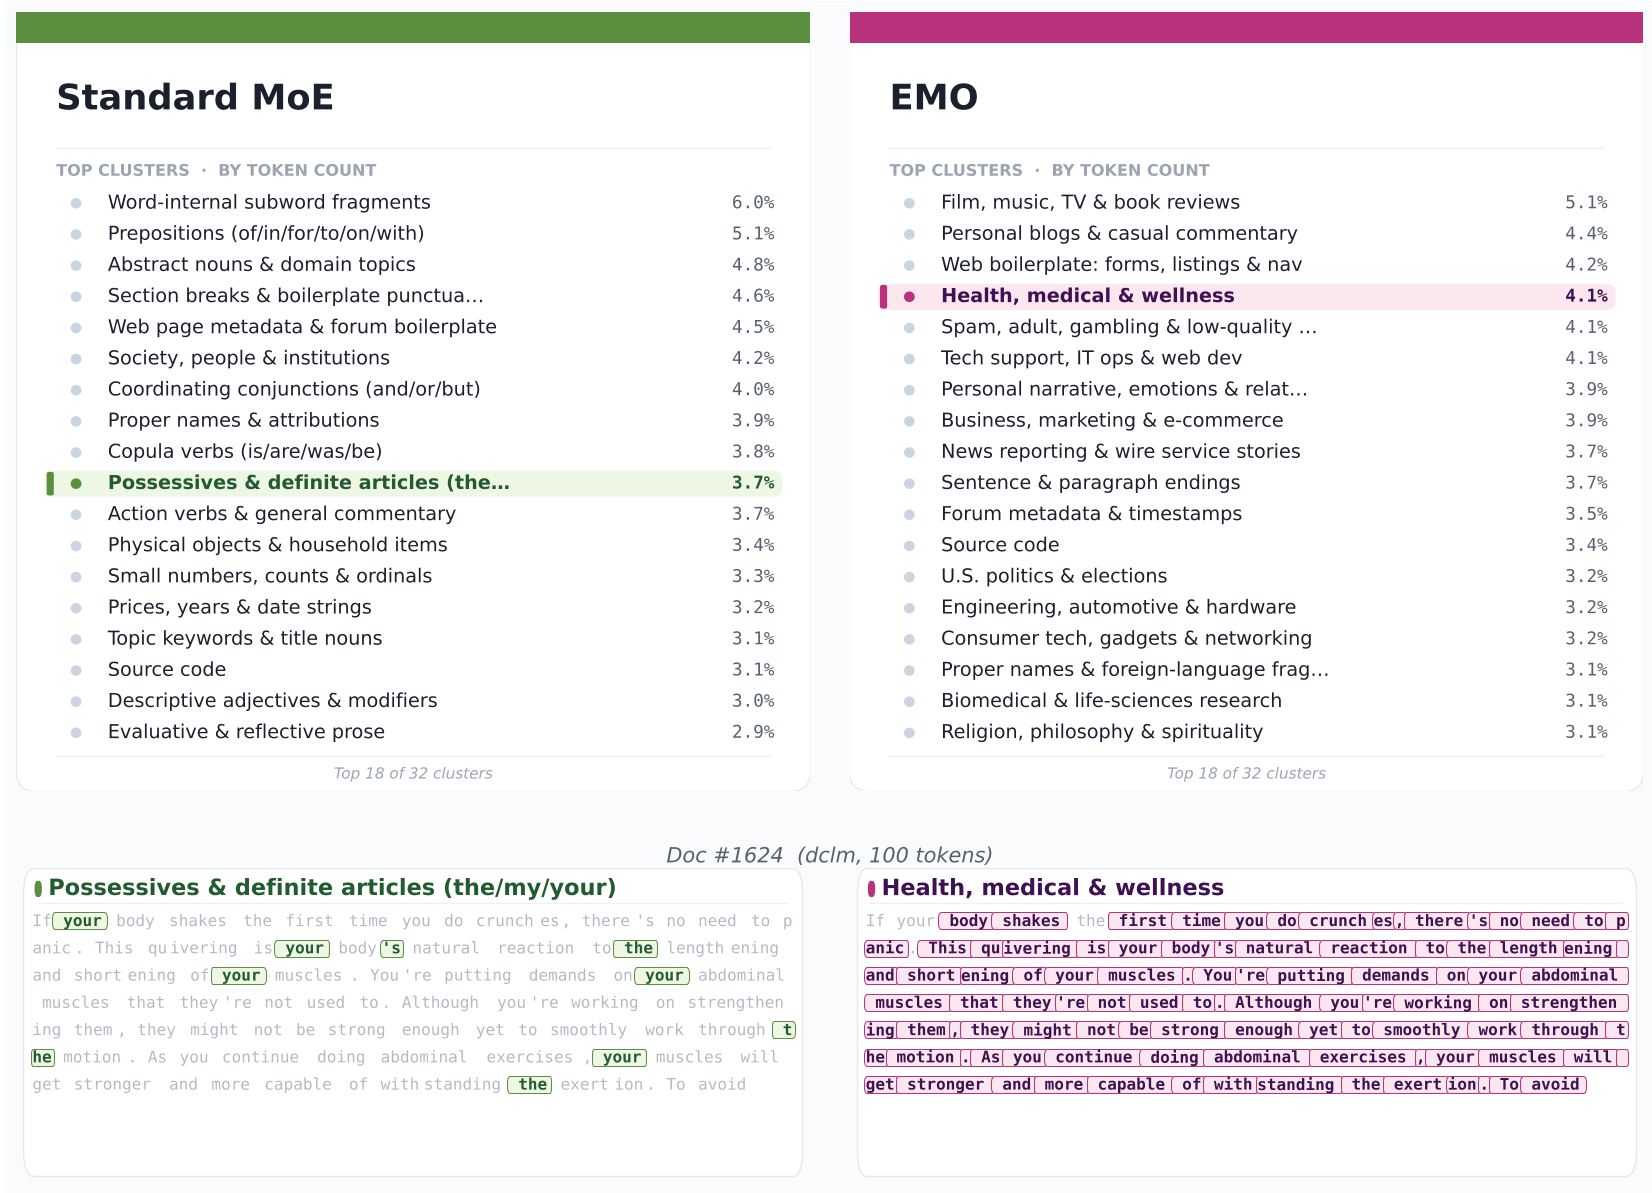 图 3:EMO 的专家聚类与人类定义的语意领域高度吻合。
深度洞察:模块化意味着什么?
EMO 的出现为 LLM 的未来提供了几个充满想象力的方向:
- 按需取用 (Model-on-Demand):未来的手机端助手可能只需要下载基础底座 + 你常用的“个人偏好专家包”,极大节省 VRAM。
- 安全围栏:如果发现模型产生了非法或有害内容,我们可以直接定位并“关闭”对应的风险专家模块,而无需重新训练整个模型。
- 增量更新:如果代码领域有了新的库或语法,我们是否可以只训练针对该领域的专家并“无缝插入”现有的 EMO 体系?
总结与局限
EMO 证明了模块化不一定需要人为预定义的领域标签,它可以从数据边界中自发涌现。
局限性:虽然 EMO 在特定领域任务(Selective Use)上表现强劲,但在处理极其泛化的混合任务时(即所谓的“Other”类任务),其表现会略逊于同等规模从头训练的模型。这提示我们,通用性与模块化之间仍存在细微的权衡。
无论如何,EMO 为构建更灵活、更透明、更高效的 AI 系统指明了一条清晰的道路。