
Aspen:强化学习赋能 LLM 突破小分子药物设计瓶颈
Evaluating the Progression of Large Language Model Capabilities for Small-Molecule Drug Design
本文推出了面向小分子药物设计的化学语言模型 Aspen,通过将分子属性预测、表征转换和多限制分子生成等任务表述为强化学习(RL)环境,对 Qwen-30B 进行了针对性后训练。实验证明,Aspen 在药物发现相关的复杂化学任务上达到了与 GPT-5、Claude Opus 4.6 等顶级闭源模型相当的水平。
TL;DR
传统的药物设计依赖于昂贵的实验和零散的计算工具,本文提出的 Aspen 模型证明:通过精心设计的强化学习(RL)后训练,一个 30B 参数规模的开源模型可以进化为顶级的“AI 药物化学专家”。Aspen 不仅在分子属性预测上突飞猛进,更在模拟的先导化合物优化(Lead Optimization)任务中展现了与 GPT-5 颉颃的实力。
背景定位:从“通用助手”到“化学专家”
尽管 GPT-4 和 Claude 3 在通用任务上表现优异,但在药物研发领域,它们常被称为“偏科生”。它们能写优美的科普文,却在计算分子的氢键受体数量或理解复杂的 IUPAC 命名时频频翻车。Genentech 团队的研究表明,这种能力缺失并非不可逾越,关键在于如何通过 Post-training 激发出模型内部的化学直觉。
痛点深挖:为什么 LLM 做不好化学?
- 表征理解障碍:SMILES 这种线性字符串对模型来说就像“乱码”,微小的语法变化可能代表完全不同的空间结构。
- 物理规律缺失:模型往往在“数原子”这种基础任务上表现良好(如分子量预测),但在涉及分子连通性、芳香性或质子化状态等深层逻辑时,R² 甚至为负。
- 评估环境脱节:现有的 Benchmark 大多是简单的分类预测,缺乏模拟真实药物化学家工作流的“多轮优化”场景。
核心方法:基于 GRPO 的化学能力“精炼”
作者并没有采用昂贵的预训练方案,而是利用了 GRPO (Group Relative Policy Optimization) 算法的变体。这种方法不需要额外的奖励模型(Reward Model),通过在同一 Prompt 下生成多个样本并进行组内对比(Advantage),极大地简化了训练流程。
奖励函数的设计艺术
为了解决 RL 中极稀疏的奖励信号问题,Aspen 引入了密集奖励(Dense Rewards):
- 指数 MSE 奖励:用于属性预测,给小误差提供更敏锐的正反馈。
- 子结构相似度:在表征转换任务中,即使模型写错了一个字符,只要生成的分子结构与目标相似,仍能获得部分奖励。
- 约束满足率:在分子生成中根据满足要求的数量线性打分。
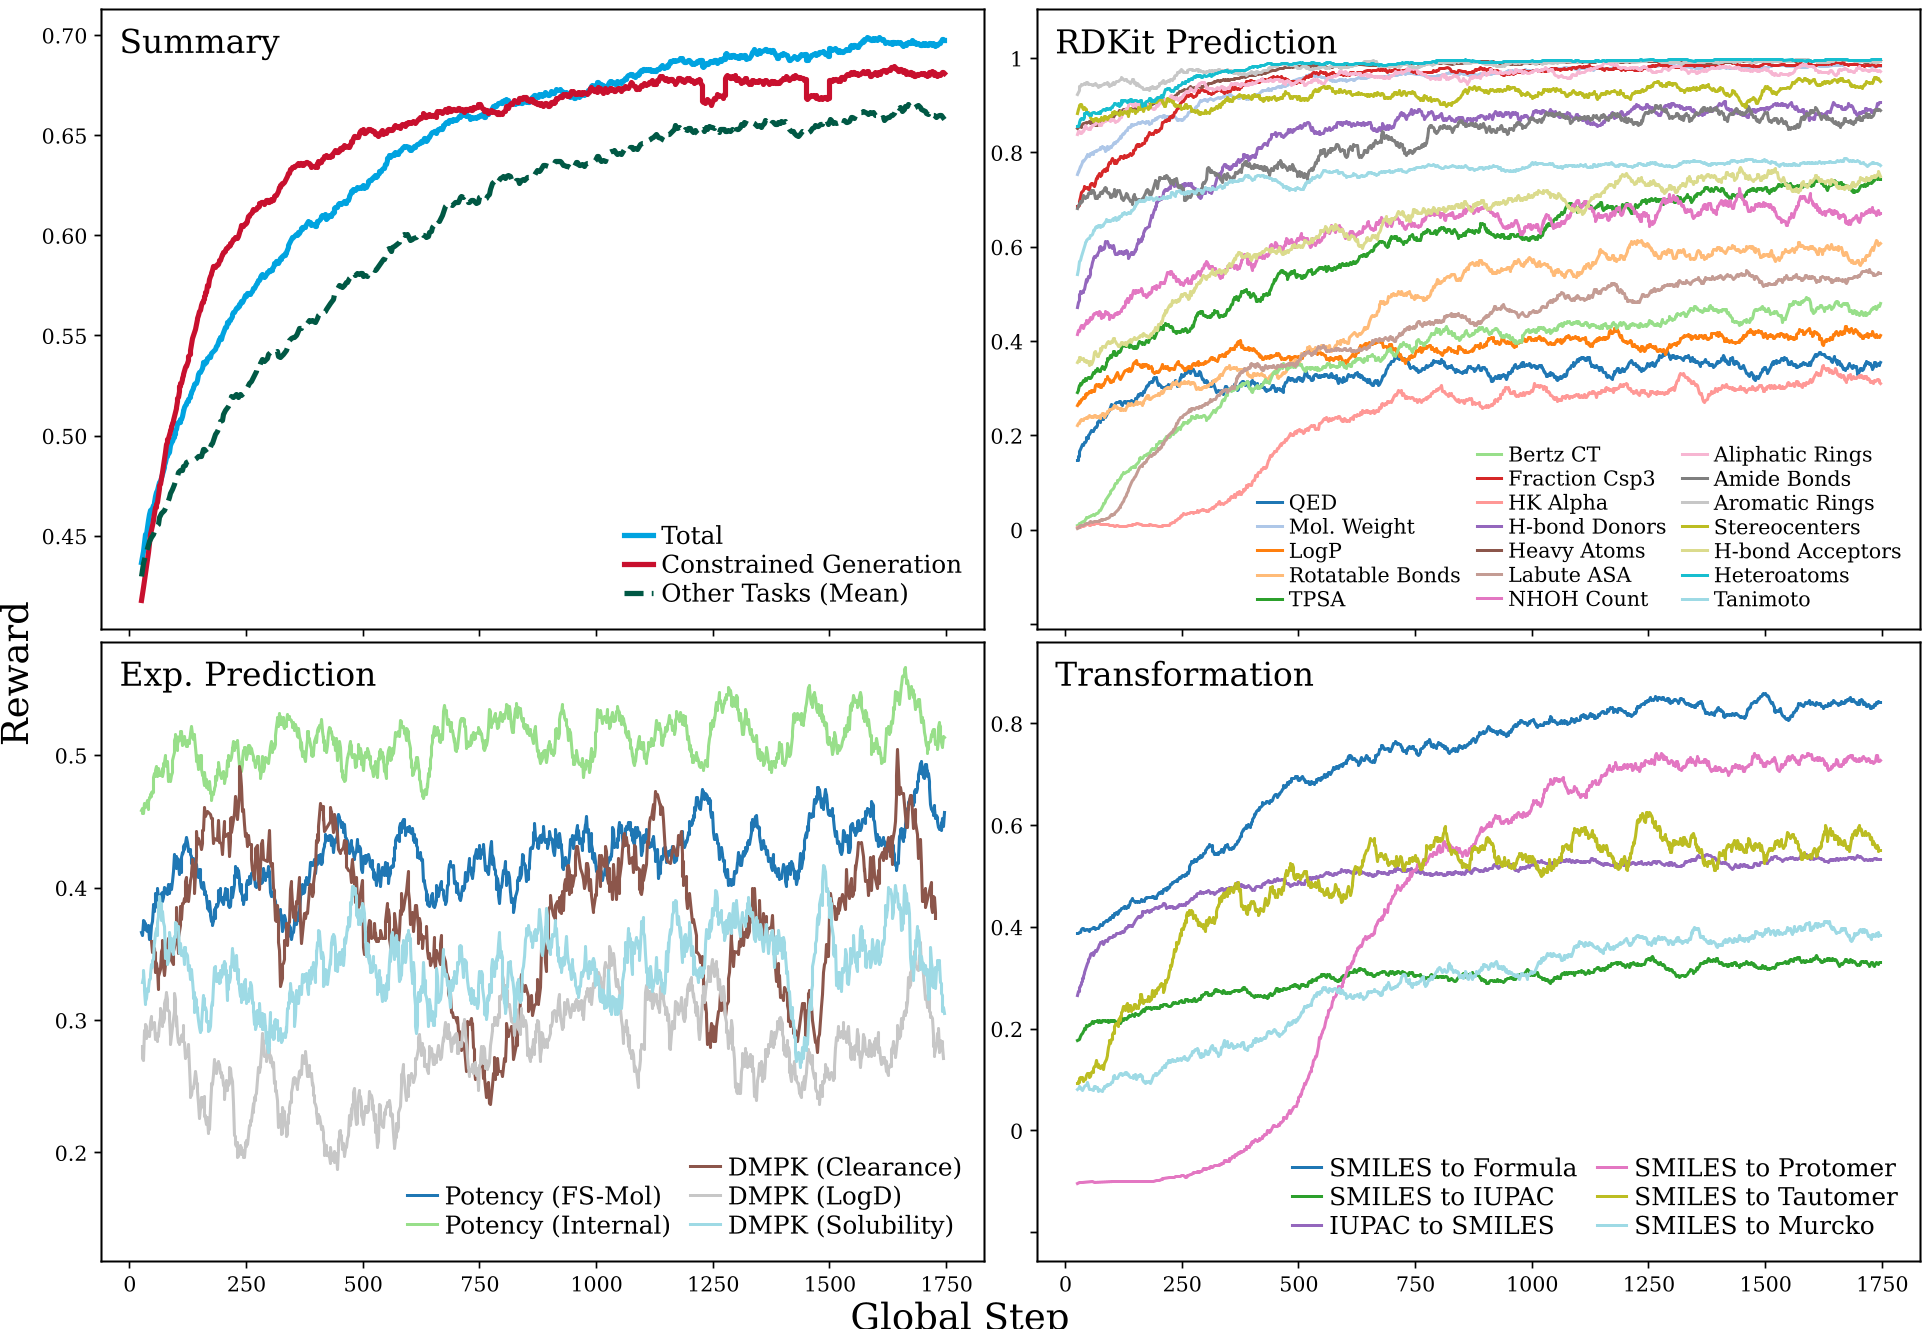 图 1:RL 训练过程中,分子生成的奖励稳步上升,展现出明显的学习曲线。
实验战果:超越前沿闭源模型
在单轮化学任务评估中,Aspen 展现出了惊人的成长性。对比其基座模型 Qwen-30B,Aspen 在可旋转键数量和 TPSA 预测上的 R² 实现了质的飞跃。
模拟先导化合物优化 (Simulated Lead Optimization)
这是本文最精彩的部分。研究者模拟了 carbonic anhydrase IX 抑制剂的开发,要求模型在保持核心骨架的前提下,通过 20 轮迭代优化分子的**对接分数(Docking Score)**并满足特定的 DMPK(药物代谢和动力学)约束。
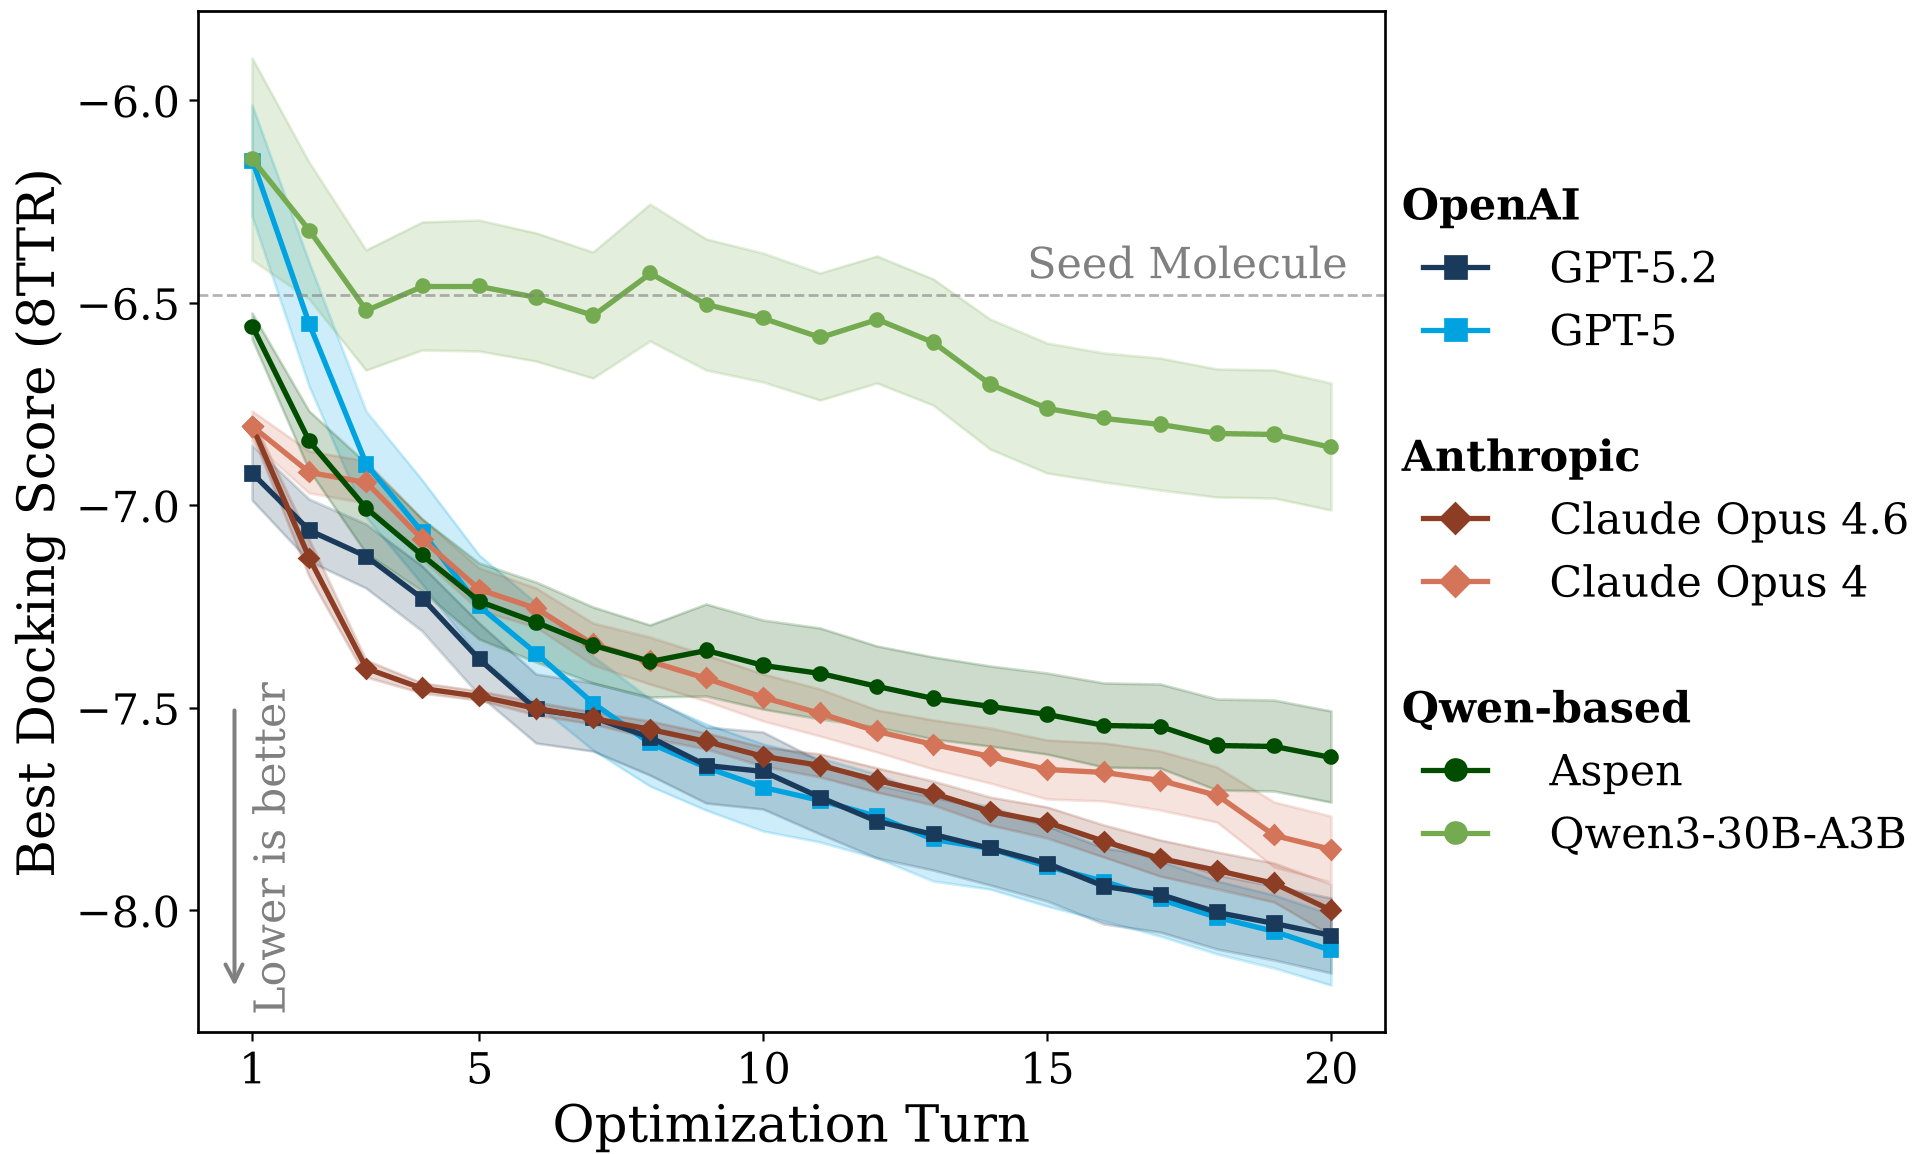 图 2:在 20 轮优化中,Aspen(绿色)的对接分数下降速度和幅度甚至优于 GPT-5 与 Claude 系列。
关键洞察:
- 策略差异:GPT-5 倾向于将脲桥(Urea Linker)转换为酰胺,而 Aspen 则更擅长通过修改外围基团(R groups)来保持骨架并提升活性。
- 帕累托优化:Aspen 在不显著增加分子量(Molecular Weight)的情况下,获得了更优的配体效率(Ligand Efficiency)。
局限性与深度洞察
尽管 Aspen 在结构化化学任务上表现优异,但论文也诚实地支出了其阿喀琉斯之踵:
- 实验数据贫乏:对于溶解度等依赖复杂实验环境、且训练数据极少的任务,RL 几乎无效。这说明 RL 只能“锐化”已知知识,不能“无中生有”。
- 模式崩塌(Mode Collapse):最强的闭源模型 Claude 4.6 竟然在生成分子的独特率(Uniqueness)上表现较差,这暗示了过度对齐可能会牺牲模型的创意空间。
总结与展望
Aspen 的出现标志着 LLM 在垂直科学领域的应用进入了**“精细化手术”阶段**。通过构建端到端的 RL 环境,我们不仅能评估 LLM 的能力,更能通过反馈循环实实在在地提升其解决复杂工业难题的上限。未来,结合 Mid-training 注入底层化学分布知识,LLM 将真正成为药物研发中不可或缺的“AI 科学家”。