
EVOLM:打破外部监督天花板,开启模型自我演化的“量规驱动”时代
EvoLM: Self-Evolving Language Models through Co-Evolved Discriminative Rubrics
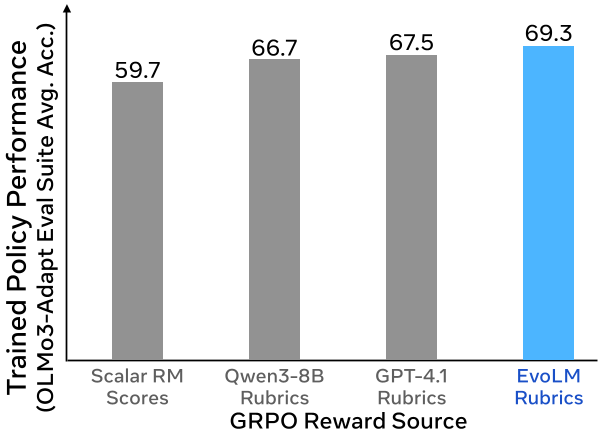
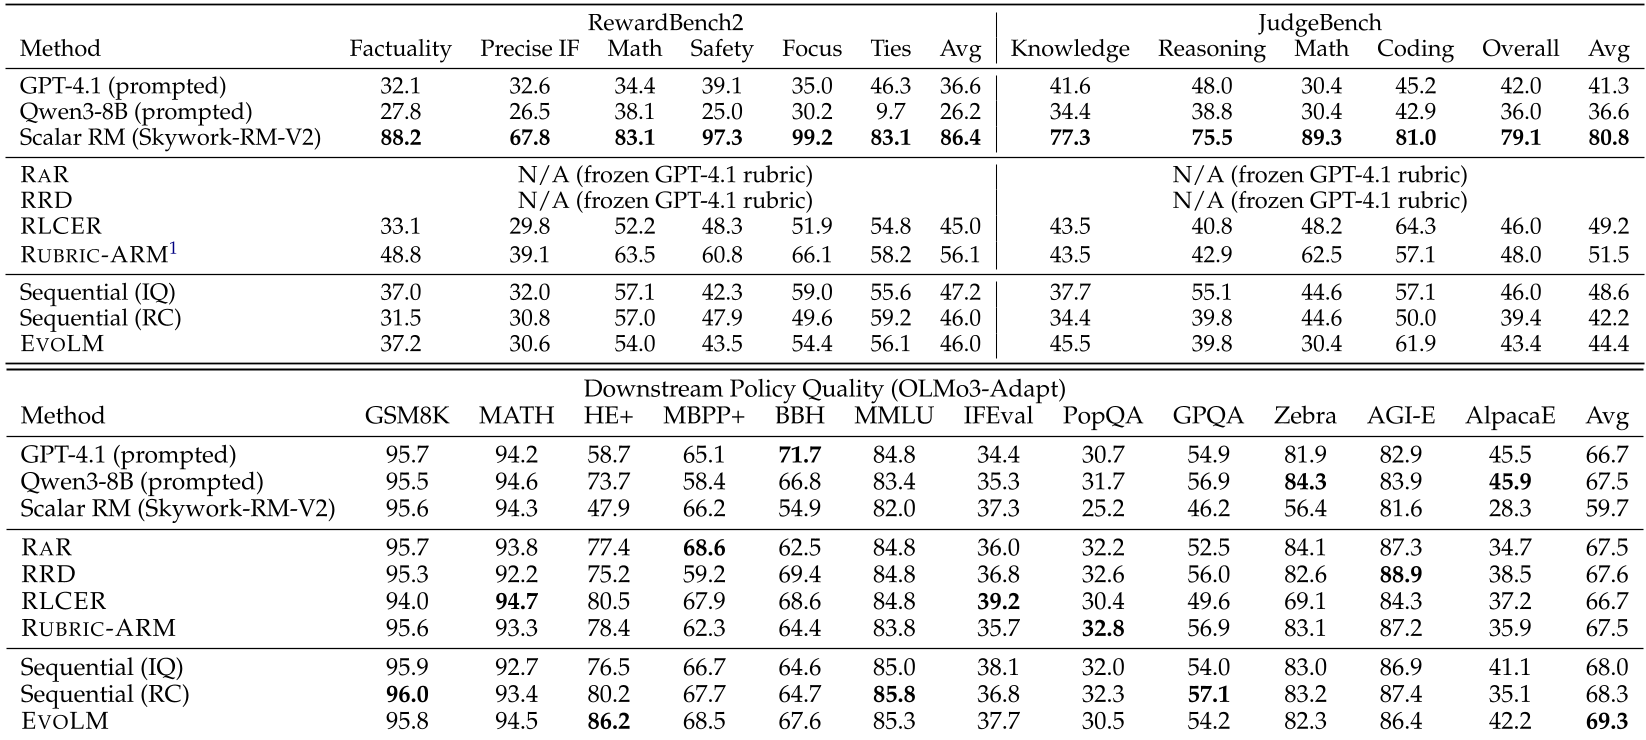
本文提出了 EVOLM,一种让大语言模型(LM)通过自我演化的“判别式量规(Discriminative Rubrics)”实现自我提升的后训练方法。该方法在 Qwen3-8B 上同时训练生成与评估能力,在 RewardBench-2 上生成的评估量规超越了 GPT-4.1 约 25.7%,且下游策略性能显著优于依赖外部监督的 SOTA 方法。
TL;DR
传统的模型对齐依赖人类标注或 GPT-4 等外部“教师”,这就像学生永远无法超过老师。华盛顿大学与 AI2 团队提出的 EVOLM 彻底改变了这一现状。它让同一个模型在学习写作的同时,学会制定极其精准的“评分标准(Rubrics)”。通过这种自我产生的判别信号,一个 8B 的模型在评估能力上竟超越了 GPT-4.1,并在 12 项认知任务中刷新了自我改进的 SOTA 记录。
痛点深挖:为什么标量奖励(Scalar RM)正在失效?
在强化学习(RL)中,奖励模型(Reward Model)通常输出一个分数值。然而,研究发现这种“黑盒”分数极易被过度优化(Reward Hacking)。模型学会了通过投机取巧获得高分,而实际任务表现却在下降。 此外,现有方法存在严重的环境依赖:
- 人类天花板:人类无法为超越自身能力的复杂任务提供精准反馈。
- API 依赖:过度依赖闭源模型如 GPT-4 来生成评分标准,不仅昂贵,而且限制了模型的独立进化。
核心机制:让量规(Rubrics)成为进化的阶梯
EVOLM 的核心直觉在于:评估比生成更容易被结构化。即便是一个 1.7B 的微小裁判模型,如果你给它一份包含“必须包含数字 144”、“不能出现关键词 manual”的详细量规,它也能变得像专家一样公正。
1. 变分推理优化量规
作者将量规视为一个“潜变量(Latent Variable)”。好的量规必须具备判别式效用——即它能让裁判模型拉开“好回答”与“坏回答”之间的分差。EVOLM 并不直接学习打分,而是学习如何“描述标准”,以此最大化区分度。
2. 三位一体的偏好信号
EVOLM 无需人类标注,它通过以下三种方式构造“好、坏”对比对:
- 时间对比 (Temporal Contrast):模型当前生成的回答(强) vs. 千步之前生成的回答(弱)。
- 推测提问 (Inferred Question):根据回答回推问题,看量规能否识别回答是否跑题。
- 量规约束 (Rubric-conditioned):对比在量规引导下和无引导下生成的回答。
实验发现:量规从“抽象标签”进化为“可验证核对表”
研究者通过定性分析发现了一个惊人的现象:随着训练进行,模型生成的量规不再是简单的“逻辑严密”、“表达清晰”等模糊词汇,而是演变成了具备极高具体性的验证清单。
例如在数学任务中,模型学会了将 80% 的权重分配给“最终答案是否为 144”这一项。这种将复杂证明转化为“模式匹配”的策略,极大地降低了后验裁判的难度。
深度洞察:小型裁判的逆袭
EVOLM 最具启发性的结论之一是:裁判的大小并不关键。实验显示,使用 1.7B 模型作为裁判的效果甚至优于 14B 模型。这是因为较小的模型对模糊指令更敏感,从而倒逼“量规生成器”必须产出极其精确、不容置疑的标准。这种“精准量规 + 弱裁判”的组合,反而提供了比“大裁判 + 模糊标准”更稳定的训练信号。
总结与展望
EVOLM 证明了 LLM 内部潜藏着巨大的评估潜能。通过将这种潜能结构化为可阅读、可解释的自然语言量规,模型能够拉着自己的头发离开地面,摆脱外部监督的束缚。这不仅是学术上的 SOTA,更为未来开发具备完全自主进化能力的 AI 智能体指明了方向。
局限性:目前该方法主要在通用任务上验证,针对医疗、法律等极其严谨的专业领域,量规的演化逻辑是否依然成立仍需进一步验证。