
[ACL 2025] F2LLM-v2:打破语言壁垒,打造全尺寸、多语言 SOTA 嵌入模型
F2LLM-v2: Inclusive, Performant, and Efficient Embeddings for a Multilingual World
本文推出了 F2LLM-v2 系列泛用型多语言嵌入模型,包含从 80M 到 14B 的 8 种尺寸。该模型在 6000 万高质量开源数据上训练,支持超过 200 种语言,并在 11 项 MTEB 基准测试中取得 SOTA 成就,涵盖多语言、代码和医疗等领域。
TL;DR
在当前嵌入模型研究中,由于数据和算力的倾斜,非英语语言往往沦为“二等公民”。来自蚂蚁集团与上海交大的研究团队推出了 F2LLM-v2,这是一套覆盖 80M 到 14B 参数量的全开源嵌入模型家族。它不仅在 11 项 MTEB 基准上刷写了记录,更重要的是,它通过模型剪枝与知识蒸馏,让仅 80M 的小模型也能在多语言任务中爆发巨大能量。
痛点深挖:为何我们需要 F2LLM-v2?
尽管嵌入技术已从 Transformer Encoder(如 BERT)演进至 LLM-based Decoder 时代(如 E5-Mistral, NV-Embed),但行业仍面临两大痛点:
- 语言不平等:大多数模型在英语上表现优异,但在波兰语、波斯语、越南语等中低资源语言上几乎“失聪”。
- 效率与黑盒化:顶尖模型往往体积巨大且闭源,开发者在资源受限(如移动端、边缘计算)或对隐私要求高的场景下无计可施。
核心架构与方法论
F2LLM-v2 的成功建立在“海量高质量数据”与“高效训练策略”的双重驱动之上。
1. 282 种语言的大规模语料库
作者从 157 个公开源精炼出 6000 万个样本,涵盖 282 种自然语言和 40 种编程语言。与同类开源模型单纯刷榜不同,F2LLM-v2 特意增加了如阿拉伯语、印尼语等在 MTEB 中缺乏基准但实际应用广泛的语言数据。
2. 两阶段训练逻辑
- 第一阶段(基础语义):在 2700 万检索样本上训练,建立稳固的全局语义空间。
- 第二阶段(指令微调):引入任务特定指令,通过对冲刷 1800 万样本,强化模型在分类、聚类、重排序等细分任务下的判别力。
3. 三位一体的轻量化技术(剪枝、蒸馏、MRL)
这是本文的核心技术见解:
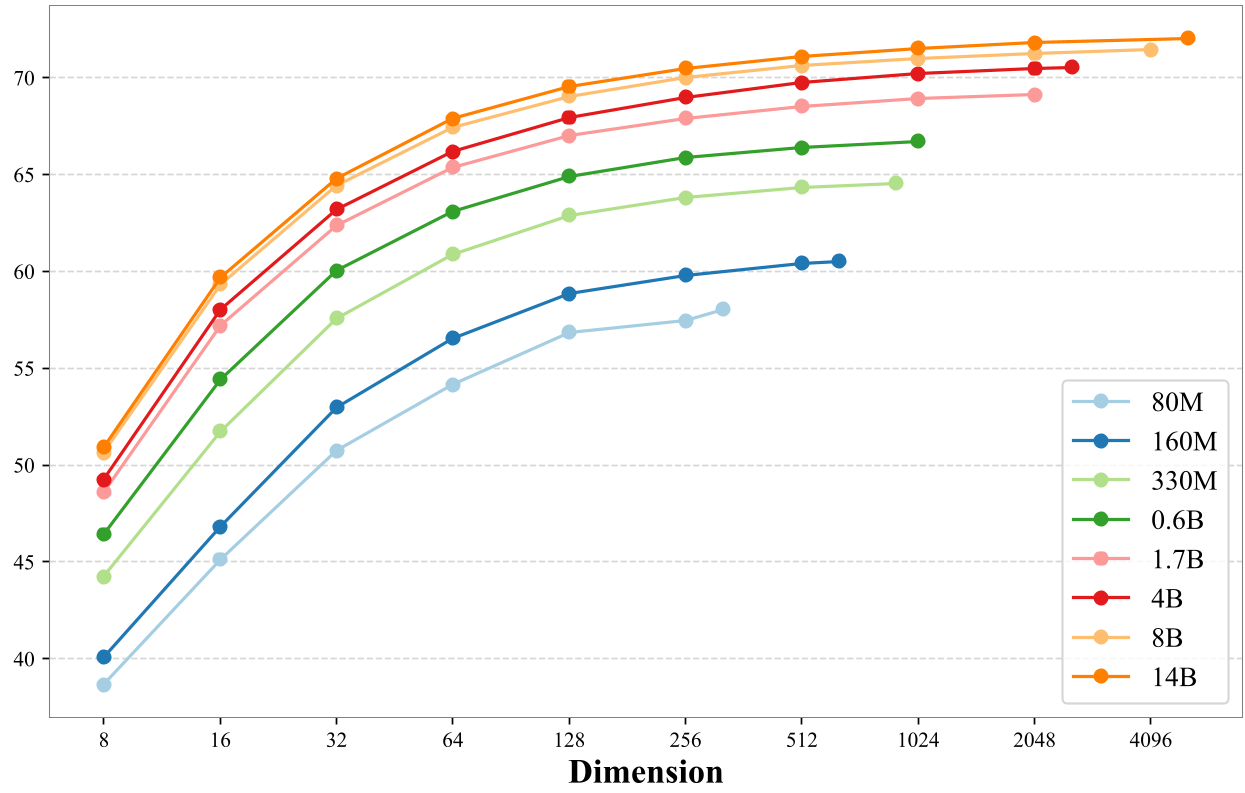
- Matryoshka Representation Learning (MRL):允许模型在同一套权重下输出不同维度的向量(从 8 维到全尺寸)。这意味着你可以在不重新训练的情况下,根据索引成本动态缩减向量长度。
- 知识蒸馏:作者将大模型(如 1.7B)作为 Teacher,通过 MSE Loss 指导剪枝后的 Student(如 0.6B、330M)进行学习,弥补了参数减少带来的性能损失。

实验战绩:全线 SOTA
F2LLM-v2-14B 模型在多语言检索、代码检索、医疗等 11 项 MTEB 基准中取得了全球第一。
小模型的逆袭:
在 330M 和 0.6B 体量的横向对比中,F2LLM-v2 在韩语、波兰语、日语等多个语言特定榜单上显著优于 Qwen3-Embedding 和 EmbeddingGemma。

消融研究揭示了 MRL 的魔力:
如下图所示,模型性能随着嵌入维度的增加而快速增长,但在 128 维后趋于平缓。这意味着在许多 RAG 场景中,使用 128 维甚至 64 维向量就能保留大模型 90% 以上的性能,从而节省数倍的内存和磁盘开销。
深度洞察与总结
F2LLM-v2 的价值不仅在于它刷了多少分,而在于它提供了一套完整的“轻量化、多语言 LLM 嵌入”工业化方案。
- Inclusive(包容性):真正关注到了全球英语之外的数十亿用户。
- Performant(高性能):通过精心设计的两阶段训练和负采样,确立了新的开源 SOTA 标杆。
- Efficient(高效):通过蒸馏和 MRL,让嵌入模型从“云端昂贵服务”变成了“人人可用的本地工具”。
总结 (Takeaway):F2LLM-v2 的全开源(包括训练数据、代码、中间权重)是嵌入模型领域的一次重要回归,它打破了闭源模型的垄断,也为端侧 RAG、代码检索等垂直领域的研究提供了极具竞争力的底座。
注:所有 F2LLM-v2 模型已在 Hugging Face 与 GitHub (CodeFuse-AI) 同步上线。