
FAB:突破动态有向网络下的分布式双层优化瓶颈
FAB: A First-Order AB-based Gradient Algorithm for Distributed Bilevel Optimization over Time-Varying Directed Graphs
本文提出了 FAB,这是首个针对时变有向图(Time-Varying Directed Graphs)设计的全一阶分布式双层优化算法。该方法结合了 Push-Pull(AB)通信策略与基于价值函数的惩罚法,在非凸-强凸设置下实现了 SOTA 的收敛性能。
TL;DR
在自动驾驶、卫星组网或多无人机协同等现实场景中,通信网络往往是时变的且有向的(即 A 能传给 B,但 B 不一定能立刻传回 A)。传统的分布式优化算法在这些场景下会因为“信息不对称”而失效。本文提出的 FAB 算法,首次在时变有向图中实现了高效的全一阶双层优化,不仅无需计算昂贵的 Hessian 矩阵,还顺便解决了 Push-Pull 架构在非凸场景下的收敛性难题。
背景定位:由于动态拓扑带来的“共识灾难”
分布式优化的核心是让所有参与节点对某个全局目标达成共识。在静态无向图中,这很简单;但在时变有向图中,两个致命问题会出现:
- Consensus Bias:因为网络权重不再是双随机的,节点间的信息流失衡,导致模型参数永远无法收敛到真正的全局最优。
- 二阶导数陷阱:双层优化(如超参数调节、强化学习中的贝尔曼残差最小化)通常涉及逆 Hessian 矩阵,这在分布式环境下会导致巨大的通信开销和计算延迟。
痛点深挖:为什么前人做不到?
现有的分布式双层算法(如 DBO, SPARKLE)大多数假设网络是静态无向的,且由于采用了二阶方法,它们需要频繁进行矩阵向量乘法。而在动态网络中,由于拓扑结构瞬息万变,维护二阶信息的准确性几乎是不可能的。
核心算法:FAB(First-order AB-based gradient)
FAB 的成功归功于两个核心 Insight:
1. 消除二阶导数:惩罚函数法
FAB 并没有直接求解原始双层问题,而是通过价值函数(Value Function)将其转化为一个等价的约束问题,并引入惩罚参数 。这样,原本需要计算 Hessian 逆的超梯度估计,转变成了简单的梯度下降上升(Gradient Descent Ascent)过程。
2. 对抗拓扑不平衡:Push-Pull (AB) 策略
算法维护了两组决策变量:
- Step 1 (Pull):使用行随机矩阵 拉取邻居状态,确保变量的一致性。
- Step 3 (Push):使用列随机矩阵 推送梯度信息,利用 Gradient Tracking 技术补偿有向图带来的偏差。
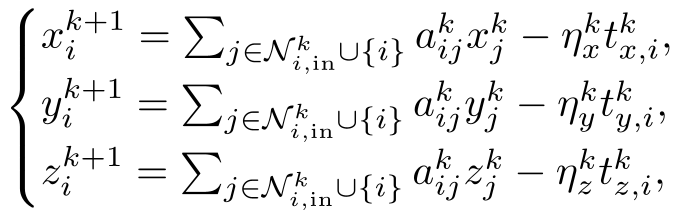 上图展示了 FAB 在每一代迭代中,如何通过 decision variable 和 tracking variable 的协同更新实现共识。
实验与战绩:全方位的降维打击
作者在超参数调优、强化学习和数据清洗三个任务上进行了广泛测试。
1. 鲁棒性验证:对抗数据噪声
在 MNIST 图像分类实验中,即使在标记损坏(Label Corruption)率高达 60% 的极端环境下,FAB 依然能保持极高的测试精度,而传统的单层优化算法(如 SGP)由于无法利用双层结构进行超参自动纠偏,性能出现了大幅滑坡。
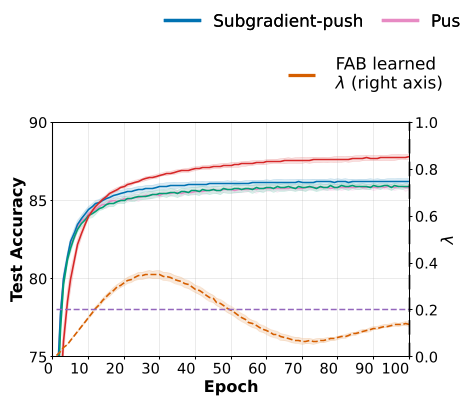 图 (a)(b) 显示了在不同错误率下,FAB(红线)的性能显著优于其他基线方法。
2. 扩展性:BERT 模型微调
作者还挑战了大规模 NLP 任务——在 IMDB 数据集上微调 BERT。结果显示,FAB 不仅在准确率上领先,其内存消耗也并未随模型深度增加而出现指数级增长,证明了其处理大规模深层模型的能力。
深度洞察:不仅仅是双层优化
这篇论文最令人惊喜的附属贡献是:它补齐了单层分布式优化的最后一块版图。 长期以来,Push-Pull 算法在非凸时变有向图下的收敛速率一直是理论界的空白。FAB 的分析框架稍微精简一下,就得到了单层非凸 Push-Pull 的 收敛率,这为分布式非凸优化提供了关键的理论支撑。
总结与局限
FAB 是一篇兼具理论深度和工程实用价值的佳作。它用纯粹的一阶算子解决了分布式环境下最棘手的拓扑和二阶计算难题。 局限性:虽然收敛率达标,但其对于节点数量 的依赖关系在最坏情况下仍是指数级的(),这反映了动态有向图分析的固有难度。未来的研究方向可能在于如何进一步结合动量项(Momentum)或减少对惩罚参数 的敏感度。
Takeaway: FAB 告诉我们,面对复杂的分布式拓扑,有时退回一阶、引入惩罚,反而比追求精确的二阶信息更稳、更快、更强。