
模拟 120 位的费米子世界:量子计算机如何在 Fermi-Hubbard 模拟中超越经典 SOTA
Fast, accurate, high-resolution simulation of large-scale Fermi-Hubbard models on a digital quantum processor
本文报告了在 156 位超导量子处理器(IBM Heron)上对 1D Fermi-Hubbard 模型动力学的数字量子模拟,成功实现了高达 120 个量子位和 90 个 Trotter 步的模拟。通过高效的 fermion-to-qubit 映射及误差抑制技术,该工作在多达 60 个格点的规模上观察到了自旋-电荷分离现象,并在长演化时间下达成了与 SOTA 经典模拟方法(TDVP)RMSE < 1% 的一致性。
TL;DR
研究人员利用 156 位的 IBM Heron 处理器,成功对 1D Fermi-Hubbard 模型进行了深度数字量子模拟。通过引入对交错(Pair-interleaved)映射和 Q-CTRL 的系统级误差抑制,该工作在 120 个量子位的规模上展现了极高的动力学模拟精度。最令人震撼的是,在该尺度下,量子处理器的执行效率比最先进的张量网络方法(TDVP)快了约 3000 倍,且精度误差(RMSE)控制在 1% 左右。
背景定位:凝聚态物理的“圣杯”模型
Fermi-Hubbard 模型是凝聚态物理中描述强关联电子系统的基石,是理解高温超导机制、莫特绝缘体等复杂物理现象的关键。然而,模拟该模型的非平衡态动力学极其困难——由于纠缠熵随时间线性增长,经典的张量网络(Tensor Networks)方法会面临“纠缠墙”,计算量随时间呈指数爆炸。
痛点深挖:为什么之前的量子模拟“不好使”?
尽管 Feynman 早在 40 年前就提出了量子模拟的设想,但实际操作中面临两大难题:
- 映射成本(Mapping Overhead):费米子算符转化为量子位算符(Jordan-Wigner 变换)通常会引入长程算符(Z-string),导致量子电路极其深。
- 硬件噪声(Hardware Noise):随着电路深度(Trotter 层数)增加,相干错误和退相干效应会迅速淹没物理信号。
方法论详解:应用感知编译与误差抑制
1. 架构创新:对交错映射
作者并没有沿用传统的“块排列”J-W 变换,而是设计了一种特殊的交错排序:{c0↓, c0↑, c1↑, c1↓...}。配合 fSWAP 网络,这套方案能将所有的动力学项映射为重型角格(Heavy-hex)拓扑上的近邻相互作用。
- 结果:相比 Qiskit 的标准转译方案,双量子位门数量减少了 60%,电路深度降低了 80%。
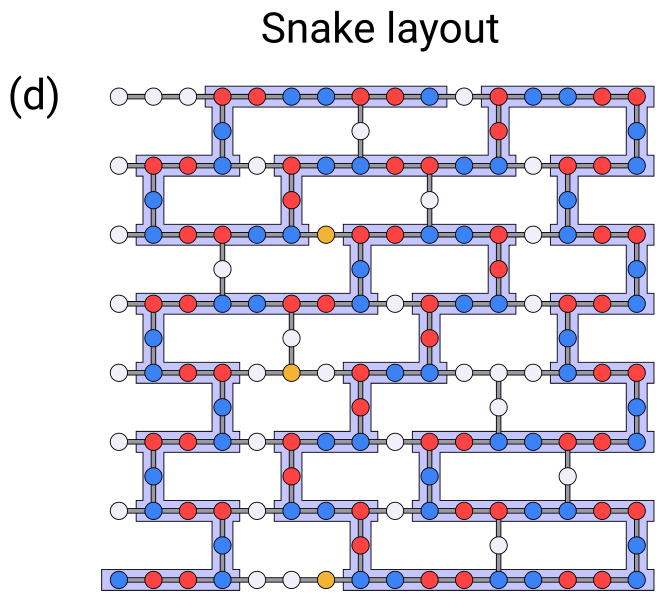 图 1:应用感知编译流程。从费米子链到重型角格(Heavy-hex)拓扑的高效映射,以及对称化 Trotter 电路的构造。
2. 核心利器:无开销误差抑制(Error Suppression)
作者采用了 Q-CTRL 的 Fire Opal 技术栈,这不仅包括了常见的动态解耦(Dynamical Decoupling),还结合了随机编译(Randomized Compiling)。这些技术在运行时将相干系统误差转化为随机统计噪声,显著提升了电路的信噪比,且不需要像传统的量错缓解(Error Mitigation)那样通过海量重复采样来换取精度。
实验战绩:超越经典模拟的边界
自旋-电荷分离的直接观测
在 L=31 的系统中,作者观察到了 1D 系统特有的分形化现象:当引入空位缺陷后,电荷扰动(Holons)和自旋扰动(Spinons)以不同的速度传播。实验提取的波前速度 vc/vs 与经典理论值高度吻合。
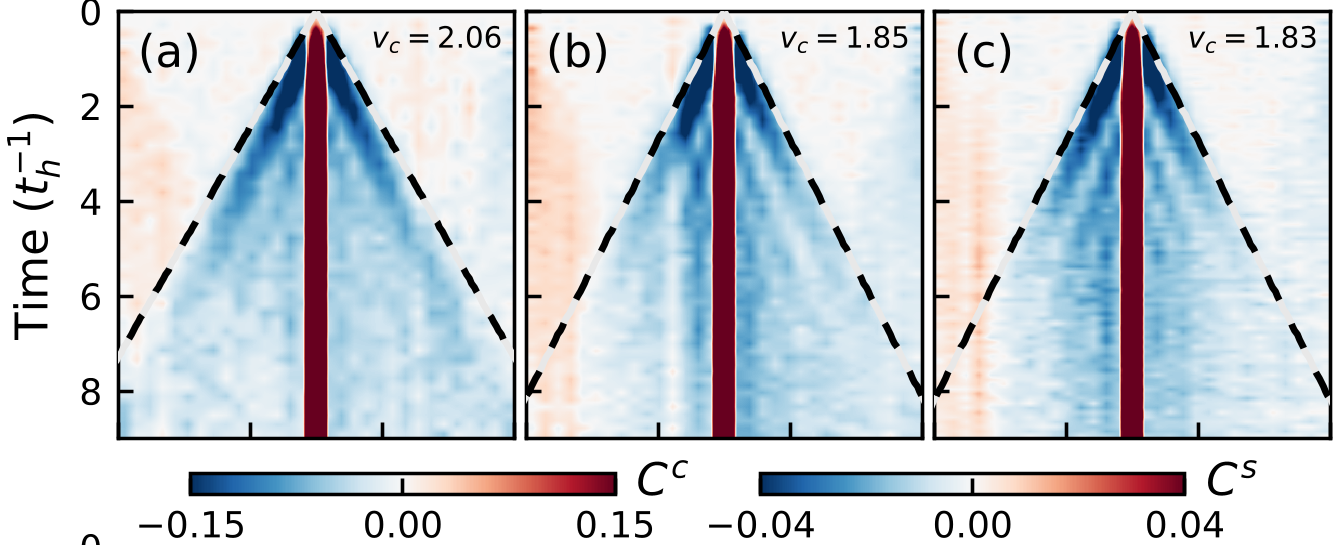 图 2:L=31 规模下的自旋-电荷分离观测。上方为电荷密度演化,下方为连接自旋相关函数,清晰显示了两者的速度差异。
3000 倍的效率绝杀
在扩展到 L=60(120 量子位)的大规模模拟时,研究团队遇到了经典模拟的“性能天花板”。即便使用拥有 32 核、高达 4096 键向维数的优化版 TDVP,单次模拟也需耗时超过百小时;而量子处理器仅需约 2.7 分钟 即可获得同等精度的结果。
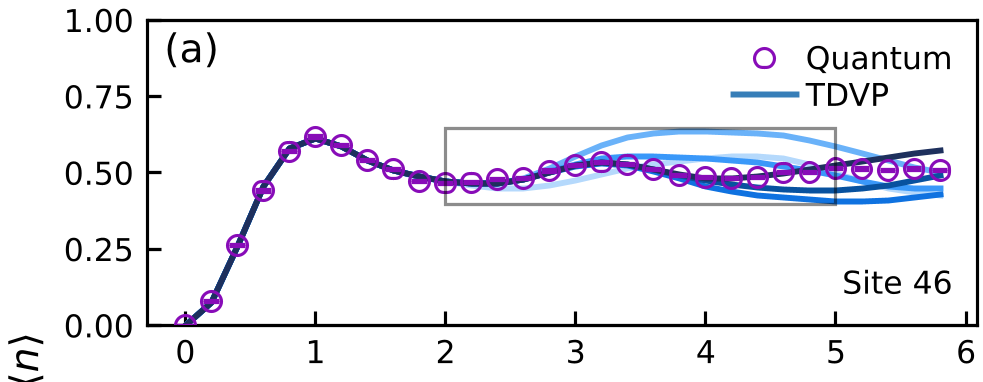 图 3:量子与经典模拟的性能差异。随着演化时间推进,量子处理器保持极短运行时间,而 TDVP 呈指数增长。
深度洞察与总结
局限性分析
虽然本文在 1D 模型上取得了重大胜利,但在向 2D 扩展时,fSWAP 网络的深度会有所增加。此外,目前模拟的演化时间(t ~ 6)虽然已超越了许多经典基准,但仍处于“准稳态”附近。
行业启示
这篇论文的一个核心贡献是:量子模拟的实用价值不一定要等到纠错量子计算机(FTQC)出现。通过精细的软件优化和硬件级别的实时脉冲控制(如 Fire Opal 所做的那样),我们可以在当前的 NISQ 硬件上,针对特定的科学计算难题,提前锁定“量子优势”。
未来的研究方向将聚焦于将该方法扩展至带有磁性杂质或 2D 拓扑的模型,那里的“费米子正负号问题”会让所有经典方法彻底失灵,从而为量子计算机留下真正的绝杀舞台。