
彻底告别 Tokenizer:BLT-D 如何通过块扩散实现字节级模型性能飞跃
Fast Byte Latent Transformer
本文提出了 Fast Byte Latent Transformer (BLT-D),一种通过块状离散扩散(Block-wise Discrete Diffusion)加速生成的字节级语言模型。该模型结合了层次化潜在表示与并行解码技术,在保持字节级模型无分词器(Tokenizer-free)优势的同时,显著提升了推理速度。
TL;DR
Meta 与斯坦福大学的研究团队发布了 Fast Byte Latent Transformer (BLT-D)。该工作成功解决了字节级模型(Tokenizer-free)长期以来的“阿喀琉斯之踵”——生成速度慢。通过引入块状离散扩散(Block-wise Diffusion)和自投机解码(Self-speculation),该模型在推理时的内存带宽需求降低了 50%-92%,使得直接处理原始字节的吞吐量足以媲美传统的子词模型。
背景定位:为什么要坚持“字节级”建模?
尽管基于 Tokenizer 的模型(如 Llama, GPT-4)是当前主流,但分词器带来了诸多结构性问题:
- 鲁棒性差:微小的拼写错误可能导致 Embedding 剧变。
- 跨语言不平等:非英语语种往往需要更多的 Token 来表示相同含义。
- 特殊领域乏力:在代码、数学或生僻字符处理上,预定义的词表经常失效。
早期的字节级模型虽然优雅,但“一个字节执行一次推理”的计算开销是生产环境无法承受的。
核心机制:扩散与投机的高效结合
1. BLT-D:并行生成的艺术
作者在原有的 BLT 层次化架构上,引入了辅助的块扩散目标(Block-wise Diffusion Objective)。不同于传统的逐字预测,BLT-D 的解码器能够一次性观察并预测一个固定长度(如 8 或 16 字节)的缓冲区。
- 训练阶段:模型同时学习自回归预测(Next-byte Prediction)和掩码恢复(Masked Diffusion)。
- 推理阶段:采用“置信度启发式(Confidence-based)”或“熵限界采样(Entropy-bounded Sampling)”策略,在一个解码步内填充多个 [MASK] 槽位。
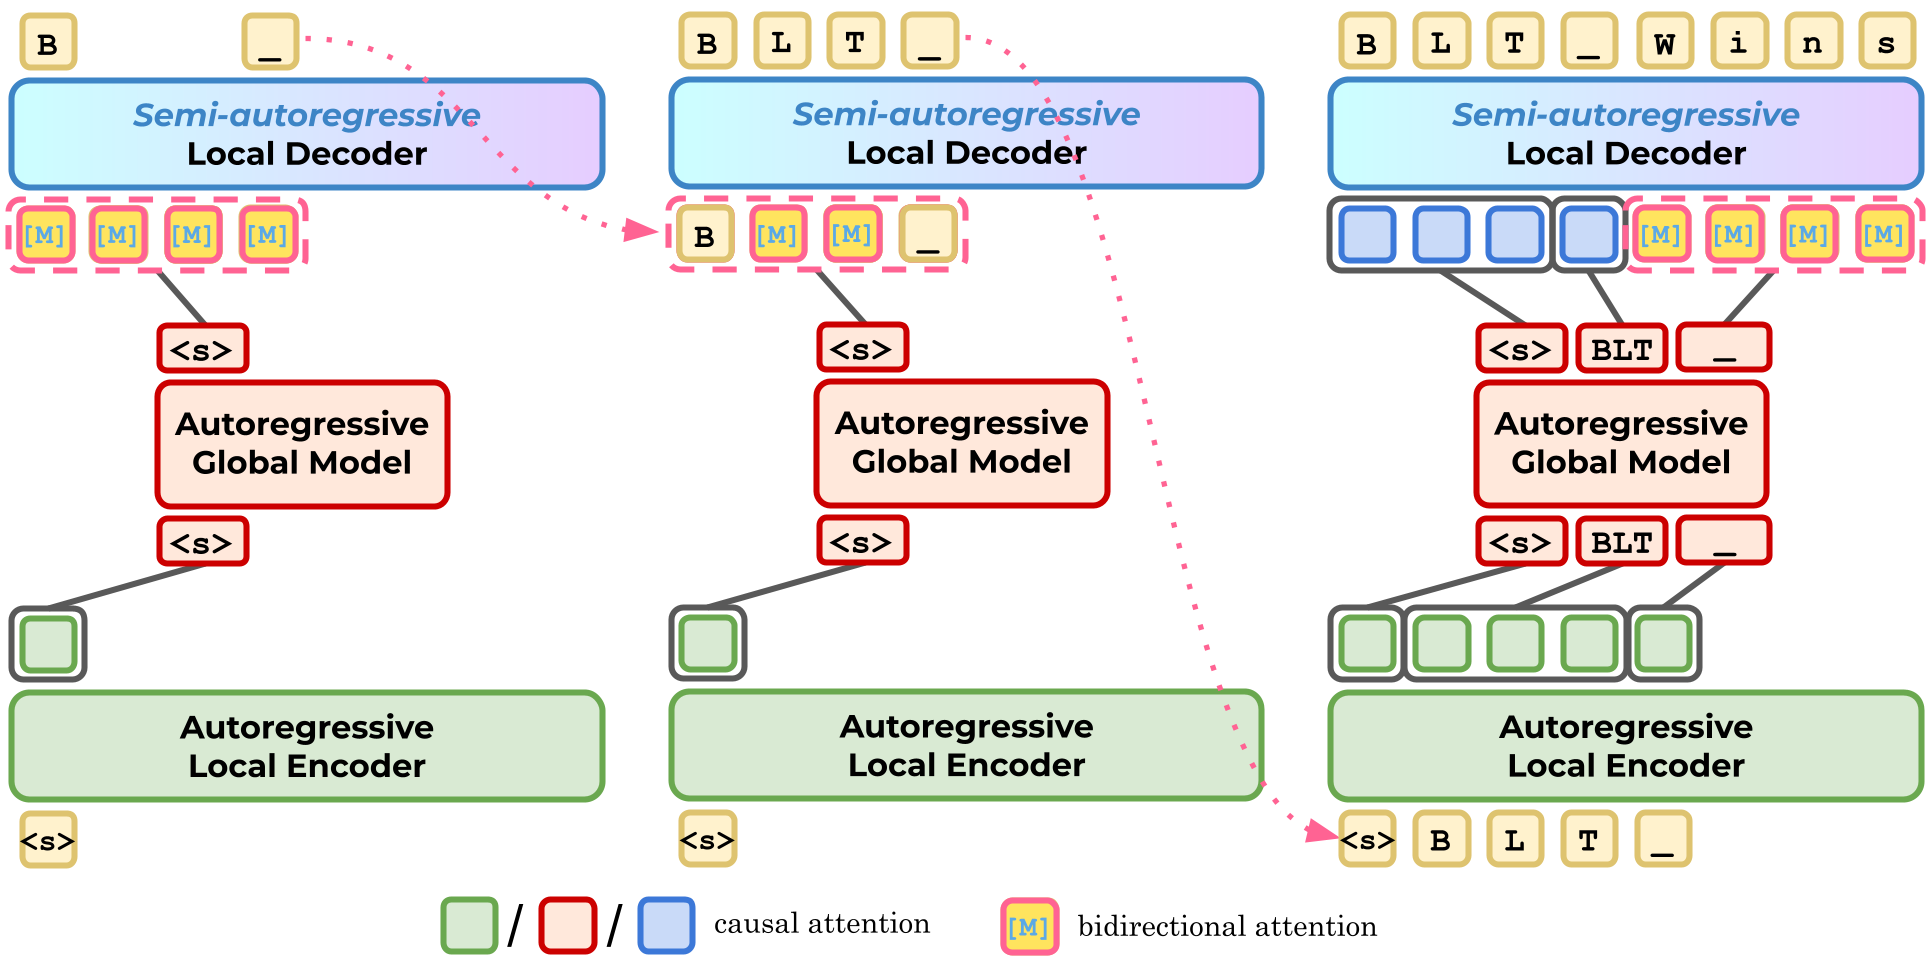 图 1:BLT-D 推理流程,展示了全局模型处理 Latent Token 与解码器并行生成字节的协同过程。
2. BLT-S 与 BLT-DV:验证带来的精准度
为了在加速的同时保证质量,作者提出了两种变体:
- BLT-S (Self-speculation):模型利用自身极其轻量(仅 160M)的本地解码器在没有 Latent 信息的情况下“盲猜”未来的几个字节,然后由昂贵的全局模型(1.2B/2.8B)一次性快速验证。这种方式在逻辑上是无损的。
- BLT-DV (Diffusion+Verification):先用扩散模型跑出一个“草稿块”,再用同一模型的自回归权重进行修正。
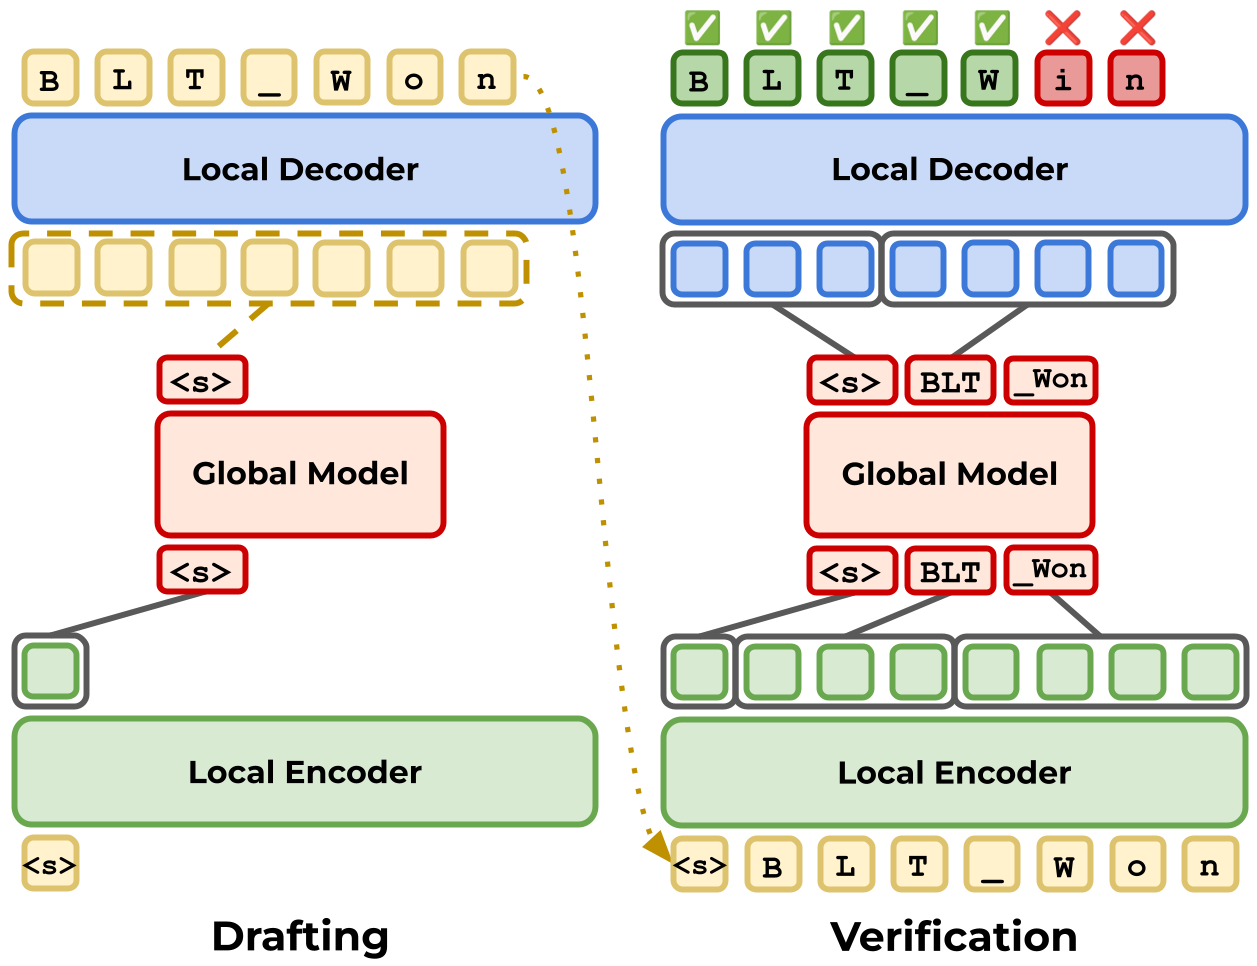 图 2:BLT-S 与 BLT-DV 共享的验证机制,确保生成的字节序列符合模型真实的条件概率分布。
实验战绩:效率的质变
在翻译任务(FLORES-101)和代码生成任务(HumanEval, MBPP)中,BLT-D 展现了恐怖的效率优势:
- 速度提升:在 3B 模型上,BLT-D-16 相比原始自回归 BLT,内存带宽成本下降了约 90%。
- 性能保持:BLT-D-4 在几乎不损失 BLEU 分数的情况下,实现了 50% 以上的提速。
- 架构优势:实验证明,通过调整“块大小(Block Size)”,开发者可以在推理速度和生成质量之间灵活滑动。
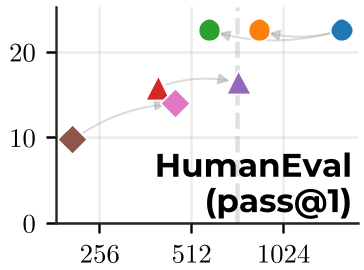 图 3:3B 模型在翻译任务中的性能-效率权衡曲线,BLT-D 系列明显处于左上角的帕累托最优区。
深度洞察:为什么这很重要?
BLT-D 的成功揭示了一个深刻的直觉:字节级建模的冗余性其实是推理加速的温床。 由于字节序列具有极高的局部相关性(Local Correlation),解码器大部分时间都在处理非常容易预测的内容。BLT-D 的核心贡献在于它找到了如何平衡“轻量级局部解码”与“高成本全局建模”的杠杆。
局限性与展望
尽管取得了巨大成功,本文目前主要依赖 Network Function Evaluations (NFEs) 和内存带宽估计作为指标,真实的硬件端到端(End-to-end)时延仍需通过高度优化的算子(如更深度的 KV-Cache 管理)来进一步验证。
未来,该技术有望在多模态(原始音频、原始像素)等天然具有“长字节流”特性的任务中大放异彩。
总结 (Takeaway)
BLT-D 的出现意味着“Tokenizer-free”不再仅仅是一个理论理想,它正通过算法创新进化为一种在工业界具备竞争力的架构方案。