
[Huawei 2026] FineViT:用 4.5 亿密集群区域描述解锁视觉感知的“微观世界”
FineViT: Progressively Unlocking Fine-Grained Perception with Dense Recaptions
本文推出了 FineViT,一种专门为长上下文细粒度感知设计的视觉编码器。通过从零开始的渐进式训练和大规模高密度重描述(Dense Recaption)数据集 FineCap-450M,FineViT 在长文本检索和 MLLM 任务中达到了 SOTA 水平。
TL;DR
多模态大模型的推理能力在飞速进化,但它们的“眼睛”——视觉编码器(Visual Encoder)却长期停留在 CLIP 时代的粗放阶段。华为团队推出的 FineViT 试图通过从零训练和 FineCap-450M(目前最大的细粒度数据集)彻底解决这个问题。它不仅在常规指标上追平 SigLIP2,更在长文本检索和 OCR 密集感知任务上展现了统治级的优势。
背景定位:视觉编码器的“视网膜”危机
目前大多数 MLLM 仍在使用预训练好的 CLIP 或其变体。这种方式存在天然的“信息衰减”:
- 分辨率固着:CLIP 通常在 224px 或 336px 下训练,对于图片中的文字或远处的微小物体,就像近视眼看世界,细节全无。
- 描述匮乏:互联网爬取的图文对通常只有简单的几个单词(如“海滩上的狗”),无法描述图片中复杂的空间关系和局部细节。
核心方法:三阶段渐进式解锁 (Progressive Unlocking)
FineViT 的核心不只是模型架构,更是一套严密的训练流水线:
1. 架构升级:原生高分辨率支持
FineViT 采用了 0.86B 参数的 Transformer 结构,引入 2D RoPE 以应对不同宽高比和极高分辨率(最高 1000px)的输入,确保模型在缩放分辨率时位置编码不会失效。
2. 三阶段训练秘籍
- Stage I: MIM 初始化。利用掩码图像建模(Masked Image Modeling)让模型学习物体的几何和空间结构。
- Stage II: 亿级数据对比学习。在 15.6 亿张经过重描述(Recaptioned)的图文对上训练,分辨率提升至 448px。
- Stage III: 局部感知对齐。这是 FineViT 的杀手锏。利用生成的 4.5 亿个局部区域描述,进行图文坐标与文本的交叉训练(如 bbox-to-string)。
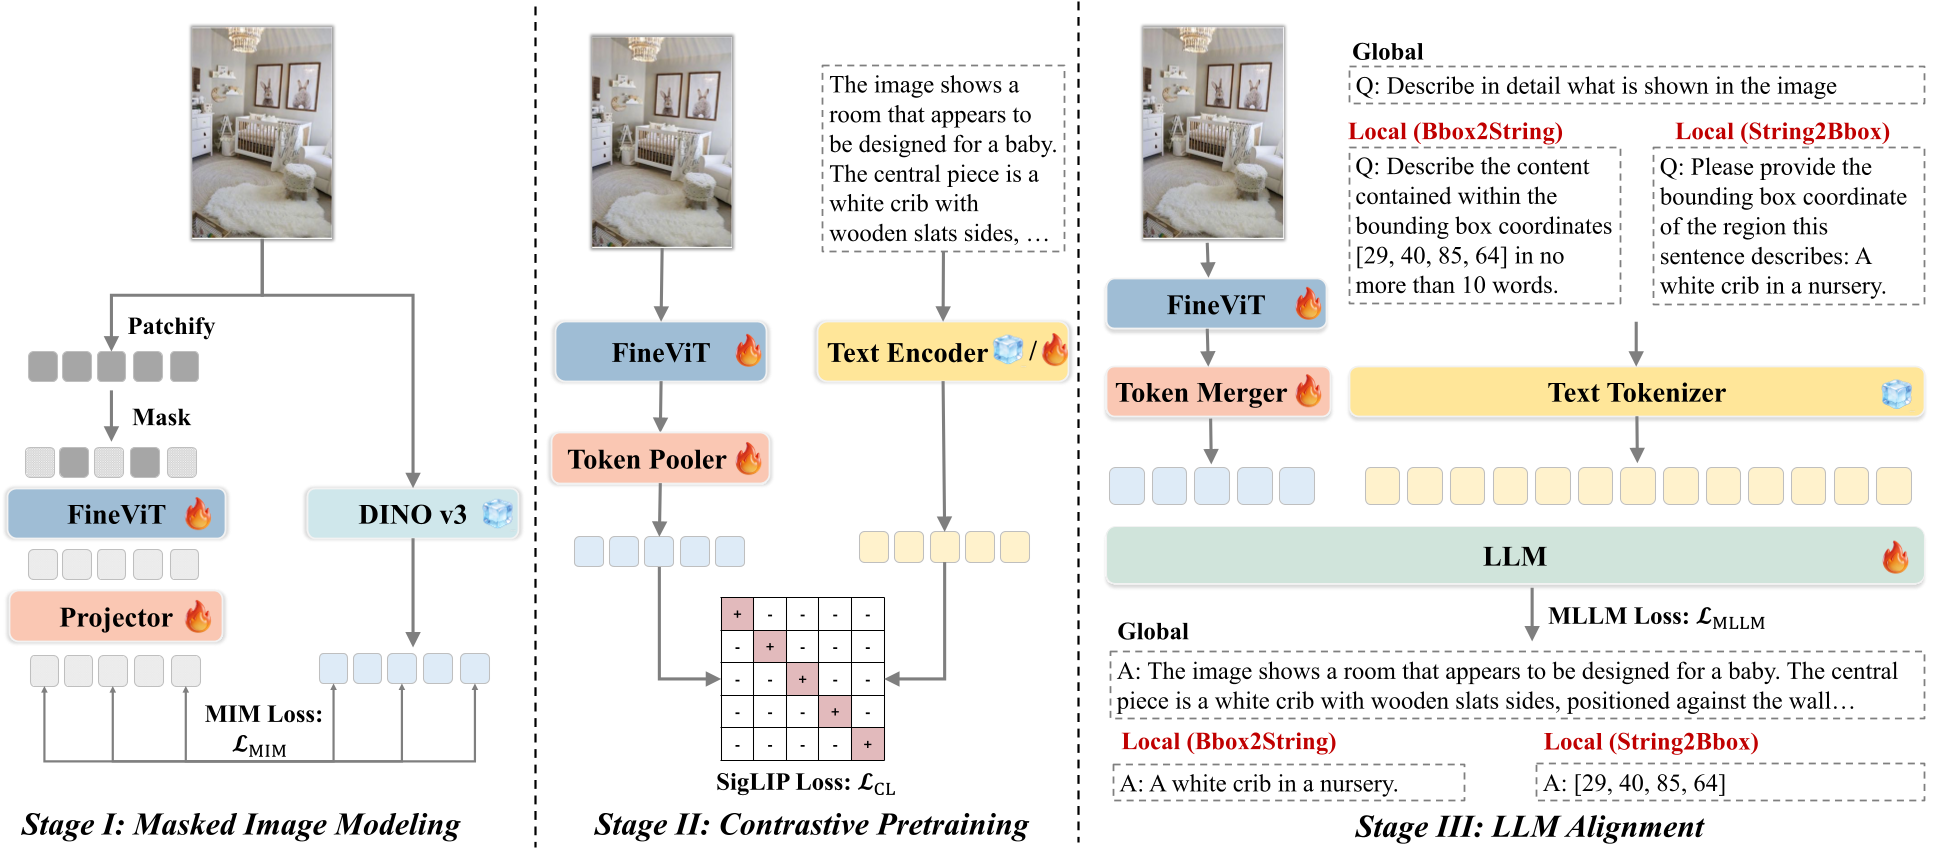 图 1:FineViT 的三阶段训练流程:MIM 学习结构、对比学习学习语义、多粒度对齐学习细节。
数据工程:FineCap-450M
高质量数据是 FineViT 成功的秘密。作者并没有直接使用原始的 LAION 数据描述,而是利用 Qwen2.5 和 InternVL 等模型重新生成了极其详尽的描述。
- 全局描述:平均长度超过 200 个 Token。
- 局部描述:提取了 2.26 亿个通用物体框、1.42 亿个 OCR 区域,总计 4.54 亿个带坐标的描述对。
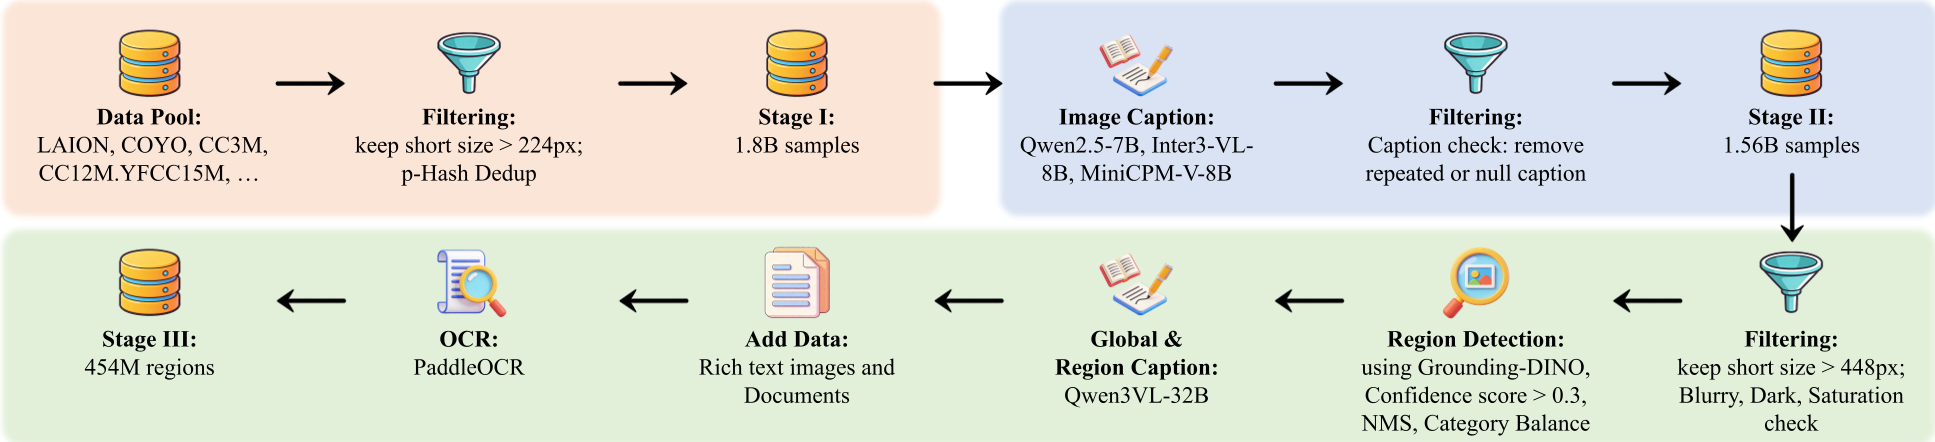 图 2:自动化的多粒度数据标注流水线。
实验战绩:局部感知的全面飞跃
1. 长文本检索的绝对优势
传统的 CLIP 在处理超过 77 个 Token 的描述时会丢失信息。在 DCI 数据集(超详细描述检索)中,FineViT 的表现令人震惊:其 T2I 检索得分高达 84.8%,比专门优化过的 FixCLIP 还要高出 10 个百分点。
2. MLLM 的核心引擎
当作为视觉插件接入 LLM(如 Qwen3-1.7B)时,相比基线模型 SigLIP2,FineViT 在 OCR 和定位任务上表现出了降维打击般的优势:
- DocVQA (文档理解):提升 +18.52%
- CountBench (物体计数):提升 +18.69%
 表 1:不同 LLM 规模下的性能对比。显而易见,FineViT 在 Local 任务中完胜。
深度洞察:为什么 FineViT 有效?
作者在消融实验中发现了一个关键结论:反冻结视觉编码器对感知至关重要。 在处理通用 VQA 任务时,冻结视觉权重也许够用;但一旦涉及复杂的 OCR 或精确坐标定位,Unfrozen(解冻)训练能带来巨大的性能增益。这意味着 FineViT 的视觉表示是在训练过程中被“重塑”以适应精细空间任务的。
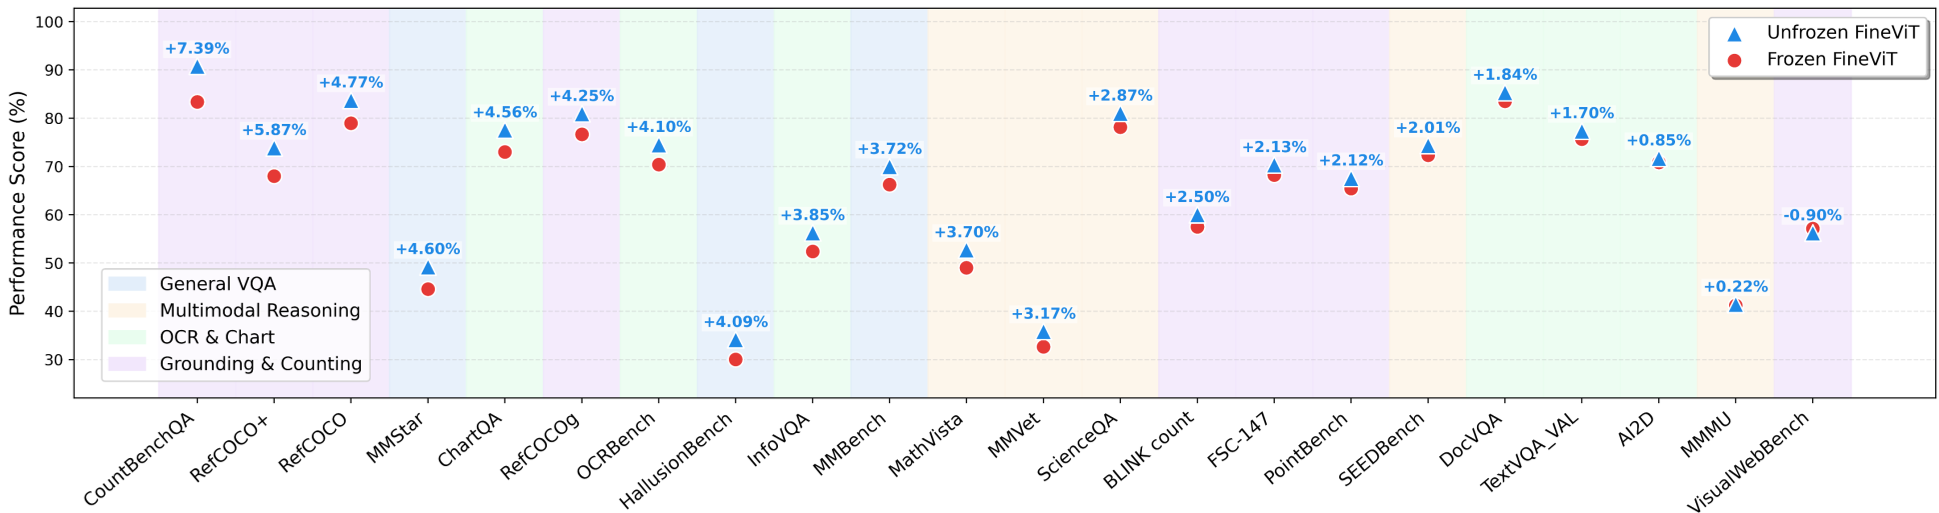 图 3:解冻视觉骨干网络在局部感知任务(Local tasks)中收益最大。
总结与启示
FineViT 的出现标志着视觉编码器从“语义对齐”向“感知增强”的跨越。其核心启示是:
- 数据质量 > 数据数量:通过 MLLM 回头去“重刷”旧数据,其价值远高于盲目扩充脏数据。
- 三阶段范式:从基础结构到全局语义,再到局部感知,这种循序渐进的优化逻辑可能成为未来视觉基础模型的标准工作流。
局限性:目前 FineViT 仍侧重于静态图像,视频领域长序列的细粒度细节捕捉将是下一个战场。