
FLAS:突破转向向量限制,用“流”精准操控大模型行为
Beyond Steering Vector: Flow-based Activation Steering for Inference-Time Intervention
本文提出了 FLAS (Flow-based Activation Steering),这是一种用于推理时微调大语言模型(LLM)行为的流式激活控制方法。FLAS 通过学习概念条件的连续速度场,在 Gemma-2 系列模型上首次实现了性能超越 Prompting 的 Steering 效果,且具备极强的零样本泛化能力。
TL;DR
在控制大语言模型(LLM)输出风格或内容时,传统的“转向向量”(Steering Vector)往往力不从心。本文提出的 FLAS (Flow-based Activation Steering) 抛弃了简单的向量加法,引入了基于 速度场计算 的多步积分干预机制。它不仅在 AxBench 评测中首次全面超越了 Prompting,还揭示了 LLM 激活空间极其复杂的非线性几何特性。
1. 为什么“转向向量”不够好?
目前的激活转向方法(如 CAA, ReFT 等)大多基于几个未经严格验证的假设:
- 线性假设:认为概念在激活空间中是线性分布的。
- 单步假设:修正是一次性完成的。
- 位置无关:对 Prompt 中的所有 Token 应用相同的修改。
然而,斯坦福等机构发布的 AxBench 评测显示,这些方法在应对数千个自然语言概念时,效果往往不如一段简单的“提示词(Prompting)”。更糟糕的是,当你试图加大转向强度时,模型往往会变得语无伦次,丧失指令遵循能力。
2. 核心机制:从“向量”进化到“速度场”
FLAS 的直觉非常深刻:如果我们将原始激活值 看作起点,目标概念激活值 看作终点,它们之间的路径不应该是直线,而是一条由 速度场 引导的曲线。
2.1 模型架构详解
FLAS 引入了一个名为 FlowBlock 的模块。其核心流程如下:
- 概念编码:使用冻结的 Concept Encoder 将文字描述(如“使用数字格式”)转为引导向量。
- 多步 Euler 积分:不像传统方法直接加一个向量,FLAS 将干预分为 个微小步骤(通常 )。每一步都会根据当前的激活状态和时间 计算一个新的速度。
- 自适应干预:因为速度场取决于当前位置,所以即使是同一个概念,不同的输入 Prompt 也会产生完全不同的转向轨迹。
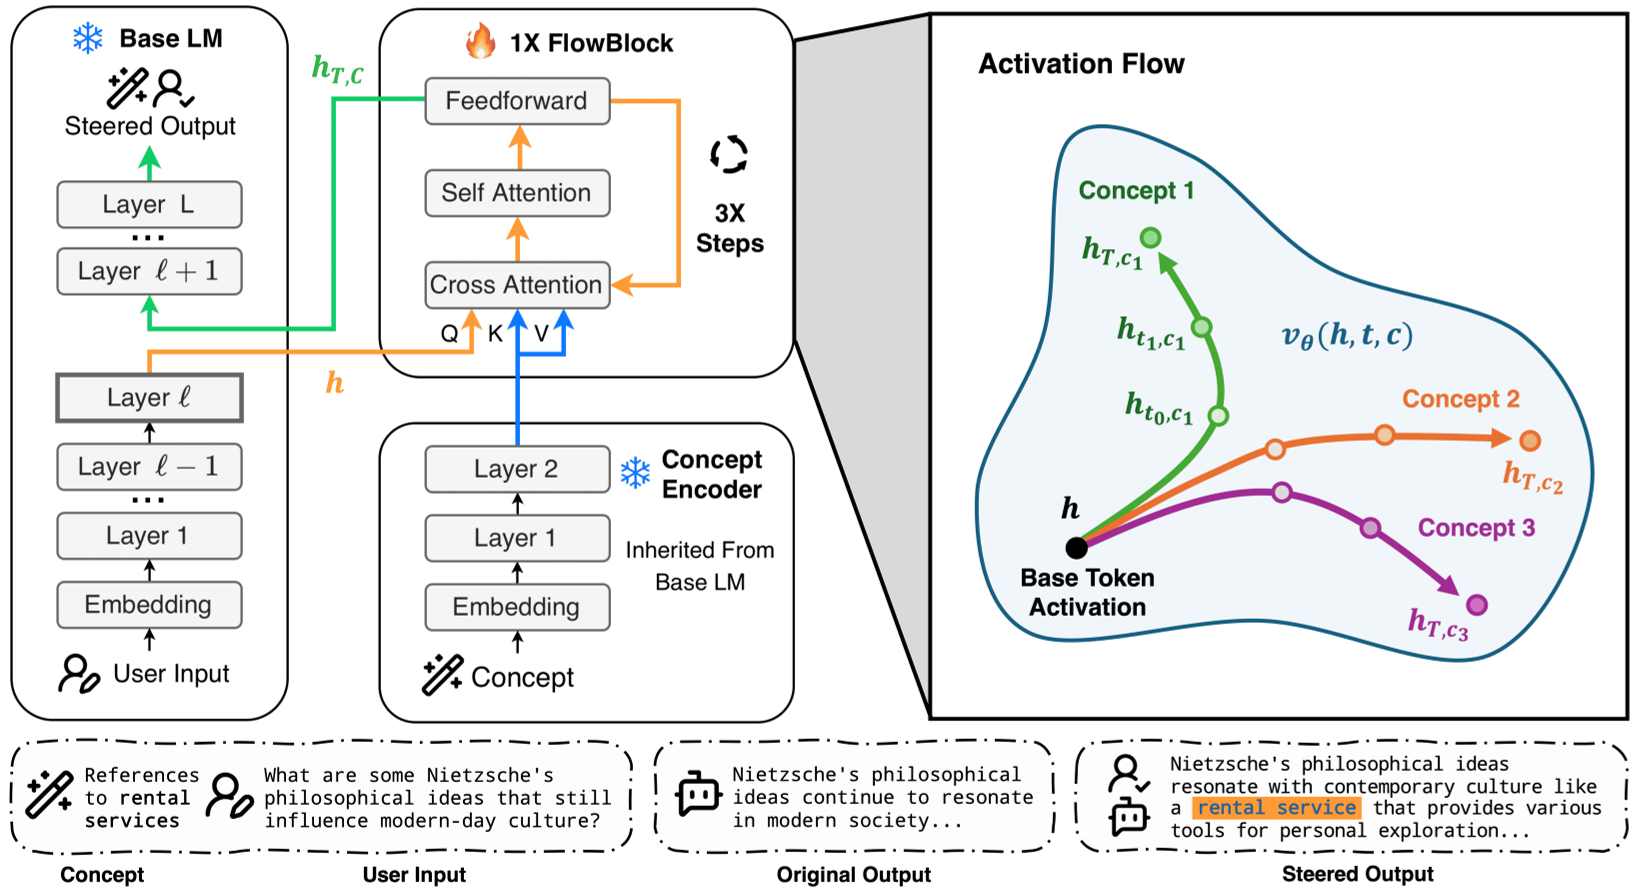 图 1:FLAS 整体架构。FlowBlock 插入在预训练 LLM 的某层(如第 20 层),通过交叉注意力机制吸收概念信息。
3. 实验战绩:首次击败 Prompting
在 Gemma-2-2B-IT 和 9B-IT 上的实验结果是令人振奋的。FLAS 是第一个在零样本(Zero-shot)概念转向任务中持久超越人工 Prompting 的学习类方法。
- 性能跨越:在 9B 模型上,FLAS 的 HMean 达到 1.113(Prompting 仅 1.091)。
- 稳定性与鲁棒性:如图 4 所示,传统方法(如 AcT, ReFT)在强度增加时性能会迅速崩溃(Fluency 掉零),而 FLAS 能够随着强度 的增加,在强化概念的同时保持极佳的语言质量。
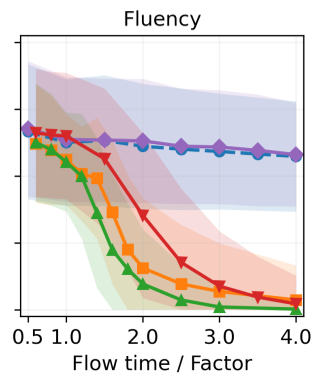 图 4:转向强度与性能的 Trade-off。蓝色曲线(FLAS)在强度增加时,概念得分稳步上升,而流畅度几乎不下降。
4. 深度洞察:激活空间是弯曲的
作者通过可视化发现了一个惊人的事实:所有的转向轨迹在初始阶段都会沿着一个共同的方向“起跑”,经过一个明显的弯曲后,才进入各自概念的特异性区域(见图 6)。
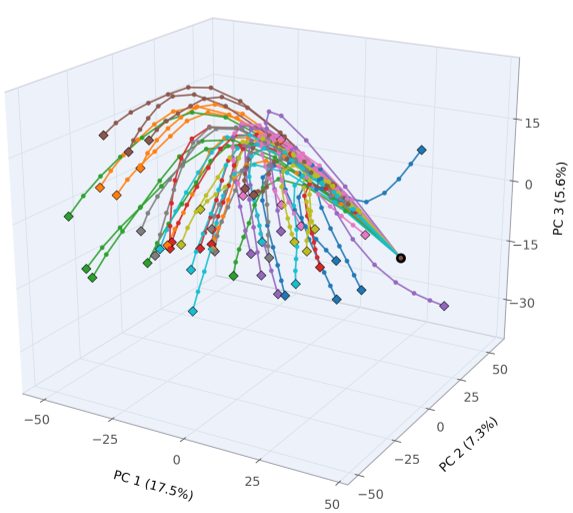 图 6:PCA 降维后的转向轨迹。可以看到明显的弯曲特征,这解释了为什么单步线性方法效果不佳。
此外,FLAS 还会对序列中不同的 Token 进行非均匀的修正。实验观察到,生成的 Token 与 Prompt 中的 Token 在激活空间受到的干预方向存在显著差异,这种**位置敏感性(Position-sensitivity)**是 FLAS 成功的关键。
5. 总结与反思
FLAS 的出现标志着激活干预从“经验主义的向量相加”迈向了“系统性的流体力学建模”。它证明了:
- 多步积分对于捕获复杂的非线性路径至关重要。
- **多样性损失(Diversity Loss)**能有效防止不同概念的干预方向坍缩。
- 推理开销可控:虽然增加了少量计算延迟,但相比于微调全参数,这种轻量级的 FlowBlock 方案更具工程价值。
局限性:目前 FLAS 仍需针对特定模型进行训练,且干预主要集中在单层。未来如何实现跨模型迁移以及多层联合干预,将是该领域的下一个焦点。