
[arXiv 2026] Foveated Diffusion: 像人眼一样思考,让视觉生成效率翻倍
Foveated Diffusion: Efficient Spatially Adaptive Image and Video Generation
本文提出了 Foveated Diffusion,一种受人类视觉系统启发的空间自适应图像和视频生成框架。该方法通过在用户注视点(Fovea)分配高密度 Token,而在边缘区域使用低密度 Token,实现了在保持视觉感官无损的同时,将图像生成加速 2 倍,视频生成加速 4 倍。
TL;DR
斯坦福大学研究团队提出了一种名为 Foveated Diffusion 的新范式。它不再傻瓜式地均匀渲染每一个像素,而是模拟人眼的“中央凹(Fovea)”特性:在注视点区域生成高精度细节,在边缘区域则使用低分辨率。该方法通过改进分布式 RoPE 和一致性后训练,在不损失感官质量的前提下,实现了 2x(图像)到 4x(视频) 的实质性加速。
背景定位:生成式领域的“视网膜级”优化
虽然 DiT (Diffusion Transformer) 已经成为图像和视频生成的标配,但其注意力的二次复杂度始终是通往“实时高画质”路上的大山。Foveated Diffusion 的出现,将计算机图形学中成熟的 Foveated Rendering(凹槽渲染) 理念引入了生成式 AI。这不仅仅是一个工程技巧,更是一次从“像素完全对齐”向“感知完全对齐”的范式转移。
核心痛点:为什么“缝合”不灵了?
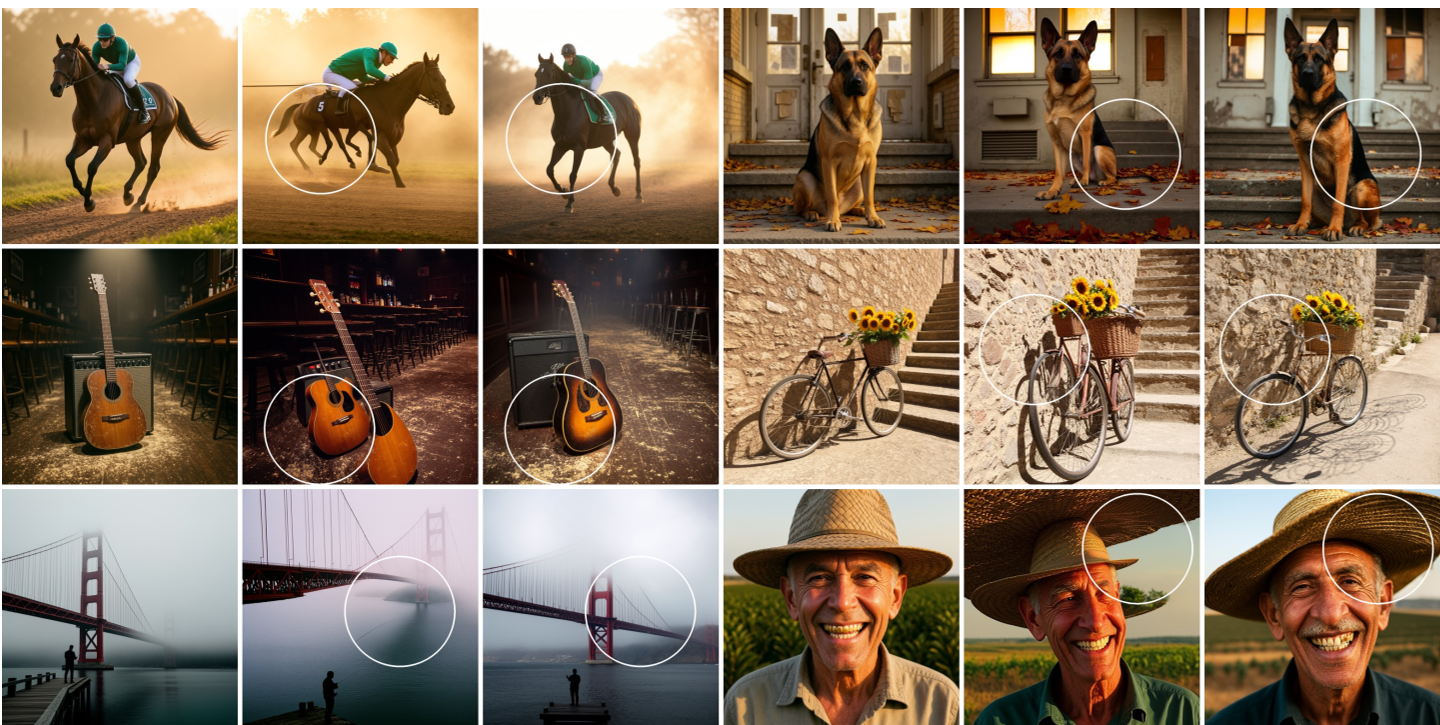
如果直接把高分辨率中心块和低分辨率边缘块拼在一起进行去噪(即文中提到的 Naive Mixed-res),模型会产生严重的结构偏离:边缘长出的物体可能和中心完全不搭,甚至出现物体被截断或重复的伪影(如下图所示)。这是因为预训练的 DiT 习惯于在均匀格点上工作,位置编码和特征尺度在非均匀布局下会彻底失效。
方法论:Foveated Diffusion 的三个支柱
1. 混合分辨率 Token 化 (Mixed-Resolution Tokenization)
作者定义了一个二值掩码 。在注视点区域保留原始 的 Token 密度,而在外围,将 的区域聚合成一个 Token。这样,整个序列长度 显著缩短,计算量呈平方级下降。
2. 相位对齐 RoPE
为了让注意力机制能正确理解不同分辨率 Token 之间的相对位置,模型修改了 Rotary Positional Embeddings (RoPE)。当高分辨率 Query 寻找低分辨率 Key 时,通过归一化索引打破网格不匹配,确保空间语义的连续性。
3. 一致性后训练 (Post-training)
这是本文的杀手锏。作者利用预训练 VAE,分别提取高分辨率图像和下采样图像的 Latent。通过 Merge 操作,在训练阶段就构建出“本身就一致”的混合分辨率目标。模型在这一目标下进行微调(使用 LoRA),从而学会在推理时自动缝合不同尺度的特征。

实验战绩
在 NVIDIA H100 上的测试显示,随着 Token Ratio 的下降,推理延迟几乎是线性缩短的。
- 性能:在视频生成任务中,Token 数减少到 25% 时,速度直接起飞(3.5x+ 加速)。
- 主观质量:用户调研显示,在模拟眼动环境下,用户根本无法分辨哪个是全分辨率生成的,哪个是 Foveated 生成的。

深度洞察:不仅仅是为了快
这篇论文最令人兴奋的应用方向在于 Saliency-guided(显著性引导) 生成。通过结合显著性检测模型,Foveated Diffusion 可以自动将算力集中在图像中的关键主体(如机器人手臂、游戏中的武器、驾驶场景中的行人和车辆),而背景则淡化处理。
未来,该技术极有可能被直接嵌入到 VR/AR 系统的底层硬件驱动中。当你的眼睛看向哪里,生成模型就即时在那里爆发算力。
局限性与展望
尽管表现卓越,但在注视点边缘有时会看到轻微的颜色断层(Color Artifacts),这源于 VAE 解码时的 Alpha Blending。作者指出,未来的终极方案可能是开发一个原生支持混合分辨率 Token 的 VAE。
总结:Foveated Diffusion 证明了,在算力受限的时代,学会“偷工减料”且不被发现,才是高效 AI 的必修课。