
FD-loss:打破评估与训练的边界,直攻 FID 核心
Representation Fréchet Loss for Visual Generation
本文提出了 FD-loss,一种将 Fréchet Distance (FD) 直接作为视觉生成模型训练目标的方法。该方法通过解耦统计样本量与梯度计算批次大小,实现了分布式距离的高效优化。在 ImageNet 256x256 上,该方法助力单步生成器达到 0.72 FID 的 SOTA 战绩。
TL;DR
在视觉生成领域,FID (Fréchet Inception Distance) 一直是衡量模型好坏的“金标准”,但它通常只作为赛后评委,而非教练。本文提出的 FD-loss 成功实现了直接优化 FD 的壮举。通过一种极简的“解耦”策略,FD-loss 不仅大幅刷新了单步(One-step)生成的质量记录,还揭示了过度依赖 Inception 特征空间进行评估的局限性。
痛点深挖:评委为什么不能当教练?
为什么我们不早点直接优化 FID?核心矛盾在于统计尺度(Statistical Scale)。
- 评委需要全局观:要算对 FID,通常需要 50,000 张图像来估算均值和协方差。
- 内存无法支撑:训练时的 Batch Size 通常只有几百或一千。如果你直接对这几百张图算 FD,算出来的统计量极其不稳定,甚至无法支撑高维协方差矩阵的满秩计算。
- 后果:强行在小 batch 上优化 FD 会导致生成器“为了降分而降分”,产生严重的 Artifacts 和颜色异常。
核心机制:解耦(Decoupling)的艺术
作者提出的 FD-loss 给出了一个简单而优雅的解法:统计归统计,梯度归梯度。
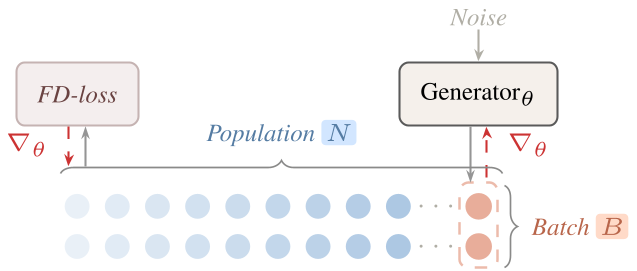
具体实现包括两种变体:
- Queue-based (队列式):维护一个数万规模的特征队列,新生成的图像特征入队,旧的出题。FD 的计算基于整个大队列,但梯度只回传给当前的 Batch。
- EMA-based (均值移动式):不存特征,而是维护一阶和二阶矩(均值和协方差的中间体)的指数移动平均。
这种设计确保了用于定义“分布”的样本量足够大,同时保证了计算效率。
实验与结果:多维度的降维打击
1. 刷新单步生成上限
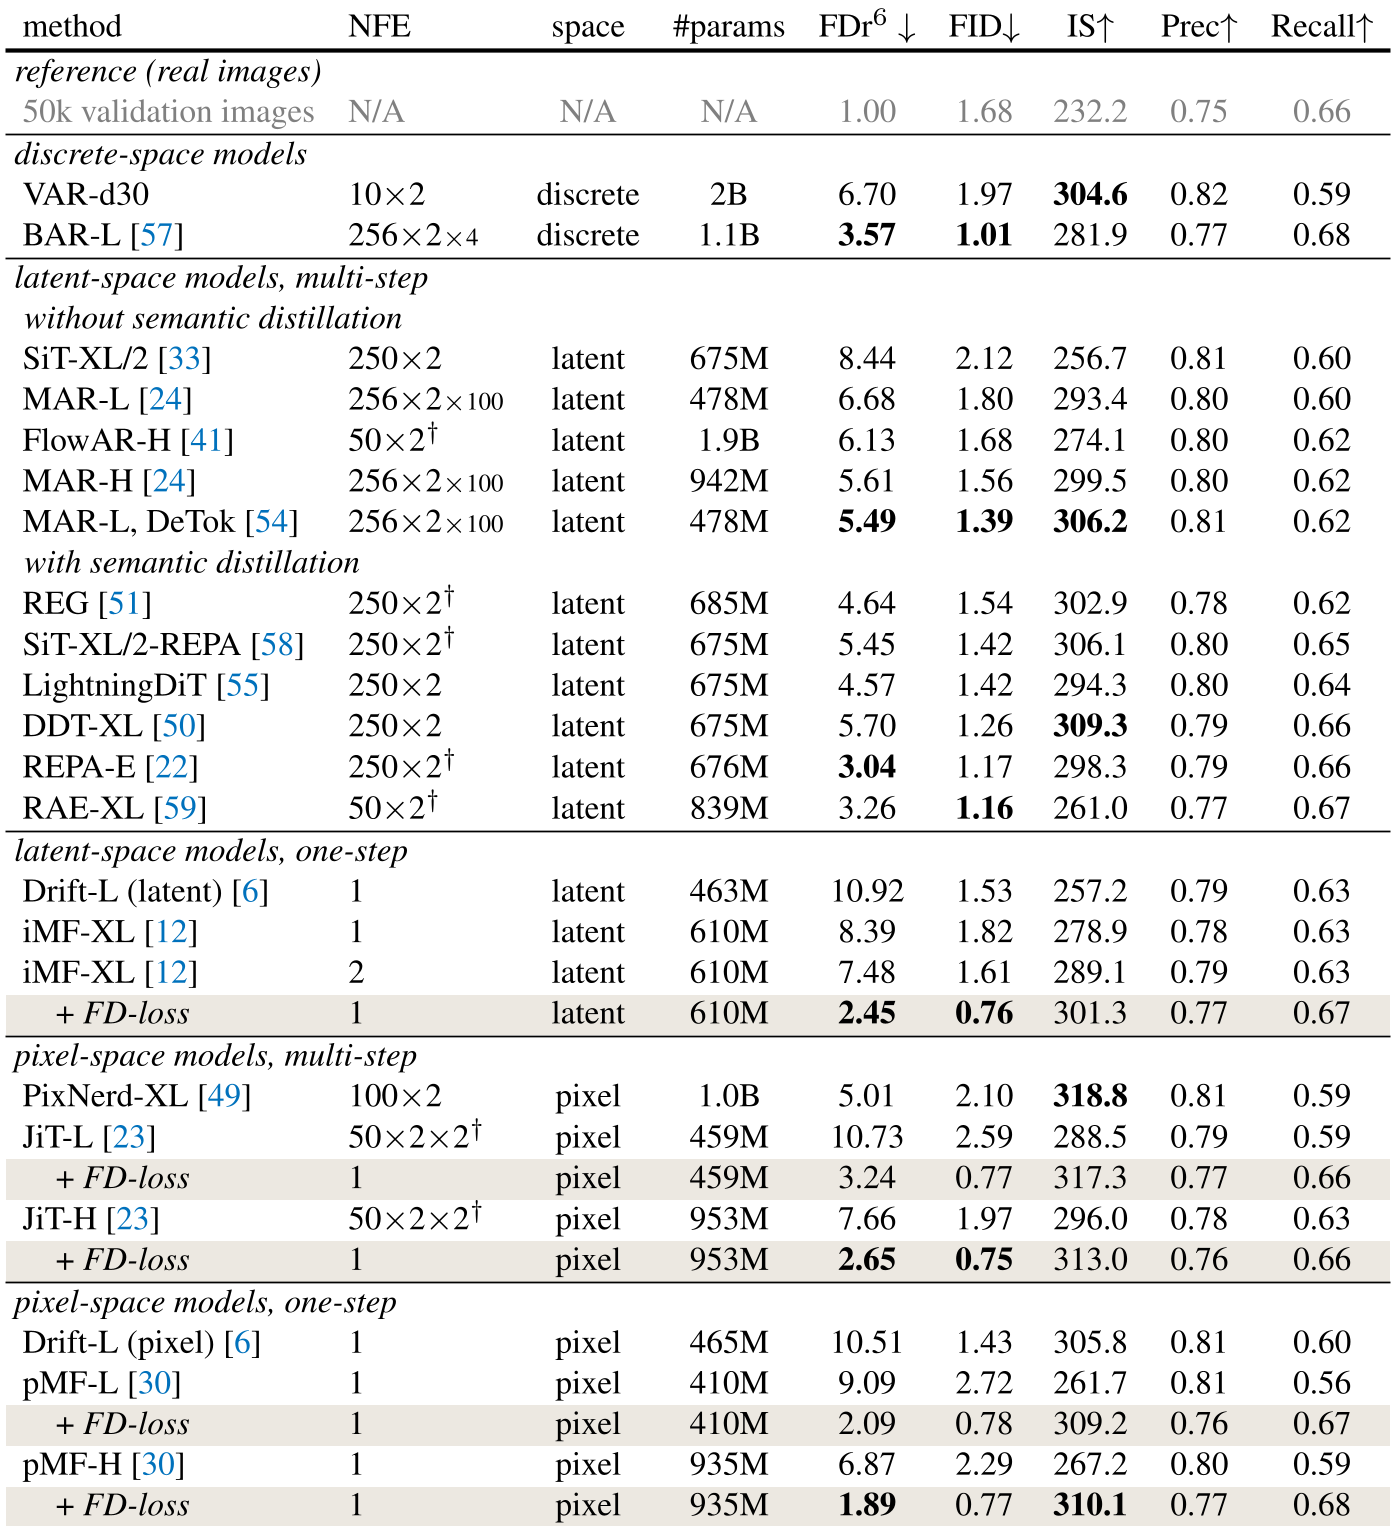
在 ImageNet 256x256 分辨率下,FD-loss 配合单步生成器(如 pMF),实现了 0.72 FID 的惊人表现。这意味着单步生成已经开始在指标上逼近甚至超越高代价的多步扩散模型。
2. 免费的“模型改造”
最令人惊讶的发现是,FD-loss 具有某种“万能适配器”的属性。作者直接拿出一个训练好的多步扩散模型(如 SD3.5 Medium),在最后一步强行让它生成图,初始质量极差(FID > 200)。但在 FD-loss 仅 50 epoch 的微调下,它迅速转化为极其出色的单步生成器,完全不需要复杂的知识蒸馏(Distillation)或对抗训练。
深度洞察:FID 真的“解决”了 ImageNet 吗?
作者提出了一个扎心的观察:很多 SOTA 模型的 FID 已经比真实图片的验证集还要低了,但人眼看过去,生成图一眼假。
- 原因:Inception 表征空间太老了(基于分类任务),存在视觉盲区。
- 对策:作者引入了 FDr6 指标,综合了 DINOv2, CLIP, SigLIP 等 6 种现代特征。
- 启示:当你直接优化 Inception FID 时,模型会发生“Reward Hacking”,即分数提高了,但物体结构可能还不如那些 FID 稍高但使用了现代特征预训练的模型。
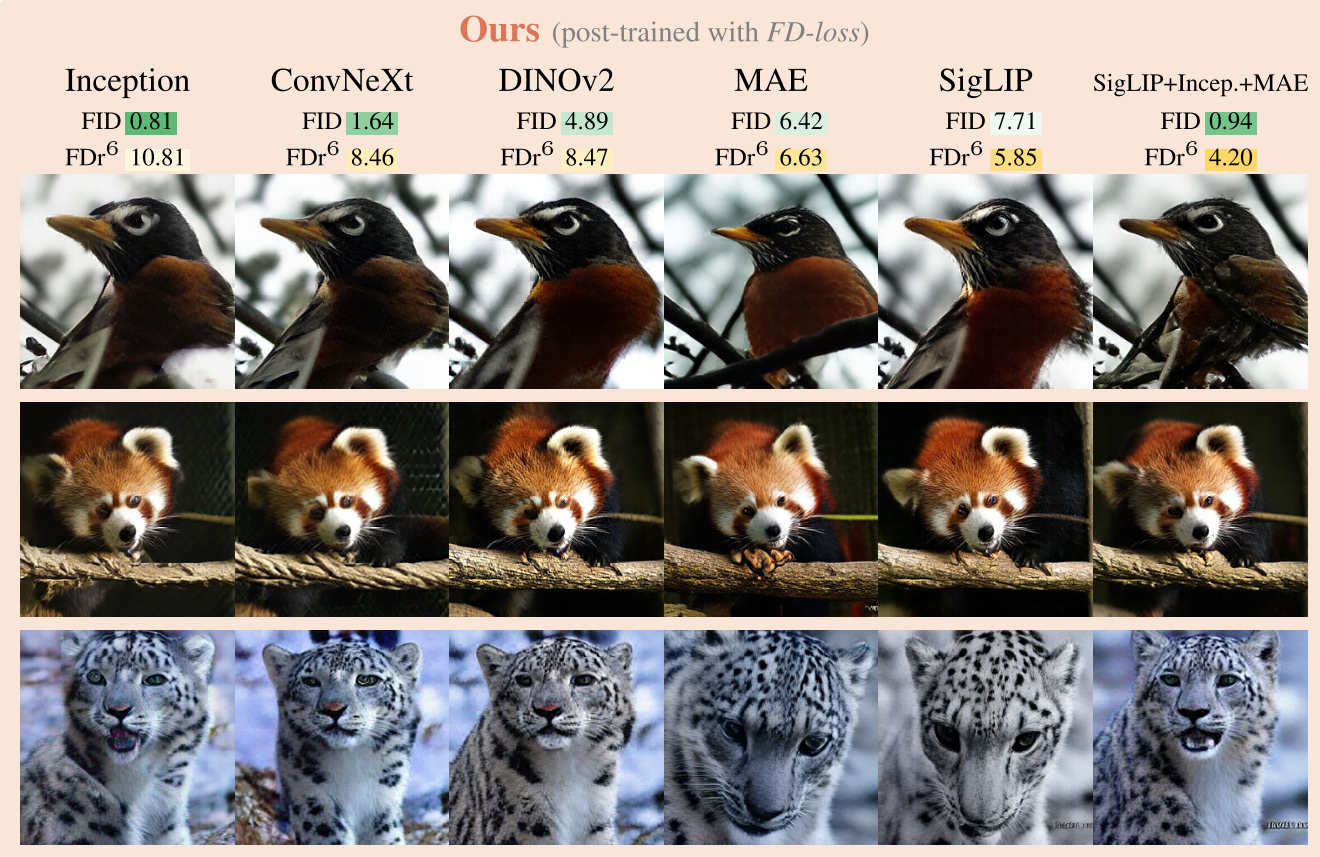 (注:如上图所示,优化 Inception 空间的模型虽然 FID 只有 0.81,但物体结构的合理性往往不如结合了 SigLIP 等特征的模型。)
总结与局限性
FD-loss 的成功告诉我们:分布匹配本身就是一个极强的弱监督信号。只要解决了梯度估计的稳定性,我们就可以摆脱“像素级”或“单样本级”的束缚。
然而,该方法也存在局限性。正如 Goodhart's Law 所言:“当一个指标变成目标,它就不再是一个好指标了。” 虽然作者引入了多表征空间来对抗 Hacking,但本质上依然是在优化若干个预定义的 Proxy。未来,如何动态地、自适应地选择表征空间,将是视觉生成领域的一个重要命题。