
FreqFlow:破解 Flow Matching 的“频谱迷雾”,频率感知助力超高质量图像生成
Frequency-Aware Flow Matching for High-Quality Image Generation
本文提出了 FreqFlow,一种频率感知的 Flow Matching 生成框架。该方法通过在 Latent 空间引入双分支架构,并利用时间相关的自适应权重显式建模高低频分量,在 ImageNet-256 任务上达到了 SOTA 的 1.38 FID,超越了 DiT 和 SiT。
TL;DR
传统的 Flow Matching 模型在生成图像时存在“频率盲区”,即对全局结构与微观纹理的恢复缺乏显式区分。FreqFlow 另辟蹊径,提出了一种双分支架构:一个频率分支专门负责拆解和重组高低频信号,另一个空间分支负责接收信号并渲染最终像素。实验证明,这种“看透频率”的生成方式在 ImageNet 基准上横扫了包括 DiT 在内的多类 SOTA 模型。
背景定位
目前生成模型界存在三足鼎立:Diffusion (扩散模型)、Autoregressive (自回归) 和 Flow Matching (流匹配)。Flow Matching 因其更平滑的训练动力学和确定性推理轨迹正备受关注。然而,作者发现即使是强如 SiT 的模型,在恢复高频细节时依然会显得力不从心——这源于噪声注入在频谱上的不均匀分布,模型在“什么时候该画骨骼,什么时候该画皮肤”上缺乏显式指挥官。
痛点深挖:消失的高频细节
在生成过程中,模型通常遵循“先结构后细节”的客观规律,但现有的 Flow Matching 模型仅仅在空间域(Spatial Domain)操作。作者通过傅里叶变换分析发现,模型在推理初期(t 较大时)确实在处理低频分量,但随着时间推移,高频分量的恢复误差显著高于低频分量。换句话说,模型是在凭感觉“盲画”纹理。
FreqFlow:频率感知的二重奏
为了解决这一问题,FreqFlow 提出了核心架构革新:
1. 双分支设计 (Two-branch Architecture)
- 频率分支 (Frequency Branch):采用 Vision Transformer (ViT) 作为骨干,将 noisy latent 分选为高通和低通两类,通过傅里叶变换显式预测各自的流场(Velocity Field)。
- 空间分支 (Spatial Branch):采用 ConvNeXt 结构,更擅长处理局部细节,并将频率分支的预测结果作为 conditioning 注入。
2. 自适应频率整合 (Adaptive Frequency Integration)
这是一个极其精妙的设计。作者引入了一个随时间 变化的权重参数 :
- 生成早期: 偏向低频,模型集中力量构建图像的大门、轮廓和色调。
- 生成后期: 转向高频,专注于锐化边缘和补充质感。
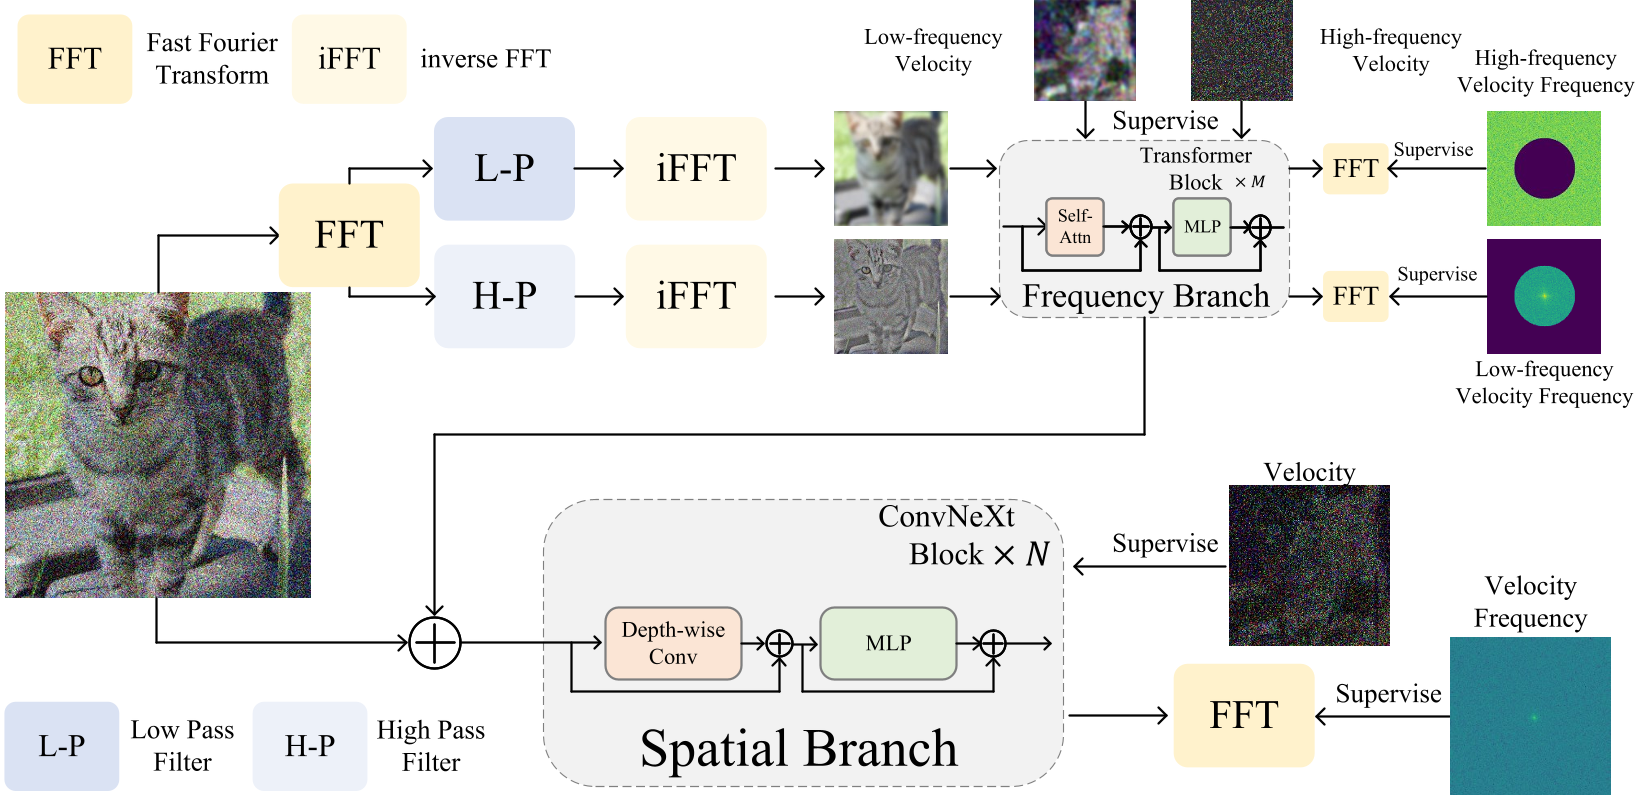 图 1:FreqFlow 架构概览,展示了频率分支如何通过 DFT/IDFT 与空间分支协同工作。
实验与结果
在 ImageNet-256 这一硬核榜单上,FreqFlow 展现了统治级的效率:
- SOTA 性能:FID 达到 1.38,这一成绩不仅超越了同门师兄弟 SiT (2.06 FID),还压制了同参数量级的自回归模型和扩散模型。
- 参数效率:FreqFlow-L (507M) 就能打赢 DiT-XL/2 (675M),证明了引入频率先验能显著降低模型学习的负担。
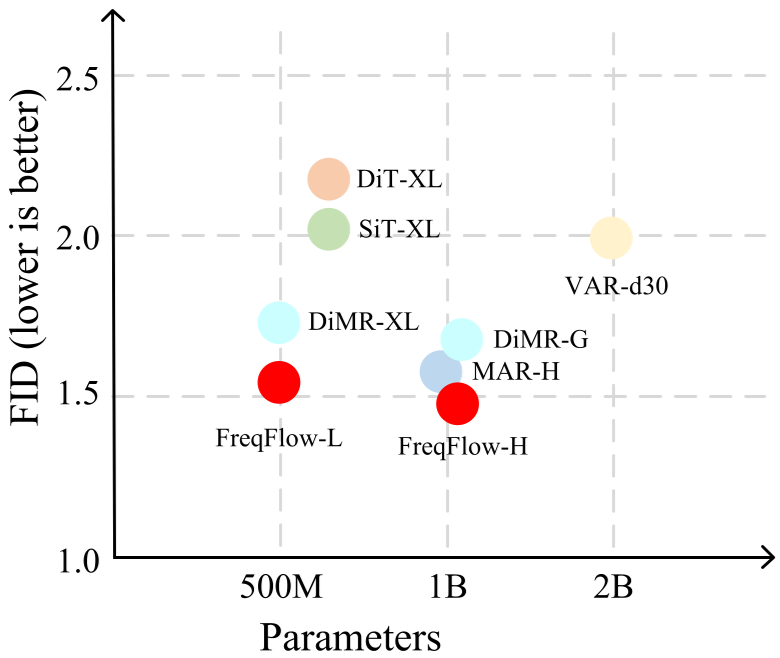 图 2:参数量与 FID 对比图。FreqFlow 在更低的参数消耗下实现了更低的 FID。
深度洞察:为什么双域监督有效?
除了架构外,作者还引入了双域监督(Dual-domain Supervision)。在 Loss 计算时,不仅看生成的像素像不像( Loss),还看生成图像的频谱分布和原图是否契合。这种“双管齐下”的方法有效缓解了模型生成样本中常见的过度平滑(Smoothing)问题。
总结与 Outlook
FreqFlow 的成功揭示了一个深刻的道理:虽然深度学习提倡 End-to-End,但对于物理意义明确的信号特征(如频率),显式的 Inductive Bias(归纳偏置)依然是提升模型性能的捷径。
目前 FreqFlow 的最大规模仅为 1B。考虑到其优异的频谱对齐能力,未来将其扩展至超大规模参数、甚至应用于视频生成中解决闪烁(高频时间抖动)问题,将是非常值得期待的方向。