
GMP:学会“断舍离”——让机器人策略精准掌握长短期记忆
Gated Memory Policy
本文提出了 Gated Memory Policy (GMP),一种专门为机器人操纵任务设计的长记忆视觉运动策略。GMP 通过引入学习型记忆门控机制和跨注意力(Cross-Attention)模块,在 MemMimic 等非马尔可夫任务上取得了 30.1% 的成功率提升,且在传统马尔可夫任务中保持了极高的鲁棒性。
TL;DR
斯坦福大学的研究团队提出了一种名为 Gated Memory Policy (GMP) 的新框架。它解决了机器人学习中的一个经典悖论:为什么给模型更多的历史信息,它反而变笨了?GMP 通过一个记忆门控机制实现了“按需取用”历史,并结合扩散噪声增强显著提升了模型在复杂、长程任务中的表现。
痛点深挖:历史信息是良药还是毒药?
在机器人操纵(Robotic Manipulation)中,任务对记忆的需求跨度极大:
- 马尔可夫任务(Markovian):如简单的取放(Pick-and-place),看一眼当前画面就能动手,历史信息反而是干扰。
- 非马尔可夫任务(Non-Markovian):如根据之前的尝试调整力度(Cross-trial),由于无法直接感知摩擦力等物理属性,必须依赖历史经验。
然而,现有的方法如 Diffusion Policy,在简单增加输入窗口(History Context)后,往往会出现过拟合(Overfitting)。模型变得异常敏感,一旦历史数据中出现一点点噪声或分布偏移,整个序列的特征就会崩溃,导致机器人在简单任务上也会“翻车”。
核心方法:GMP 的三位一体架构
GMP 的设计直觉非常明确:不仅要学会 Recall 什么,更要学会何时进行 Recall。
1. 记忆门控:智能开关
GMP 引入了一个二进制记忆门 。其核心创新在于门控校准(Calibration):
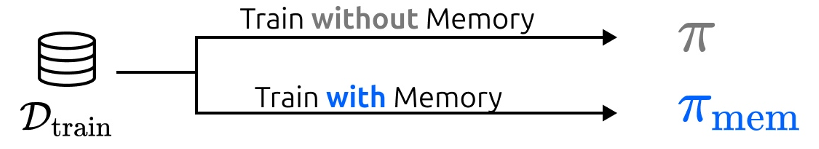
- 研究者训练了两个策略:一个完全不看历史(),一个始终看历史()。
- 通过对比它们在验证集上的动作预测误差,如果 的表现显著好于 ,则该时刻被标记为“需要记忆”。
- 最终训练一个轻量级的 MLP 来预测这个门控值,让模型即便在长历史输入下,也能在 60%-70% 的时间内保持“忽略历史”状态,确保了反应速度和稳定性。
2. 跨注意力与缓存机制
为了降低计算开销,GMP 没有像传统的 Transformer 那样将所有历史 Token 丢进去做全量 Self-Attention,而是设计了一个 Cross-Attention 模块。
- 当前观测作为 Query,历史信息作为 Key-Value。
- 这种设计将计算复杂度从 降低到了 ,使得模型可以轻松处理数千帧的历史缓存。
3. 给历史“打点马赛克”:扩散噪声增强
为了解决过拟合,GMP 在训练中对历史动作序列注入了扩散噪声(Diffusion Noise)。这种做法迫使模型不再死记硬背干净的轨迹,而是学习从模糊的历史中提取高层特征。这一策略在应对推理时的累积误差(Accumulated Error)时异常有效。
实验结果:全方位的跨越
研究团队推出了 MemMimic 评测集,涵盖了颜色匹配、迭代推拉、抛掷等极具挑战性的任务。
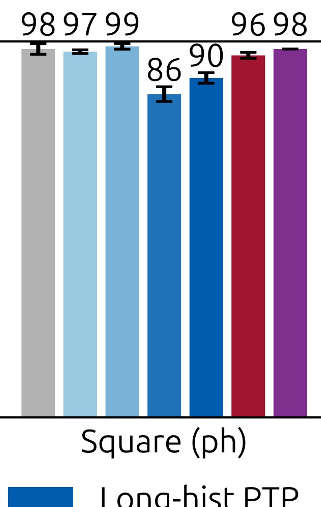
- 性能提升:在非马尔可夫任务上,GMP 比传统的 Long-hist DP 提升了 30.1%。
- 零代价升级:在马尔可夫任务(如 RoboMimic)上,由于门控的存在,GMP 几乎完美保留了基础模型的性能,没有因为引入复杂机制而“掉速”。
深度洞察
GMP 的意义在于它提供了一种系统性的优雅。它没有强行通过海量数据去磨平长序列训练的阵痛,而是通过“误差对比”这种自监督的方式,找出了记忆的真实边界。
局限性分析: 目前的 GMP 仍然依赖于固定大小的注意力窗口。这意味着虽然它比前任更强,但面对真正意义上的“无限长”任务(如长达数小时的操作流),它依然会遭遇内存瓶颈。未来的研究方向可能会转向类似于 Mamba 的选择性状态空间,或是动态的 Token 替换策略。
总结
GMP 告诉我们,一个优秀的 AI 策略不应该是一个“书呆子”,无论什么信息都全盘接收;而应该是一个敏锐的行动者,它知道什么时候该屏除杂念、只看当前,也知道什么时候该翻阅旧账、总结经验。
作者注:本文基于 Stanford University 的最新研究报告重构。