
稳定边缘的泛化:从孤立极小值到分形吸引子
Generalization at the Edge of Stability
本文提出了“锐度维度”(Sharpness Dimension, SD)来量化深度模型在“稳定边缘”(Edge of Stability, EoS)状态下的泛化能力。该方法将随机优化过程建模为随机动力系统(RDS),并证明了模型泛化误差取决于其分形吸引子的固有维度。
TL;DR
本文挑战了“平坦极小值即泛化”的传统认知,发现在现代网络常用的高学习率训练(稳定边缘, EoS)中,模型并非停在某点,而是在一个混沌吸引子上运动。作者提出了锐度维度 (Sharpness Dimension, SD),通过计算 Hessian 全谱的扩张与收缩平衡,为这种混沌体制下的泛化提供了严谨的数学界限。
1. 痛点:为什么传统的“平坦度”失效了?
长期以来,神经网络的泛化被认为与损失函数的局部平坦度(如 Hessian 迹)呈正相关。然而:
- EoS 挑战:实验发现,在模型表现良好时,Hessian 最大特征值常超过 ( 为学习率),此时动力学是振荡且不稳定的。
- 点分析的局限:在混沌体制下,优化器并不定格在某一点,而是探索一个分形集合。仅分析具体某个参数点的几何特征无法捕捉系统长期的泛化行为。
2. 核心机制:将优化视为随机动力系统 (RDS)
作者跳出了单一参数向量的视角,将随机梯度下降(SGD)建模为随机动力系统。
- 分形吸引子 (Random Attractor):在持续注入噪声和全局耗散的平衡下,系统会收敛到一个紧致集合——随机吸引子。
- Lyapunov 维度的启发:既然系统在某些方向扩张(λ > 0),在某些方向收缩,那么吸引子的“有效维度”一定小于环境参数维度 。
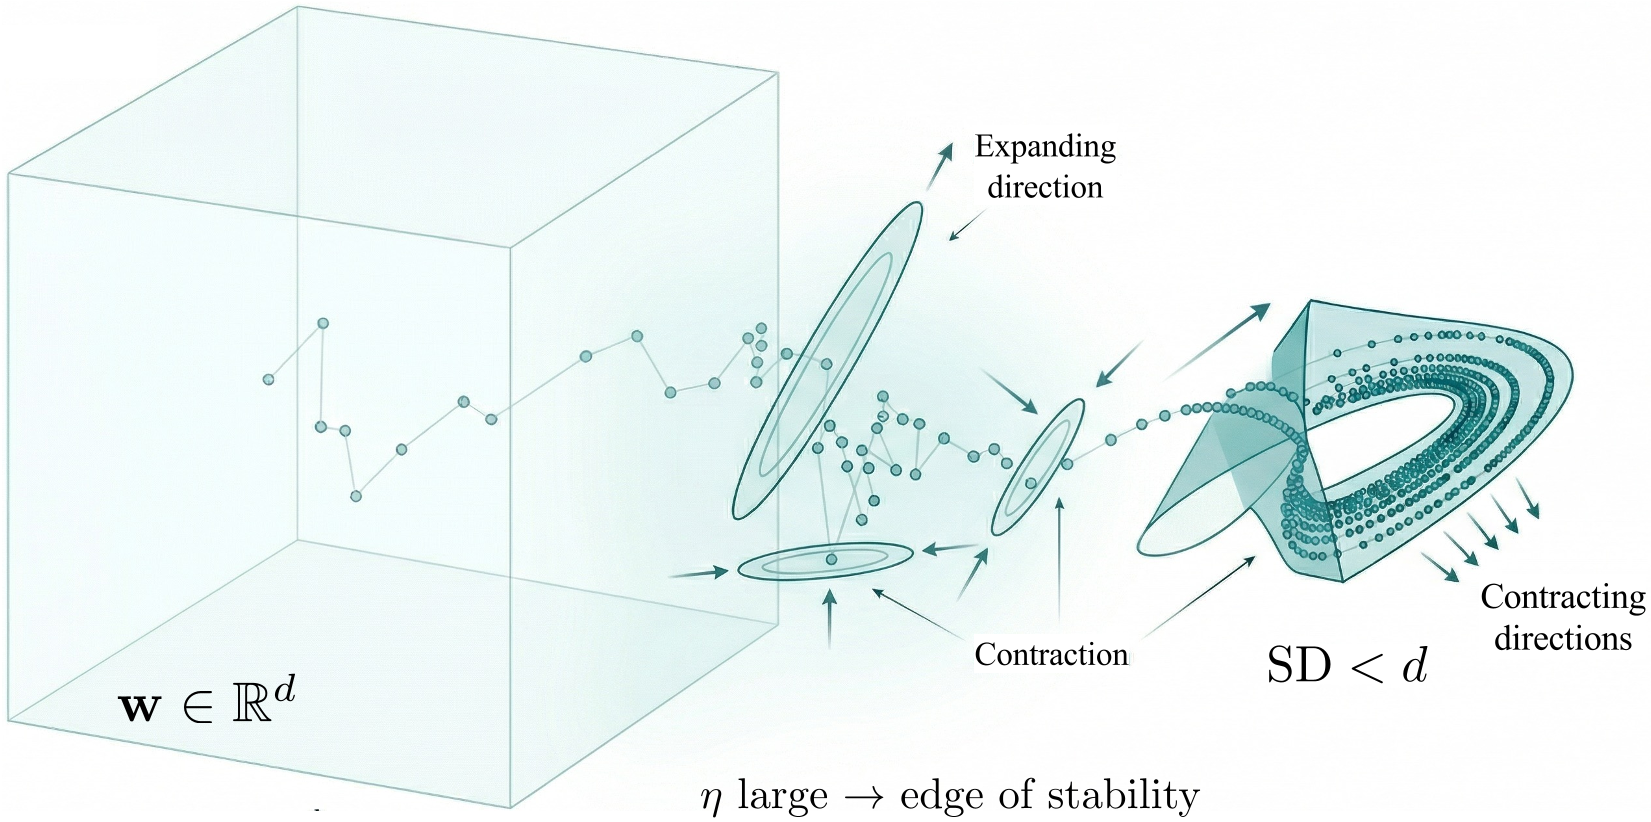 图 1: 在 EoS 制度下,泛化受控于一个低维吸引子,其维度由 SD 衡量。
3. 数学直觉:锐度维度 (SD)
SD 的定义逻辑非常精妙:它寻找一个临界点,使得前 个主方向的累积扩张率(RDS Sharpness)刚好被后续的收缩率抵消。
- 它利用了 Hessian 全谱。
- 相比于只看 的传统 Sharpness,SD 考虑了谱结构的“部分行列式” (Partial Determinants)。这解释了为何模型即便在某些方向极度不稳定,但在整体几何测度上仍能保持“低维”,从而实现泛化。
4. 实验验证:从 MLP 到 GPT-2
为了计算海量参数下的 SD,作者使用了随机兰佐斯正交化 (SLQ) 技术,避免了直接计算海森矩阵。
4.1 预测能力的降维打击
在 MNIST 任务中,传统的 PH-Dim 或 Eα 指标在 EoS 制度下表现波动。而 SD 指标与泛化误差的关联(见下图绿区)表现出极高的一致性。
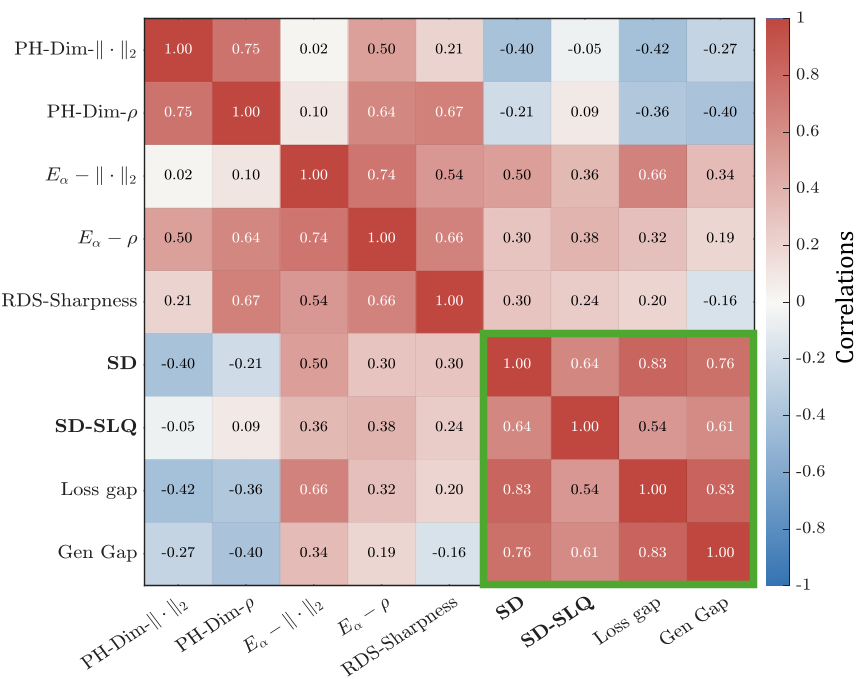 图 2: 各种指标与泛化差距的相关性对比,SD 在 EoS 区域显著占优。
4.2 捕捉“悟道” (Grokking) 的相位转变
在算法学习(如模运算任务)中,模型往往经历长时间的过拟合后突然泛化(Grokking)。实验证明,SD 能够精准识别这种突发性泛化前夕的 Hessian 频谱结构变化,比单纯看损失函数更具前瞻性。
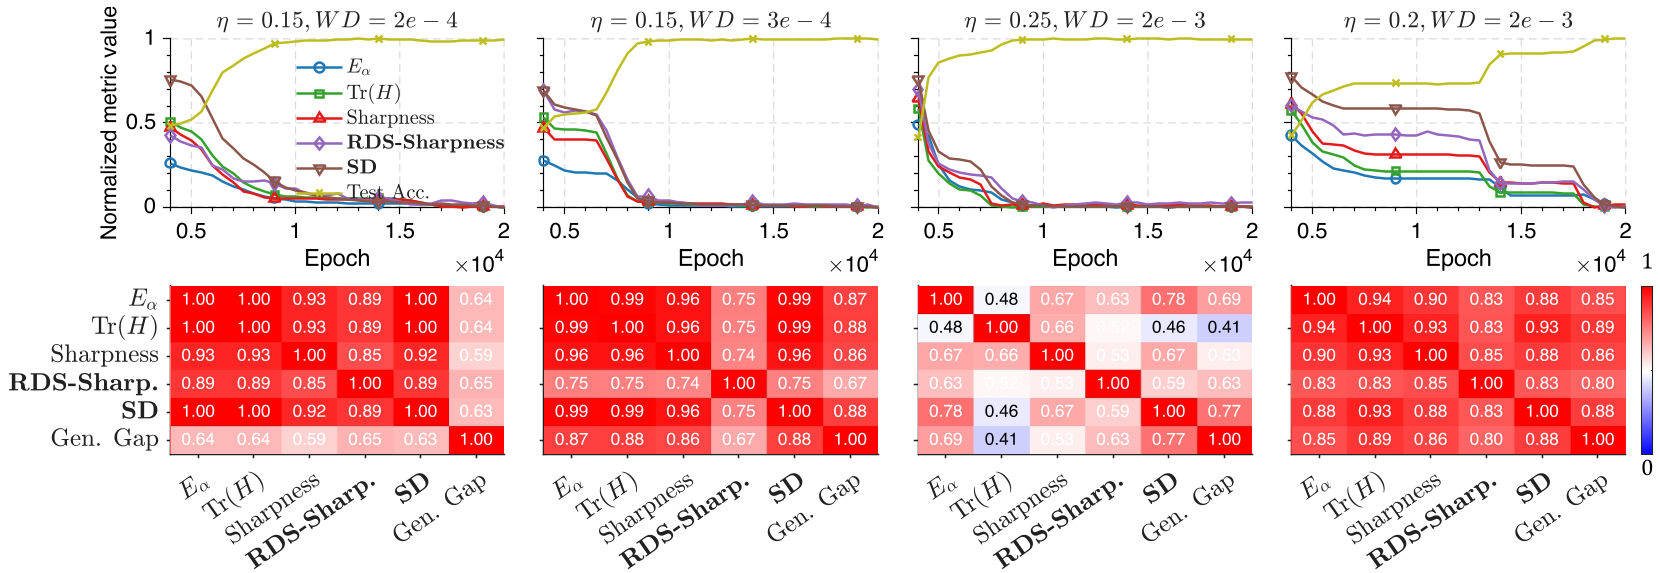 图 4: SD 指标在 Grokking 发生时的突变与测试准确率提升完全同步。
5. 深度洞察与总结
这项工作最大的贡献在于:它提供了一套工具库,将原本被视为“计算不稳”的边缘体制,转化为一种受几何测度控制的稳态特征。
- 泛化 bound:作者通过数学证明,泛化误差由 SD 量化的分形测度决定,而非参数总量。
- 局限性:尽管使用了 SLQ 优化,但在超大规模 Transformer 上计算完整全谱仍需极大算力资源。
总结: 锐度维度 (SD) 告诉我们,神经网络之所以能泛化,是因为算法在混乱的损失景观中自动“剪裁”出了一块极低维的运动场。