
[NeurIPS 2024] GVC:生成即压缩,利用预训练视频模型实现 Zero-Shot 极低码率编码
Generation Is Compression: Zero-Shot Video Coding via Stochastic Rectified Flow
本文提出了 Generative Video Codec (GVC),一种无需重新训练的 Zero-shot 视频压缩框架。该方法直接将预训练的视频生成模型(如 Wan 2.1)转变为编码器本身,通过在推理阶段将 Rectified Flow 的 ODE 转换为等效 SDE,利用码本(Codebook)索引控制生成轨迹,实现了在极低码率下的高质量视频重建。
TL;DR
传统的视频压缩正在遭遇“感知坍塌”——在极低码率下,画面会变得模糊且充满伪影。本文提出的 Generative Video Codec (GVC) 跳出了“先压缩再修复”的窠臼。它直接通过 Rectified Flow 模型的推理轨迹来定义压缩过程。无需任何重新训练,GVC 就能在 0.002 bpp(每像素位深度)以下的带宽下,通过“重演”高质量的视频生成轨迹,还原出细节丰富的视频。
背景定位:从“修复插件”到“核心引擎”
在生成式 AI 爆火的背景下,视频压缩领域出现了很多尝试。但大多数工作只是把 Stable Video Diffusion (SVD) 等模型当成一个“高级美颜滤镜”,放在 H.264 或 VVC 编解码器的输出端。
GVC 的洞察极具颠覆性:如果生成模型已经理解了视频的分布,那么压缩的任务就不再是传输像素,而是传输“引导生成的指令”。 这一转变让模型从后处理模块变成了编解码器的核心。
痛点深挖:确定性轨迹的局限
现代顶尖的视频生成模型(如 Wan 2.1)通常基于 Rectified Flow (RF)。RF 的核心是解一个确定性的常微分方程 (ODE)。这意味着给定一个初始噪声,视频生成的路径是死板固定的。
对于压缩来说,这很糟糕。因为压缩需要“纠偏”——在生成每一步,我们需要注入一些来自原始视频的信息。确定性轨迹没有这种注入点。
核心方法:SDE 转换与码本驱动
为了解决上述技术瓶颈,作者引入了 Score-SDE 理论,进行了一场精妙的数学手术。
1. ODE 到 SDE 的华丽转身
作者通过数学公式将确定性的 ODE 转换为了等效的随机微分方程 (SDE)。
abla \log p _ {t} (\mathbf {x} _ {t}) \right] \mathrm {d} t + g _ {t} \mathrm {d} \bar {\mathbf {w}} $$ 这一步的关键在于引入了 $g_t$ 项,它像是一个“开口”,允许我们在推理过程中注入随机变量。而这个随机变量,就是承载压缩信息的载体。 ### 2. 码本驱动的采样 (Codebook-Driven) 在解码端的每一步,我们不再注入随机噪声,而是传入预先选好的**码本索引 (Indices)**。 * **编码端**:计算生成预测与真实原始 latents 之间的残差,从码本中挑选最接近的原子(Atoms)。 * **解码端**:根据传输的索引找到原子,注入 SDE 轨迹。 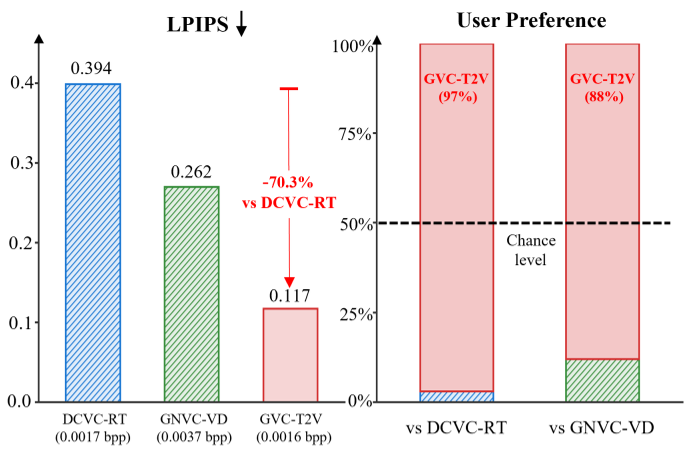 *上图展示了 GVC 的核心流程:通过码本控制的 SDE 轨迹重放。* --- ## 三大策略:平衡空间保真度与时间相干性 GVC 提供了三种变体,覆盖了不同的应用场景: 1. **T2V (Text-to-Video)**:纯纯的极致压缩,几乎不传参考帧,码率极低(~71 kbps),全靠生成模型“脑补”。 2. **I2V (Image-to-Video)**:自回归链模式。传一个首帧,后面的 GOP 递归参考,并加入“尾部残差修正”防止性能漂移。 3. **FLF2V (First-Last-Frame-I2V)**:**双锚点平衡流**。同时传输 GOP 的首尾帧进行插值生成。作者巧妙设计了“边界共享”机制,让 GOP 衔接处的码率开销降低了 50%。 --- ## 实验与结果:超越 SOTA 在 UVG 数据集 1080p 的测试中,GVC 展示了恐怖的压缩潜力: * **超低码率表现**:在 0.002 bpp 级别,传统 VVC 或 DCVC-RT 的画面往往已经模糊不清,而 GVC 依然能保持极高的视觉清爽度(LPIPS 指标大幅领先)。 * **消融实验验证**:实验证明,采样步数(T)在 20 步左右达到收益上限,而扩散缩放因子(gscale)选在 3.0 是维持生成质量与纠偏能力的黄金分割点。 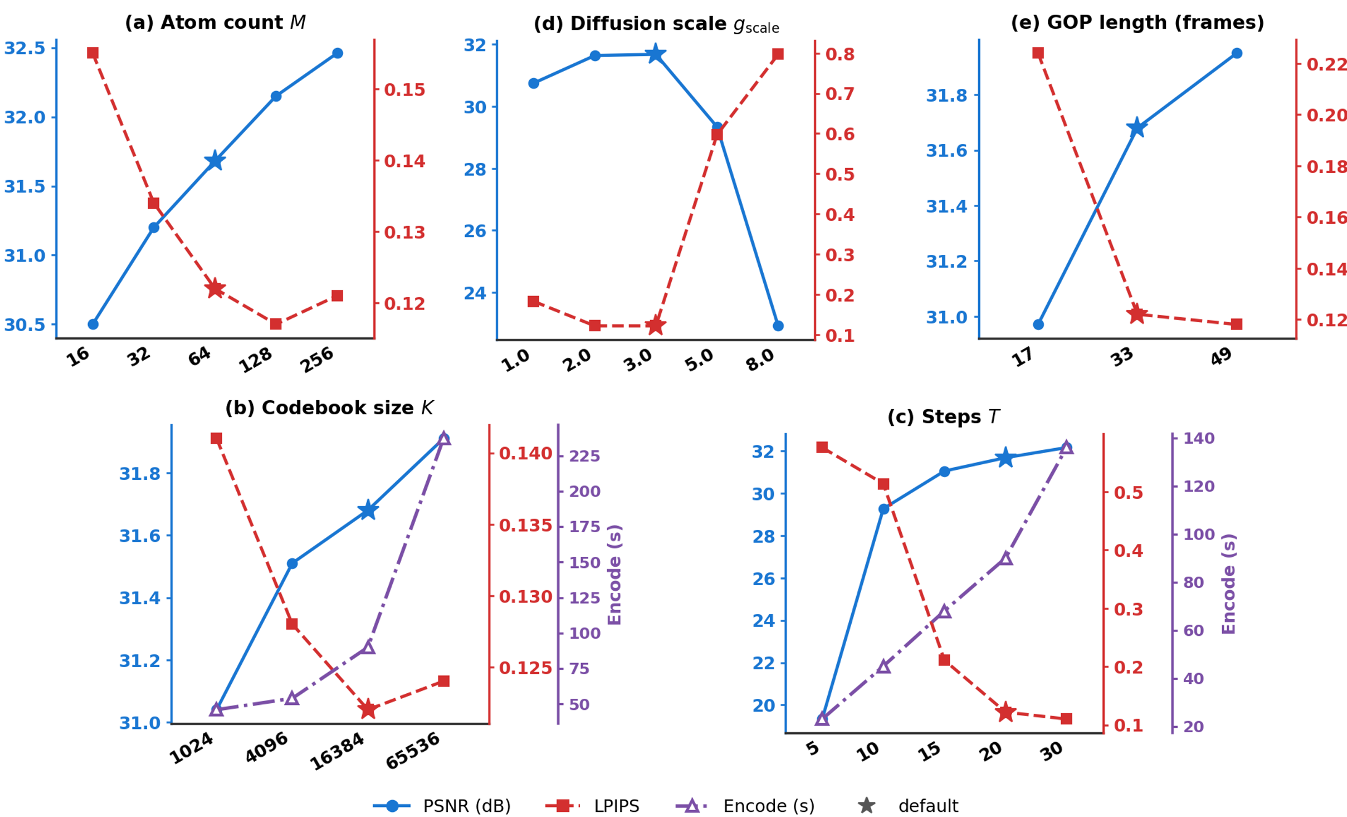 *图 2 展示了不同超参数对效果的影响,可见 M(码本原子数)和 T(步数)的精细调优过程。* --- ## 深度洞察:为什么 GVC 值得关注? GVC 的商业价值在于它的 **Zero-Shot** 属性。你不需要为每一个新的视频大模型去训练专门的编解码器,只要模型是基于 Flow 设计的(这是目前的各家大模型的主流选择),就能直接套用 GVC 框架。 **局限性分析**: 尽管感知质量惊人,但 GVC 在 PSNR(峰值信噪比)等客观指标上可能不如传统方法。这是生成式压缩的通病——它倾向于生成“好看”而非“百分百像素还原”的画面。此外,目前使用 14B 参数模型进行解码,计算开销显著,实时性仍是未来落地的挑战。 ## 总结 GVC 证明了视频大模型本身就是一个巨大的知识压缩包。通过将解题思路从“传输数据”转向“引导轨迹”,我们正在见证视频压缩技术从“信息论”向“生成智能”的跨代跃迁。