
空间智能的新维度:从“能看懂”到“能画准”的生成式跃迁
Exploring Spatial Intelligence from a Generative Perspective
本文提出了 GSI-Bench,这是首个旨在衡量多模态大模型(MLLM)在生成过程中遵循 3D 空间约束能力的基准测试。该基准通过空间引导的图像编辑任务,量化评估模型对物体位移、旋转、缩放等 7 种空间操作的执行精度及语义对齐。
TL;DR
在多模态模型(MLLM)的世界里,我们习惯了测试它们“看图说话”的能力,但如果让它们根据具体指令更新图像中的 3D 空间关系呢?本文提出了 GSI-Bench,首次系统性地探讨了生成空间智能 (Generative Spatial Intelligence)。研究表明,现有的模型在生成精确 3D 操纵方面表现并不理想,但通过合成数据的生成式微调,模型不仅能“画”得更准,甚至能变得“更聪明”(理解能力增强)。
动机:空间智能不应只有“半个大脑”
目前的 MLLM 测试如 OmniSpatial 等,大多在考查模型的“理解能力”——即给定图像,问你杯子在哪。然而,真正的空间智能应该是双向的:一个具备物理常识的模型,应当能够在生成图像时,遵循复杂的 3D 物理约束(如平移、旋转、遮挡关系)。
现有的图像编辑(如 AnyEdit)多关注语义变化(如“把背景变晴朗”),而缺乏对几何量化操作(如“顺时针旋转 45 度”)的深度支持。
核心方法:GSI-Bench 的双轨制构建
为了解决真实世界数据缺乏 3D ground-truth 的痛点,作者构建了一个互补的测评体系:
- GSI-Syn (合成轨):利用 AI2-THOR 等仿真引擎。其优势在于拥有完美的 3D 元数据(物体坐标、相机位姿),可以自动生成物理上完全真实、像素级对齐的编辑对。
- GSI-Real (真实轨):基于 ScanNet++。作者利用 3D 检测模型 DetAny3D 对现实室内场景进行重构,并使用 MLLM 作为“质量守门员”过滤掉物理上不可行的操作指令(如物体穿模、悬空)。
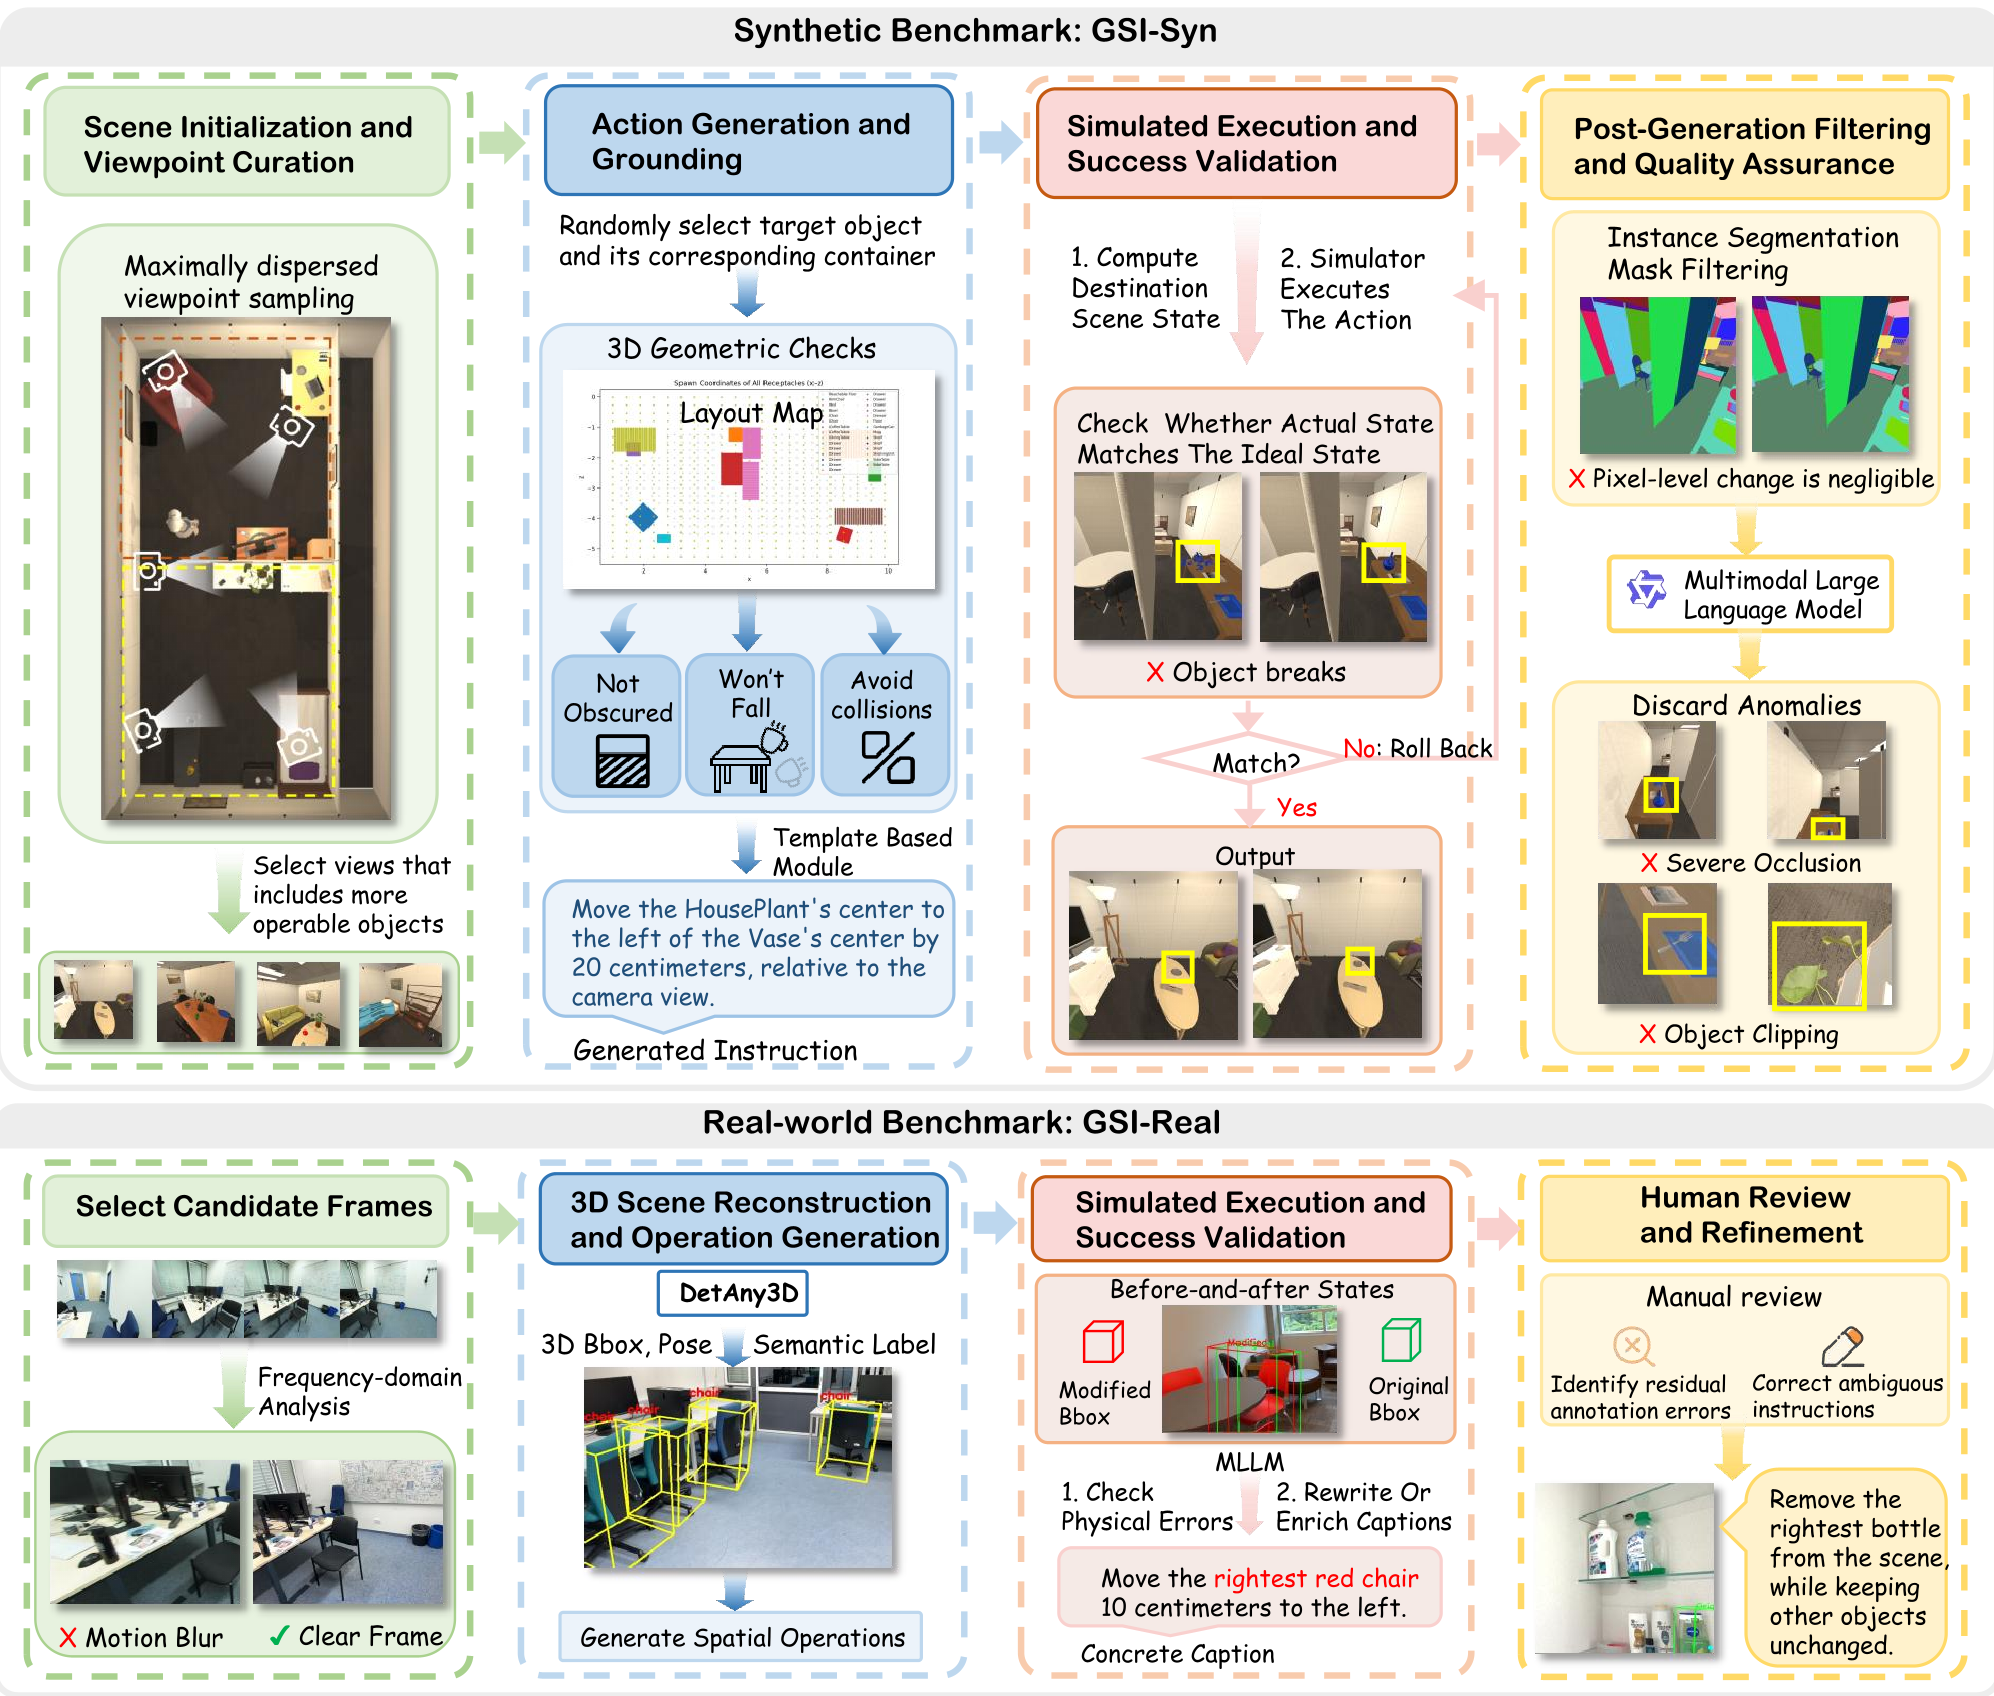 图 1:GSI-Bench 构建管线:涵盖从场景初始化、3D 几何验证到生成指令的完整流程。
定量评估:多维度的“物理考核”
GSI-Bench 并不只是看生成的图漂不漂亮,而是引入了四项硬指标:
- IC (指令遵循):空间语义是否正确(如:说向左移,结果弄成了向右,则判断失败)。
- SA (空间准确度):计算欧几里得距离或地心旋转误差。
- EL (编辑局域性):保证除了操作目标外,背景和其他物体不能乱变。
- AC (外观一致性):物体被移动后,颜色、纹理、类别不能发生漂变。
实验洞察:生成式训练的“反哺”效应
在对比了 GPT-4o-img、NanoBanana、Emu3.5 以及 BAGEL 后,作者发现了一些有趣的现象:
- SOTA 现状:专为视频或多模态设计的模型(如 Emu3.5)比纯指令编辑模型表现更好,这归功于其更丰富的视频/动态数据训练。
- Sim-to-Real 的魔法:仅在合成数据(GSI-Syn)上微调后的模型,在真实世界的 GSI-Real 任务上提升显著(+7.83 分)。
- 意想不到的加成:最惊人的发现在于,只进行生成式微调,模型的空间理解(QA 类任务)能力居然也提升了。这证明了在生成过程中强制模型遵从物理约束,有助于其内化更深层的 3D 空间表征。
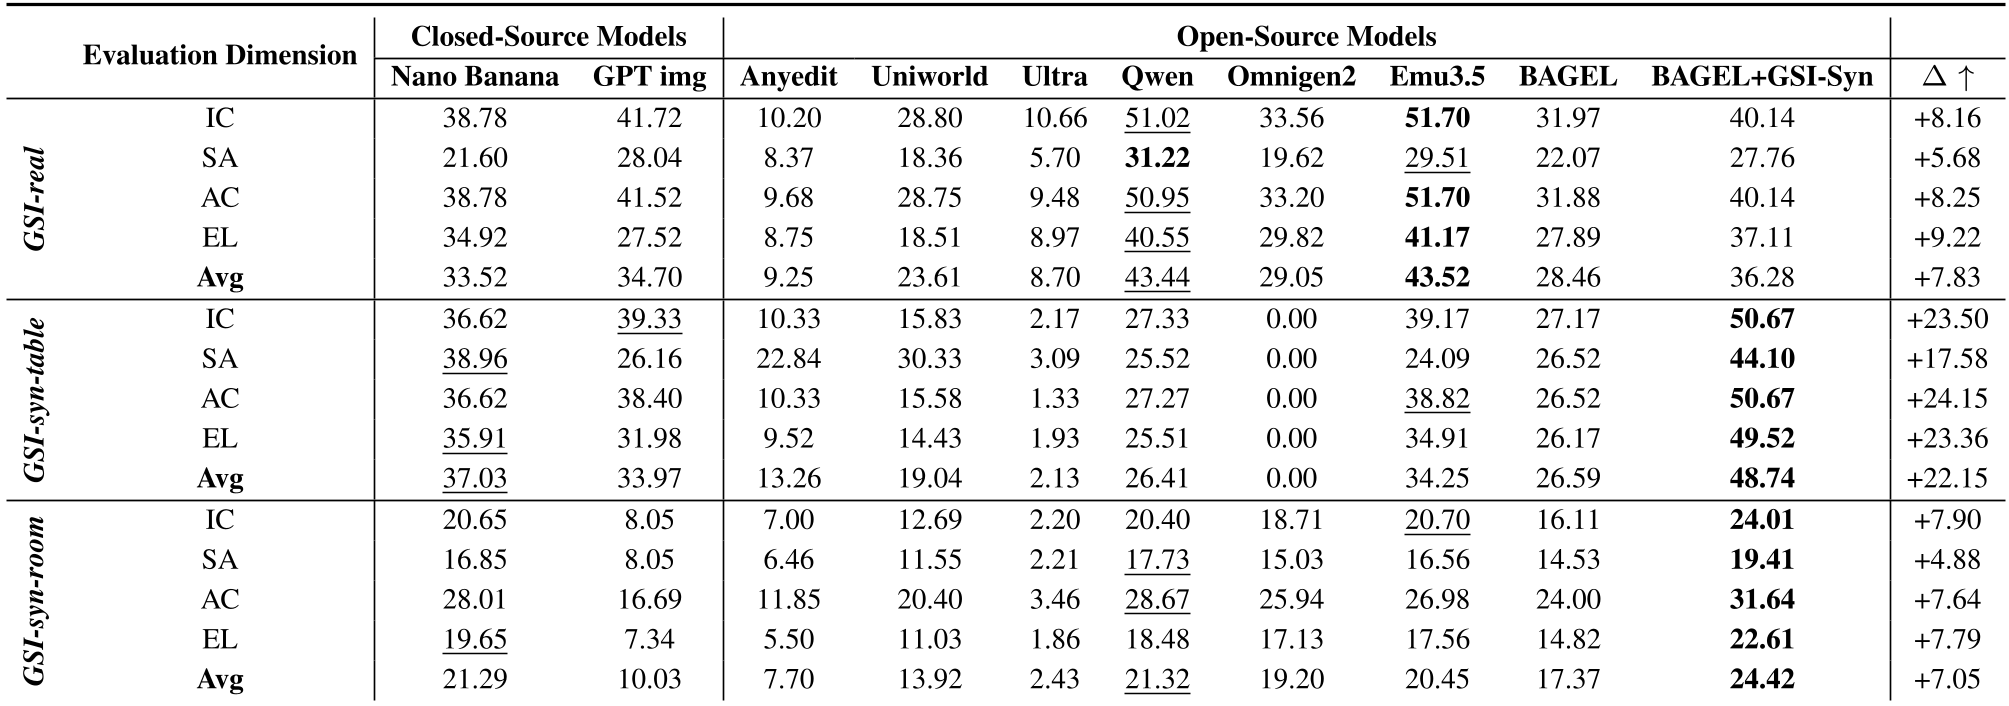 表 1:各模型在 GSI-Bench 上的对比,BAGEL 在微调后性能跨越式增长。
总结与未来展望
《Exploring Spatial Intelligence from a Generative Perspective》为我们指明了一个新方向:生成式任务不仅是目的,也是手段。通过让模型在虚拟仿真环境中“练习”物体操纵与场景生成,我们可以低成本地培养出具备强大物理常识的通用世界模型。
尽管目前模型在复杂场景的高级逻辑推理上仍有局限性,但 GSI-Bench 的提出,无疑为通往“具身智能”的道路打下了一块坚实的几何底座。