
GeoRect4D:当 3DGS 遇上扩散模型,稀疏视图下的动态重建新高度
GeoRect4D: Geometry-Compatible Generative Rectification for Dynamic Sparse-View 3D Reconstruction
本文提出了 GeoRect4D,这是一个针对稀疏多视图视频进行动态 3D 场景重建的生成式修正框架。该方法结合了锚点驱动的动态 3D Gaussian Splatting (3DGS) 与单步扩散修正器 (Single-step Diffusion Rectifier),在极少视图(如 4 视图)下实现了 SOTA 级的重建质量和时空一致性。
TL;DR
在极度缺乏摄像头视角(稀疏视图)的情况下重建动态 3D 视频,往往会得到一堆“飞舞的碎片”或模糊的光影。上海交通大学的研究团队提出了 GeoRect4D,通过将 动态 3D Gaussian Splatting (3DGS) 与 单步扩散修正器 深度耦合,实现了在仅有 4 个视角输入下,依然能生成高清、时空一致的 6-DoF 自由视角视频。
痛点深挖:为什么 sparse-view 4D 重建这么难?
在动态场景重建中,我们面临两个“不可能三角”的博弈:
- 几何稳定性 vs. 细节表现力:视图太少,模型会通过堆叠透明的伪影(Floaters)来强行拟合训练图,导致几何崩溃。
- 生成自由度 vs. 3D 一致性:虽然 2D 扩散模型(Stable Diffusion 等)能凭空想象出缺失的纹理,但由于每帧生随机性不同,会导致物体形状在空间和时间上发生“结构漂移”。
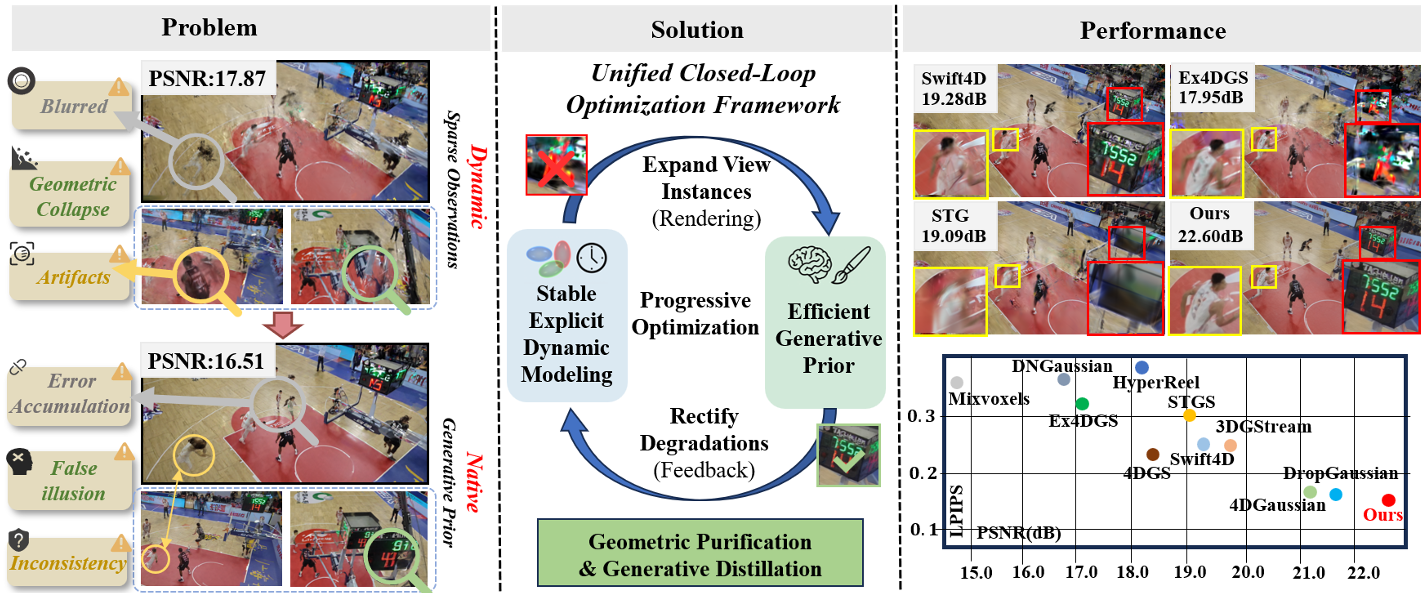 左侧展示了传统方法在稀疏视角下的几何模糊和伪影,GeoRect4D 显然更扎实。
核心算法:闭环优化的两部曲
第一阶段:随机几何纯化 (Stochastic Geometric Purification)
作者认为,不能一上来就让 AI 瞎猜细节,得先打好地基。
- 分布引导随机修剪:不仅仅是简单的剔除,而是根据局部空间密度和深度分布,利用 Bernoulli 分布概率性地修剪掉那些靠近相机的“漂浮点”。
- 不透明度退火 (Opacity Annealing):给 Gaussian 点的透明度加入随机噪声,强迫模型寻找那些在噪声下依然稳定的物理配置,从而消除虚假透明度。
第二阶段:生成式知识蒸馏 (Generative Knowledge Distillation)
当地基稳固后,GeoRect4D 开启了“生成式插件”:
- 结构锁定机制 (Structural Locking):在扩散模型的 Decoder 中注入从编码器提取的多尺度空间特征,确保生成的图像不会脱离原有的 3D 骨架。
- 时空协调注意力 (STCA):在修正每一帧时,不仅看当前帧,还会参考相邻帧以及其他视角的信息,彻底解决了视频闪烁(Flickering)问题。
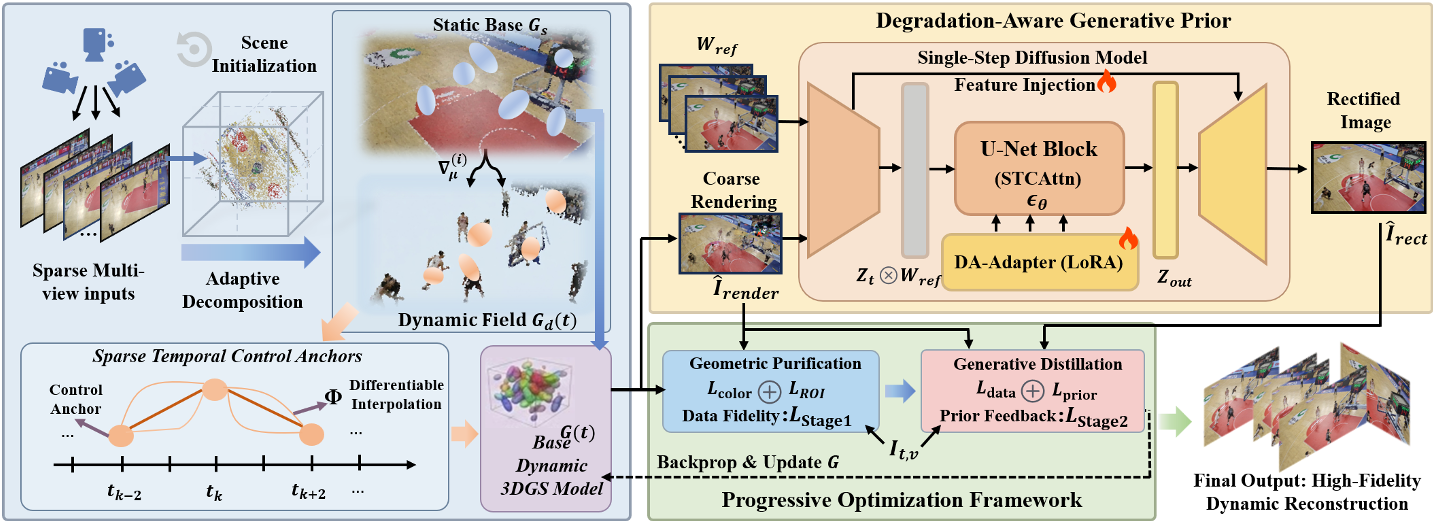 GeoRect4D 架构:左侧为 3DGS 基底,右侧为带跳跃连接的扩散修正器。
实验战绩:全方位的 SOTA
在 N3DV、MeetRoom 以及极具挑战性的 MPEG 数据集上,GeoRect4D 展现了统治级的表现:
- 精度跃升:在 N3DV 上 PSNR 达到 26.98 dB,相比专注于稀疏视角的 Sparse4DGS 提升了 4.7 dB。
- 时空一致性:其 tOF 指标(衡量视频抖动)在所有对比方法中表现最优,这意味着它生成的视频不仅清晰,而且极度平滑。
- 渲染效率:尽管引入了复杂的修正流程,但受益于单步扩散设计,渲染速度依然保持在 115 FPS 以上。
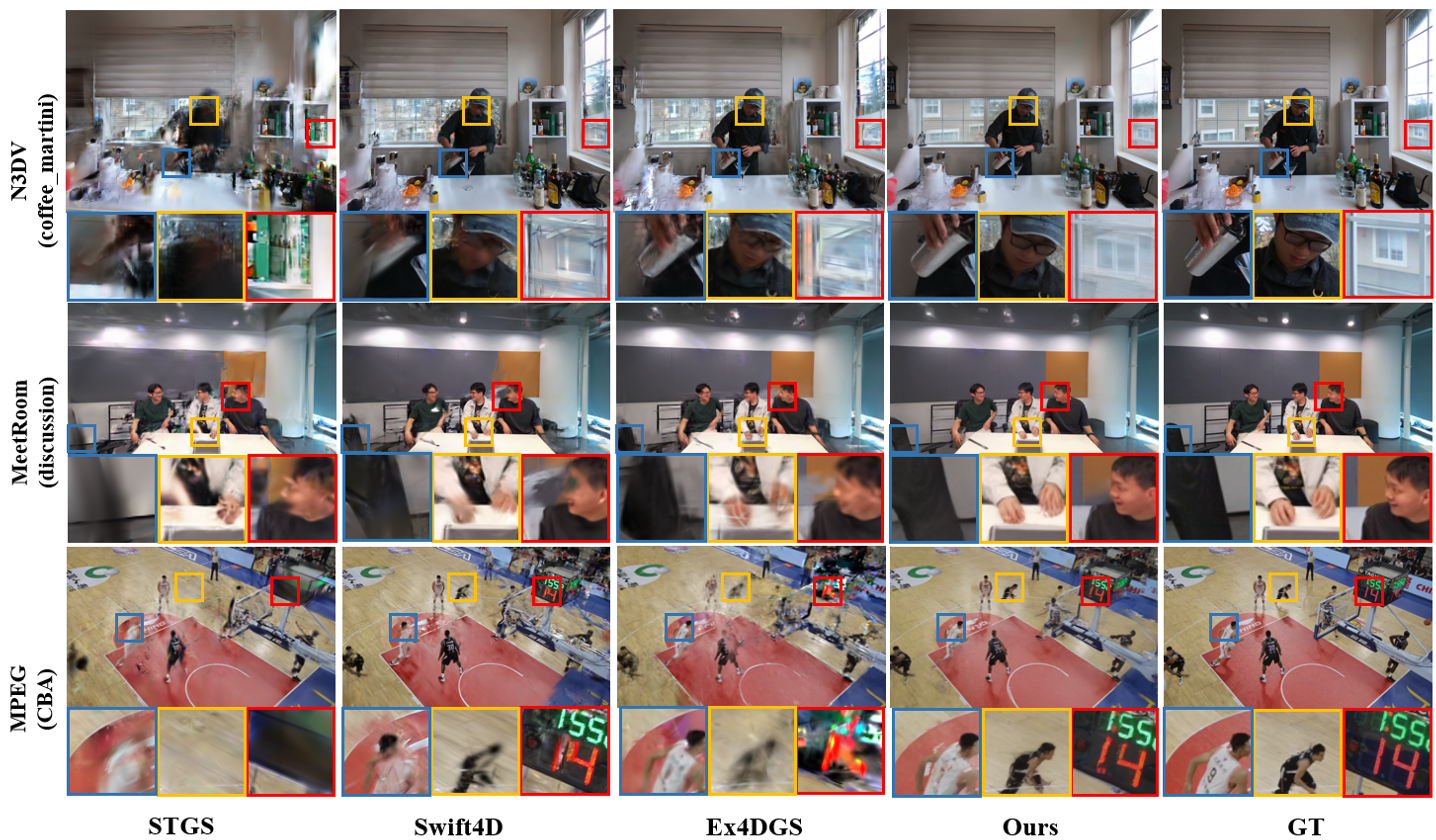 定性对比显示,GeoRect4D 在恢复运动员身后的广告牌文字、面部表情等细节上远超同类工作。
深度洞察与总结
GeoRect4D 的成功在于它精准地平衡了“确定性”与“随机性”。它不是简单地用 AI 把图变高清,而是将 AI 修复后的结果作为一种“伪标签”,动态地灌输回 3D 空间。这种“显式 3D 表示 + 降级感知生成先验”的组合,可能是未来 FVV (Free-Viewpoint Video) 落地在消费级采集设备上的关键技术方向。
局限性:该方法目前仍依赖于 SfM 的初始位姿估计,且在处理超大范围遮挡时仍有提升空间。