
幻觉根源于“自知之明”的缺失:LLM 如何通过元认知走出效用陷阱?
Hallucinations Undermine Trust; Metacognition is a Way Forward
本文由 Google Research 和特拉维夫大学联合发表,探讨了 LLM 幻觉问题的本质,提出了 Metacognition(元认知)框架。文章论证了当前模型在“区分已知与未知”的能力(Discrimination)上存在瓶颈,并提出以 Faithful Uncertainty(忠实不确定性)取代单纯的“回答或拒绝”二分法,从而在不牺牲实用性的前提下提升模型可信度。
TL;DR
幻觉(Hallucinations)一直是 LLM 规模化应用的阿喀琉斯之踵。传统观点认为幻觉是事实性错误,必须通过消除错误或增加拒绝回答来解决。然而 Google Research 的最新论文指出:幻觉的本质不是“错误”,而是“过度自信的错误”。由于模型存在不可逾越的“区分力鸿沟”,单纯的拒绝会导致模型变得极其难用。作者提出通过 Metacognition (元认知) 实现 Faithful Uncertainty (忠实不确定性),让模型学会“知之为知之,不知为不知”,以诚实的不确定性表达来挽回用户信任。
1. 痛点:被忽视的“区分力”挑战
目前提升 LLM 事实性的主流路线是:灌入更多数据(扩大边界)。但作者提出了一个令人的沮丧的视角:即便模型知道很多,它也无法判断自己到底哪些是真知道,哪些是瞎编。
这就是所谓 Calibration (校准) 与 Discrimination (区分力) 的区别:
- 校准:模型说它有 60% 把握,事实上它 10 题里确实对了 6 题。
- 区分力:模型能精准指出 10 题里哪 4 题是错的。
目前的 Frontier Models 普遍展现出不错的校准度,但区分力极差。这意味着如果我们强行命令模型“不准撒谎”,模型因为分不清哪句是谎言,会把大量的正确答案也一并“拒绝”掉。这种 Utility Tax (效用税) 让开发者陷入了两难境地:要么模型满嘴跑火车,要么模型变成只会说“对不起,我不知道”的复读机。
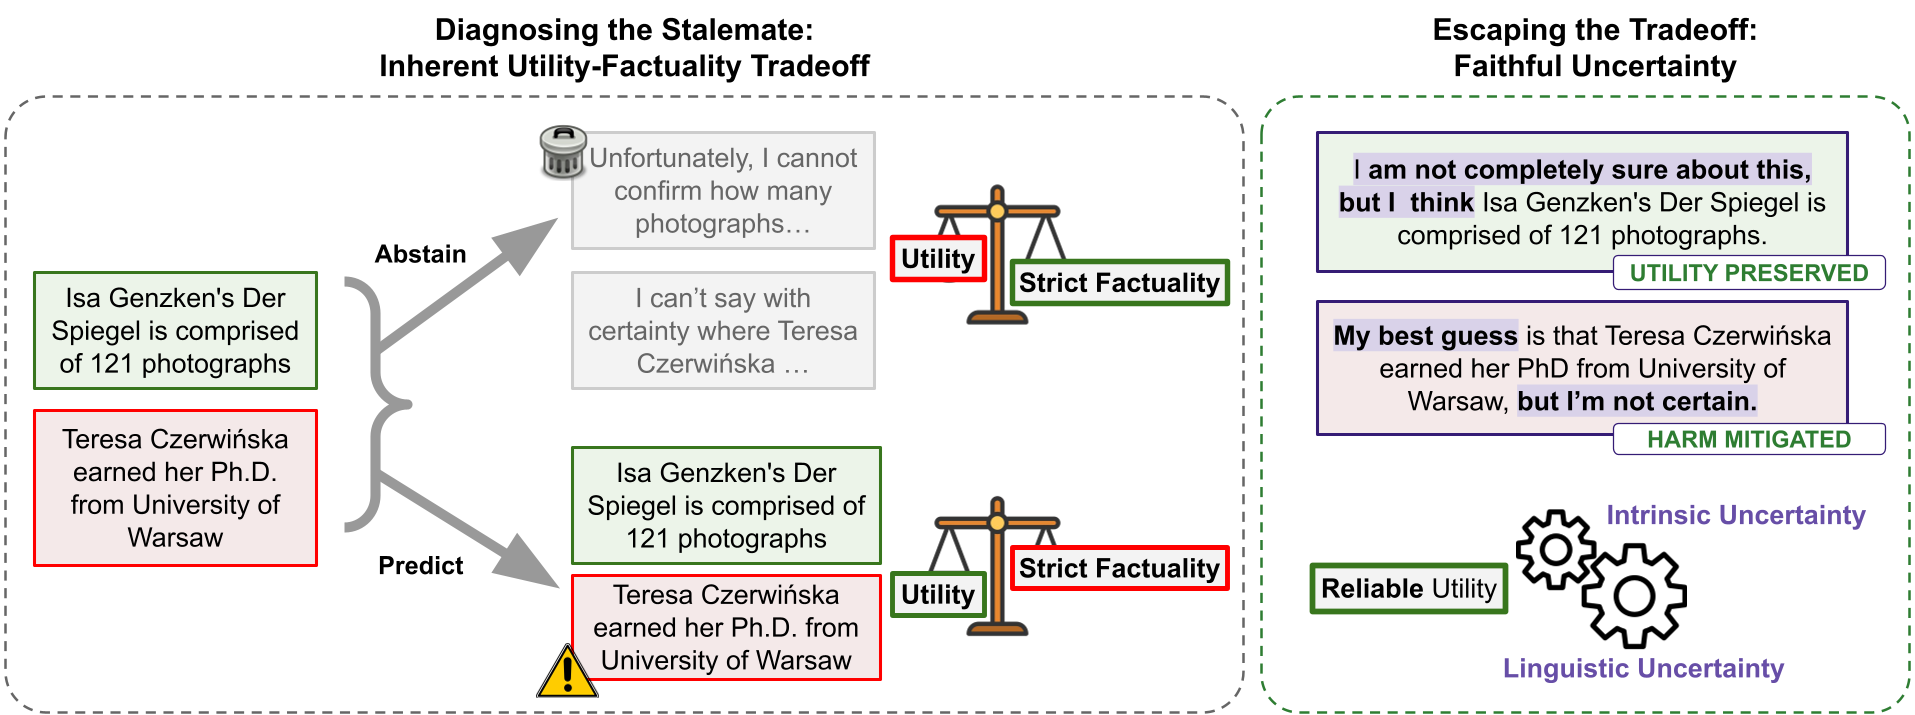 左图显示了传统视角下的困境:为了消除红色错误,必须放弃大量绿色正确信息。右图展示了本文提出的第三条路:通过忠实表达不确定性(黄色),保留信息的参考价值。
2. 核心方法论:元认知与忠实不确定性
为了打破上述死锁,作者引入了 Metacognition (元认知) 概念。元认知包含两部分:Introspection (内省) 和 Regulation (调节)。
2.1 什么是 Faithful Uncertainty?
文章定义了两个核心维度:
- Intrinsic Uncertainty (内在不确定性):模型权重的统计状态。当模型对某个答案不确定时,多次采样往往会得到冲突的内容。
- Linguistic Uncertainty (言语不确定性):模型输出时用的语气词,如“我推测...”、“可能...”。
忠实性(Faithfulness) 的目标就是让这两个维度对齐。如果模型内部确信度只有 0.6,那么它在说话时就必须带上相应程度的“对冲”(Hedging)。
2.2 架构解析与数学定义
作者给出了具体的评估公式,衡量 decisiveness(言语决断度)与 confidence(内在置信度)的偏离:
faithfulness = 1 - |dec - conf|
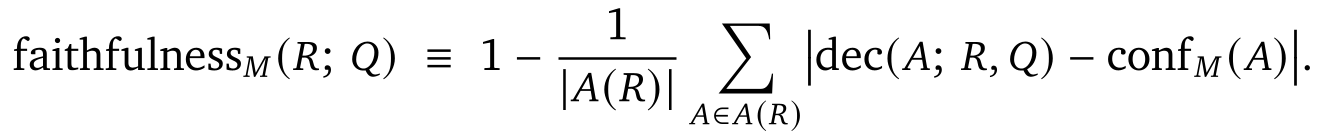
这种做法的直觉在于:一个被妥善标注了“不确定”的错误,不再是幻觉,而是一个有价值的假设。 就像医生不会在没有十足把握时下死结论,而是说“怀疑是某种病,建议进一步检查”。
3. 实验发现:为什么我们还没达到终点?
论文引用了 SimpleQA Verified 等长尾事实基准测试的结果(见下图)。
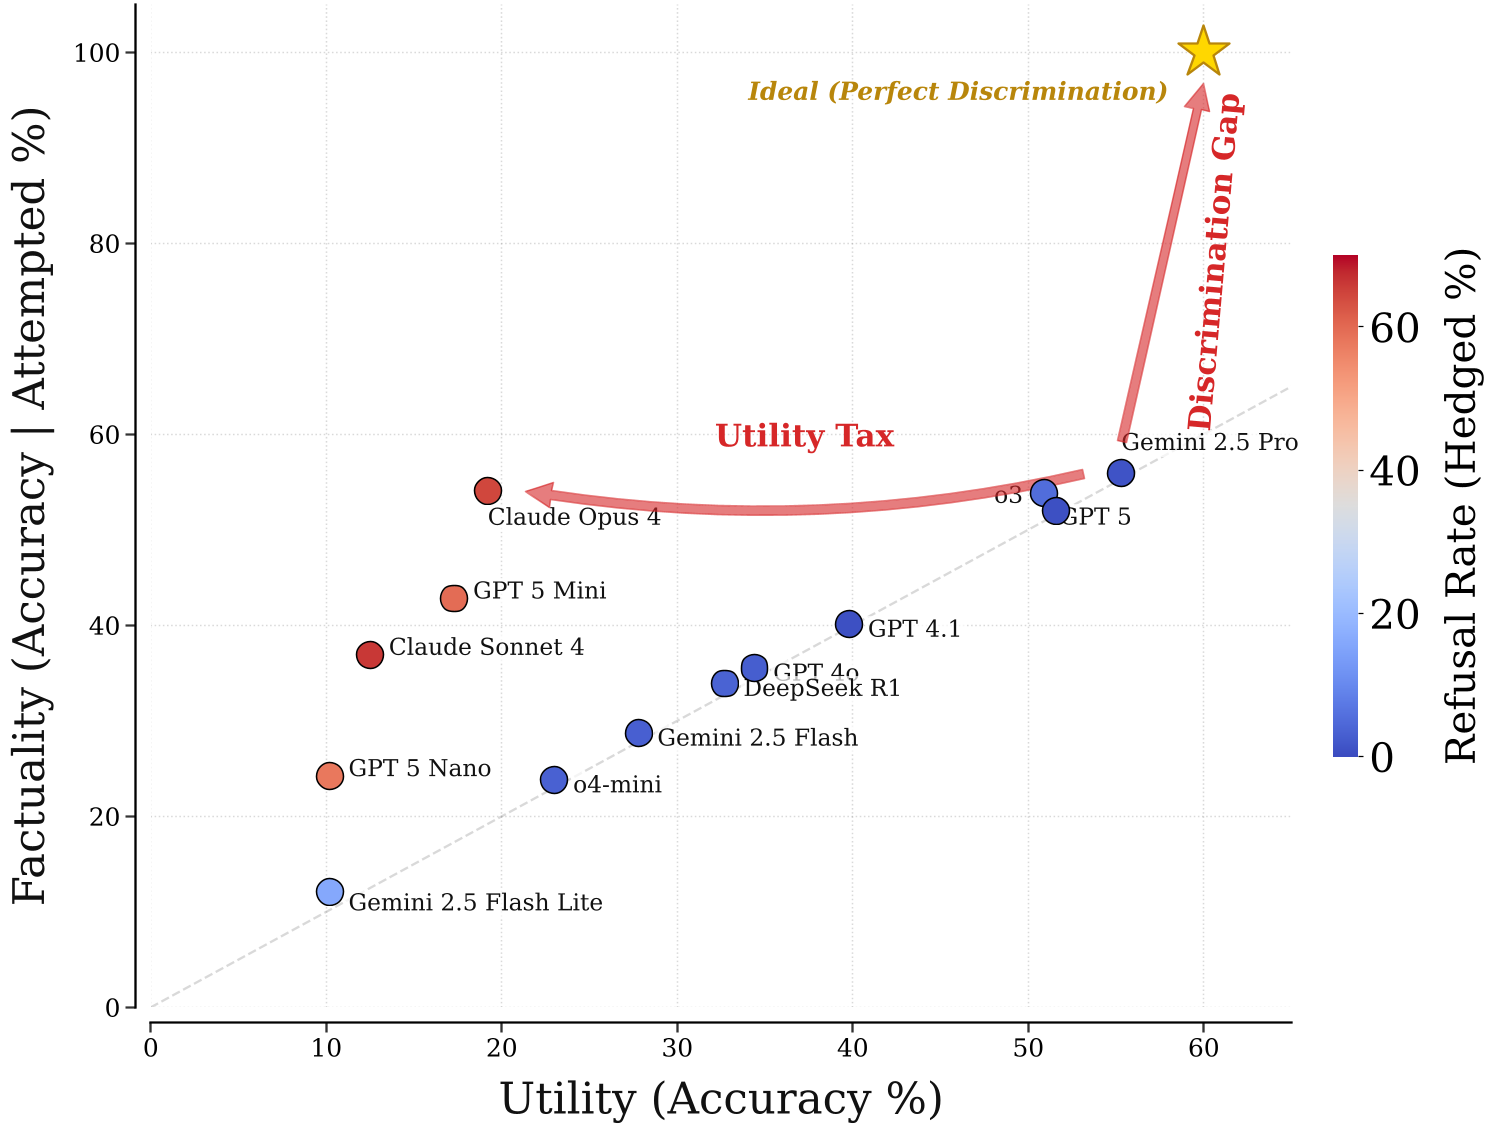
实验揭示了一个惊人的现状:
- 主流模型(如 Llama 3, GPT-4 系列):大多沿对角线分布,倾向于“有问必答”,导致幻觉率居高不下。
- 高事实性模型:通过激进的拒绝(Refusal)来工作,虽然错误少了,但有用性(Coverage)也急剧下降。
- 结论:理想的“黄金星”(高事实性 + 高覆盖率,即图中的 Gold Star 位置)区域目前是完全空白的。这证明了模型内部缺乏将知识与错误分离的机制。
4. 深度洞察:Agent 时代的元认知
随着 AI 迈向 Agentic 系统,很多人认为“模型可以搜索,就不需要区分力了”。作者对此提出了尖锐的反驳:搜索工具反而放大了对元认知的需求。
如果不具备元认知:
- 过度调用:模型会去搜索它本来就知道的简单事实,浪费资源。
- 盲目相信:当外部工具返回了错误或冲突的信息时,模型无法通过“内在先验”进行权重权衡。
作者认为元认知应该成为 Agent 的 Control Layer (控制层):只有当内部不确定性高时才发起搜索;当搜索结果与内部认知冲突时,能以怀疑的态度进行交叉验证。
5. 局限性与未来展望
尽管方向明确,但实现“忠实不确定性”仍面临 The Bootstrapping Paradox (引导悖论):
- 预训练数据(互联网文本)大多是自信满满的断言,缺乏怀疑的语感。
- 如果用 SFT 强行教模型说“我不知道”,可能会让模型在原本知道的事情上也变得退缩(Induced Overconfidence/Underconfidence)。
结语: 追求 LLM 的绝对零幻觉可能是徒劳的。正如我们信任资深专家并非因为他们全知全能,而是因为他们清楚自己的边界。Metacognition 为 LLM 建立这种“专业性”提供了可行的演进路径。