
HeavySkill:从系统编排到模型内在技能,开启 LLM “深度思考”的新范式
HeavySkill: Heavy Thinking as the Inner Skill in Agentic Harness
本文提出了 HEAVYSKILL,一种将“深度思考(Heavy Thinking)”转化为大型语言模型(LLM)内在技能的推理框架。该方法通过“并行推理+顺序审议(Sequential Deliberation)”两阶段流水线,在无需重新训练的前提下显著提升了模型在复杂任务中的推理上限。
TL;DR
在 AI Agent 领域,我们习惯于构建复杂的外部框架来管理逻辑,但 HEAVYSKILL 提出了一个大胆的视点:所谓的 Agent 编排本质上应该是模型内化的一种“重思考(Heavy Thinking)”技能。通过简单的“并行采样+审议合成”两阶段流程,该研究不仅在 STEM 任务中刷新了 SOTA,还证明了这种能力可以通过强化学习(RLVR)进一步进化。
1. 背景定位:Agent 框架的“虚胖”与回归
当前的 Agent 开发(如 Claude Code, Hermes 等)往往堆砌了大量的工具链和记忆组件,但这掩盖了核心问题:模型本身是否真的具备高效处理复杂逻辑的内在素质?
以往的 Test-time Scaling(推理时缩放)主要靠“大力出奇迹”的 Best-of-N(BoN)采样和多数投票(Majority Voting)。然而,简单的统计学投票会浪费大量潜在的正确信息。本文提出的 HEAVYSKILL 将这种外部流程转化为一种可读、可描述、可学习的 Skill,让模型像人类专家组审议一样处理问题。
2. 核心机制:并行推理与顺序审议
HEAVYSKILL 的设计极具物理直觉,它将推理过程拆解为两个核心阶段:
- 并行推理 (Parallel Reasoning):模型针对同一问题生成 条独立的思维链(CoT)。这相当于“专家组”成员独立思考。
- 顺序审议 (Sequential Deliberation):引入一个 Serialized Memory Cache,将所有推理轨迹喂给一个审议模型(可以是同一个模型或更强的 LLM)。审议者不仅看答案,更会对比推理过程中的逻辑差异,剔除错误路径。
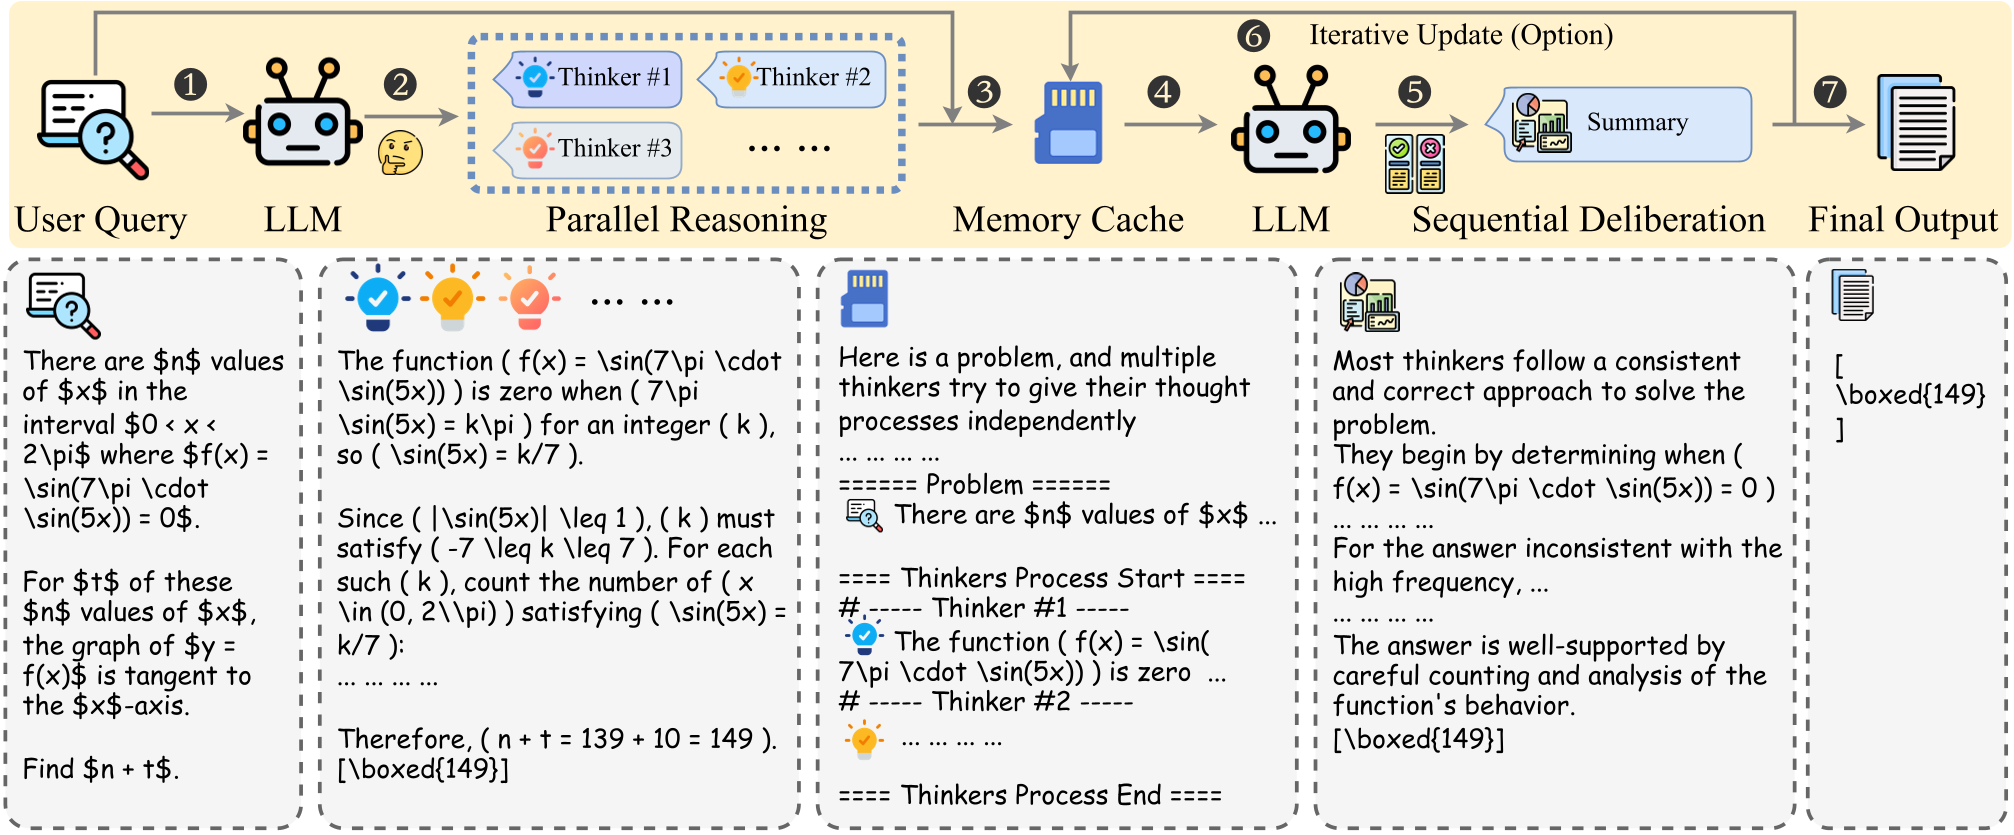 图 1:HEAVYSKILL 两阶段推理流水线架构图
创新的“内存缓存”与迭代
为了防止长文本溢出,作者对推理轨迹进行了剪裁和洗牌(Pruned & Shuffled),并支持 Iterative Deliberation(迭代审议)。这让模型能像人类反复研磨思路一样,在多次循环中不断逼近真理。
3. 实验战绩:全线超越投票法
在 AIME25、HMMT 等顶级数学竞赛任务上,HEAVYSKILL 展现出了压倒性优势:
- 超越投票法:Heavy-Mean@4(审议后的平均精度)显著高于 Vote@K。这意味着即使正确答案在采样中不占多数,审议机制也能将其“打捞”出来。
- 逼近潜力上限:在 GPT-5 Thinking 和 DeepSeek V3.2 等模型上,该方法的表现几乎触碰到了 Pass@K(采样中只要有一个对就算对)的理论天花板。
- 工具调用增强:在涉及 Python 解释器等工具调用的场景下,HEAVYSKILL 能利用执行反馈(Feedback)进行更高维度的决策纠偏。
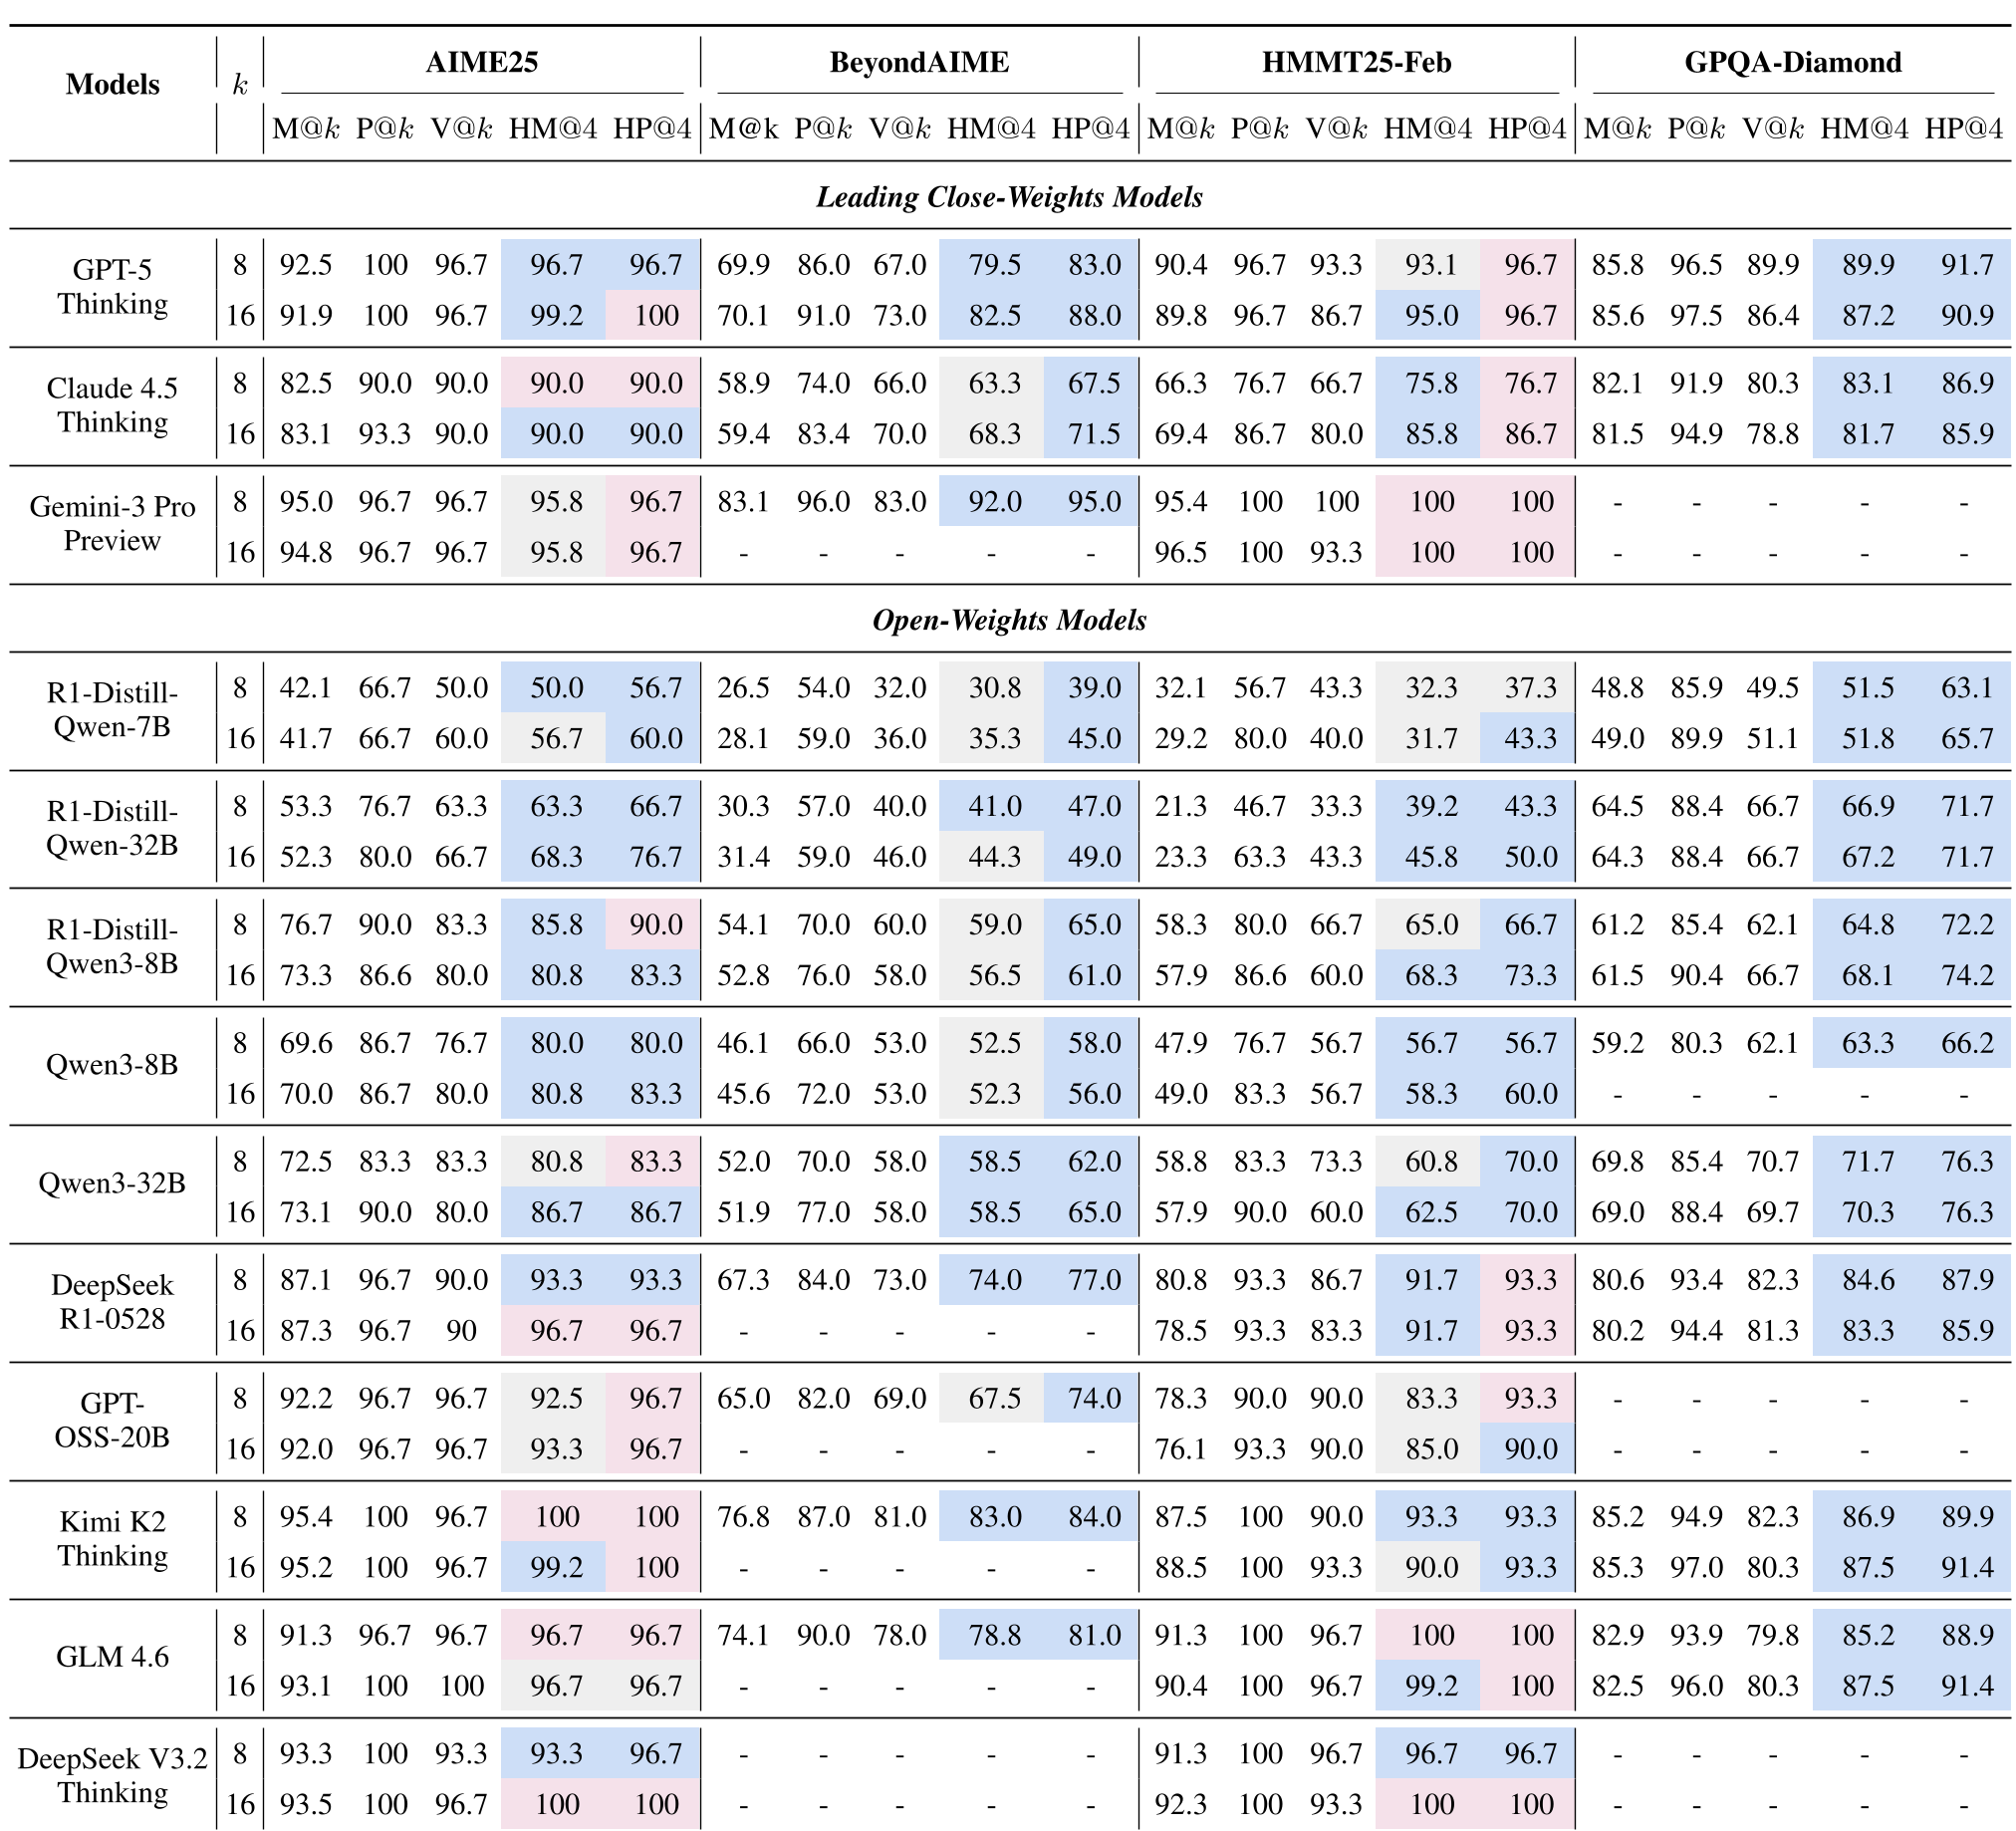 表 1:HEAVYSKILL 与多种 Baseline 在 STEM 任务上的对比
4. 深度洞察:弱模型也能审议强模型?
一个有趣的发现是(见图 3):即使辅助审议的模型本身推理能力一般(如 Qwen2.5-32B-Instruct),只要其指令遵循和总结能力够强,也能通过审议由强模型(如 R1-7B)生成的轨迹来提升最终准确率。这说明“审议”与“原创推理”是两种可以解耦的能力。
此外,作者证明了这种重思考能力是可被强化的。通过 RLVR(验证反馈驱动的强化学习),模型在处理序列化缓存时的熵逐渐稳定,HM@4 提升了 10% 左右。
5. 局限性与展望
尽管 HEAVYSKILL 表现强劲,但在处理主观性任务(如 Arena-Hard 这种偏好偏向的对话)时提升有限,因为这类任务缺乏明确的“对错”逻辑供审议者权衡。
总结: HEAVYSKILL 为我们提供了一个清晰的视角——未来的大模型不仅要“想得快”(Fast Thinking/CoT),更要学会“重思考”(Heavy Thinking)。这种将外部 Agent 逻辑内化为模型 Skill 的尝试,是通往 AGI 的必经之路。