
MOSS:视觉理解的“高阶”进解,让模型看懂运动的本质
Exploring High-Order Self-Similarity for Video Understanding
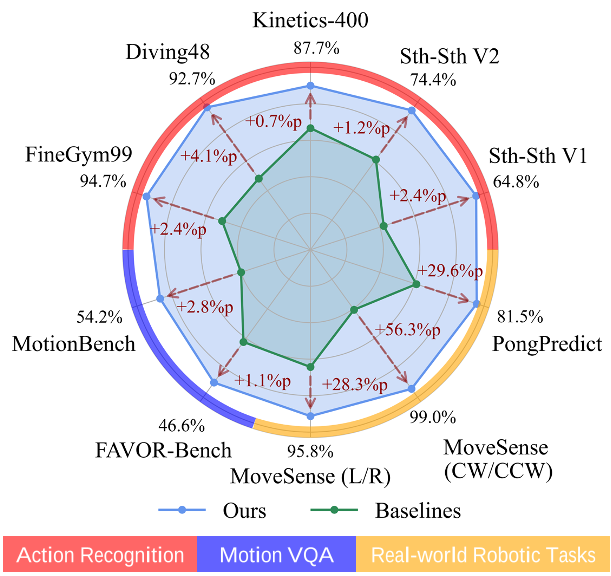
本文提出了 MOSS (Multi-Order Self-Similarity) 模块,通过探索视频中的高阶时空自相似性来增强运动建模能力。该方法在视频动作识别、多模态大模型(MLLM)和机器人视觉语言动作模型(VLA)等任务上均达到了 SOTA 性能。
TL;DR
传统的视频识别模型往往只是在“认图”而不是在“看动作”。本文提出的 MOSS (Multi-Order Self-Similarity) 模块,通过挖掘视频中“运动的运动”(2 阶相似性)和“运动的布局”(3 阶相似性),赋予了 AI 极强的时空感知能力。该模块不仅极其轻量(参数增加 <1%),更在动作识别、视频 VQA 以及机器人操作等多个前沿领域刷新了 SOTA 纪录。
痛点深挖:为什么模型总是“认不出”动作?
在视频理解领域,一个经典的尴尬现象是:即使你把视频帧打乱,模型依然能靠背景学到不错的分类准确率(例如看到草地和球就猜是“足球”)。这种 Context Bias 导致模型在面对复杂、精细的动作(如“旋转物体”与“水平移动物体”)时经常吃瘪。
前人尝试利用 1 阶时空自相似性 (STSS) 来捕捉像素间的对应关系。然而,1 阶相似性基于外观,当视频中出现两个长得很像的人做不同的动作,或者背景极其嘈杂时,1 阶特征就会失效,无法准确分离出真正的运动主体。
核心直觉:什么是“高阶”自相似?
作者提出了一个极具物理直觉的层级结构:
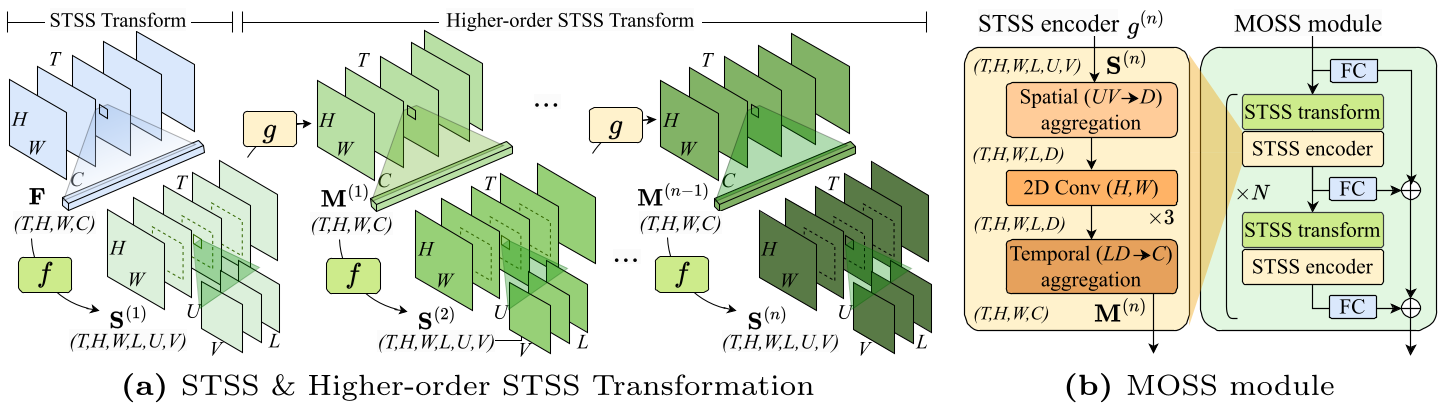
- 1 阶 STSS (外观相似性):识别“哪里有像素在动”,刻画的是运动流 (Motion Flow)。
- 2 阶 STSS (运动相似性):识别“哪些区域运动模式一致”,刻画的是运动分割 (Motion Segments)。这能帮模型把属于同一个物体的像素归为一类,即使它们外观不同。
- 3 阶 STSS (布局相似性):识别“不同运动块之间的关系”,刻画的是全局运动布局 (Motion Layout)。
方法论:轻巧且强大的 MOSS 模块
为了避免维度爆炸,MOSS 设计了一个巧妙的递归编码函数 。它并不暴力堆叠特征,而是:
- 轻量编码:通过线性层 (FC) 将高维的相关性张量降维,避免了之前方法(如 SELFY)中繁重的 3D 卷积。
- 特征融合:将 1 阶和 2 阶运动特征叠加回原始视觉特征中,作为一种强大的“运动插件”,增强现有骨干网络。
实验战绩:全方位的跨界提升
1. 动作识别:超越巨无霸模型
在 Something-Something V2 等侧重时空推理的榜单上,MOSS 以远少于基线模型的计算量,击败了包括 ViViT 在内的全参数微调模型。即便在 Kinetics-400 这种偏向背景信息的任务中,MOSS 依然能带来稳健的性能提升。
2. 具身智能:机器人的“运动预判”
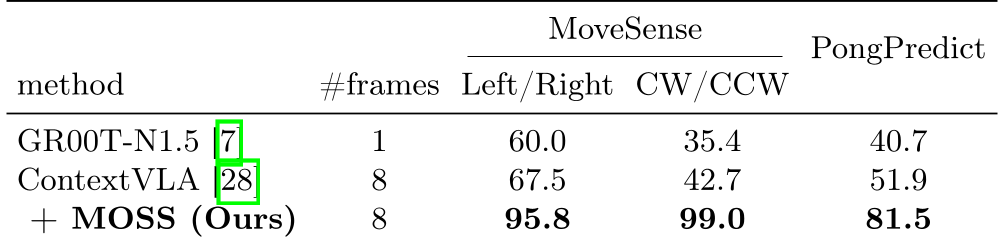
这是本文最惊艳的部分。作者在 MoveSense(识别运动方向)和 PongPredict(预测乒乓球落点)两项机器人任务中测试了 MOSS。结果显示,传统的视觉语言动作模型 (VLA) 对动态物体反应迟钝,而加入 MOSS 后,机器人的成功率直接从 42.7% 飙升至 99.0%。这意味着 MOSS 真正让机器人学会了“预判”物体的轨迹。
深度洞察与总结
MOSS 的成功证明了:显式的几何结构诱导偏置 (Inductive Bias) 在深度学习时代依然有效。
- Why it works: 通过对“相似性的相似性”建模,模型学会了抗干扰。背景虽然在动(相机运动),但其一致性与物体的独立运动在 2 阶空间中是完全异构的。
- 局限性: 实验发现 4 阶及以上的提升边际递减,且在剧烈形变(如挤压、旋转)下效果受限。
总的来说,MOSS 为所有需要“理解动态”的视觉任务提供了一个低成本、高收益的升级包,尤其值得具身智能领域的研发者关注。