
[ArXiv 2026] MoE 架构优化终结者:首个全局 Scaling Laws 揭示大模型的“参数分配艺术”
Holistic Scaling Laws for Optimal Mixture-of-Experts Architecture Optimization
本文提出了第一个针对 Mixture-of-Experts (MoE) 架构的全局模型缩放法则(Scaling Laws)。研究涵盖了从 10^18 到 3x10^20 FLOPs 的计算规模,通过引入 (M, Na, N) 三元组约束,实现了对 MoE 模型架构参数(如层数、隐层维度、专家粒度)的自动最优配置。
TL;DR
在 Mixture-of-Experts (MoE) 时代,如何分配 Attention、Dense 层与多专家层的参数一直是一门基于经验的“玄学”。复旦大学与小红书的研究团队发布了这篇里程碑论文,通过 670 多个模型的实验,首次给出了 MoE 全局架构设计的数学说明书。核心结论:大模型不需要追求绝对的精确配置,规模越大,架构容错率越高。
1. 痛点:被忽视的“参数通胀”陷阱
在密集(Dense)模型中,FLOPs per token (M) 几乎决定了性能。但在 MoE 中,作者发现一个诡异现象:你可以通过增加总参数量 (N) 或激活参数量 (Na) 来“刷高”性能,而不增加计算量。
这是因为 Attention 层和 FFN 层的计算密度差异巨大。如果只看 FLOPs,模型可能会通过膨胀专家维度来获取虚假的性能增益。因此,作者提出必须在 (M, Na, N) 三个维度下进行公平对撞。
2. 核心机理:从 16 维到 2 阶段搜索
面对 16 个相互交织的架构变量(深度、宽度、专家数、路由稀疏度等),直接寻找最优解需要 的计算量,这在经济上是不可接受的。
2.1 降维黑科技
作者通过以下三个步骤将搜索空间压缩:
- 代数降维:利用 等硬约束和硬件固定常数,将空间压至 4 维:M, Na, N 和隐层维度 d。
- 秩保持特性 (Rank-preserving Property):作者发现,即使 d 不是最优的,不同 (M, Na, N) 配置之间的性能排名也是稳定的。
- 中值代理 (Median Proxy):先取 d 的中值进行 的粗筛,找到最优三元组,再进行 的 d 维度精修。
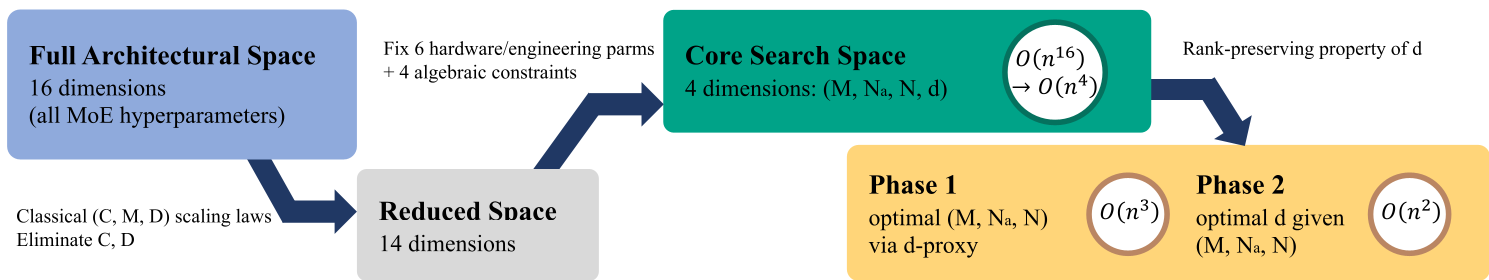 图 1:从 16 维架构空间到高效两阶段搜索的演进过程
3. 实验发现:架构师的“速效救心丸”
作者在 到 FLOPs 规模下进行了洗礼,得出了几个颠覆性的 Insight:
3.1 极其平坦的损失地貌
实验表明,最优的性能分布在 (Na, N) 平面的一个特定区域。令人惊讶的是,N/Na 比例(参数扩张倍数)的最优值在不同计算量级下非常稳定,通常在 18 到 25 之间。 这意味着开发者在设计 MoE 模型时,可以放心地参考现有的成功配置(如 DeepSeek-V3 的专家设计)。
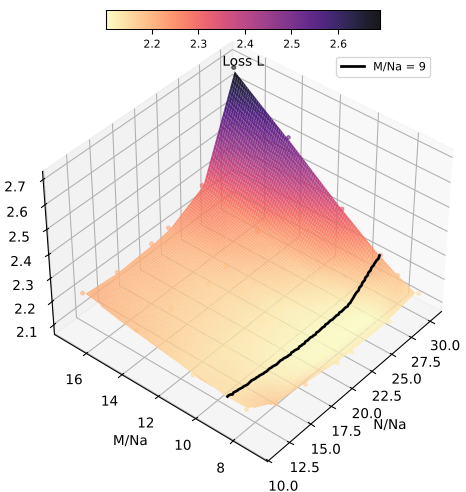 图 2:在 (Na, N) 空间内的 Loss 分布,展示了清晰的最优盆地
3.2 规模带来的自由:近优带宽 (Near-optimal Band)
这是本文最具工程价值的发现:随着模型规模 (Compute Scale) 的增大,Loss 增加 0.1% 以内的架构范围(即灰色的“近优带”)会迅速变宽。
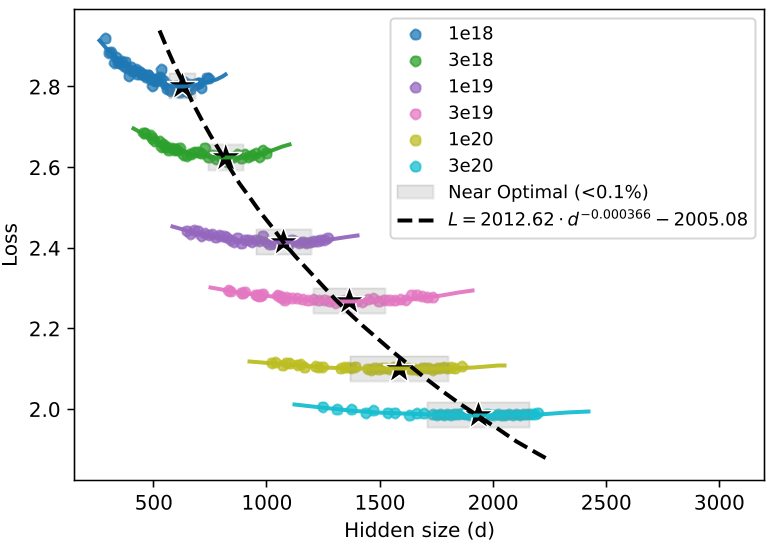 图 3:可以看到随着 Compute 增加,d 的可选范围(灰带)显著拓宽
工程启示:
- 小模型(Small-scale)需谨慎:在做早期 Proxy 小实验时,架构参数的一丁点失误都会带来巨大的噪声。
- 大模型(Large-scale)可任性:当你在训练数百 B 参数的模型时,无需纠结隐层维度是 7168 还是符合硬件优化的 8192。这种偏离对性能的影响微乎其微,工程上的便捷(对齐 2 的幂次、优化 P2P 通信)收益更高。
4. 总结:通往 MoE 自动设计的路线图
这篇论文将 MoE 设计从“艺术”带向了“工程”。只要你确定了额定的计算预算,就可以通过以下确定性流水线得到模型:
- 确定最优 和数据量 。
- 计算激活参数 和总参数 的最佳比例。
- 根据计算出的 调整隐层维度。
- 闭式求解层数等剩余参数。
局限性:目前实验主要基于预训练 Loss。虽然底层原理放之四海而皆准,但在针对推理优化(推理成本敏感型)或特定下游任务(如需要极强推理能力的逻辑任务)时,可能需要对参数分配比例进行微调。
资深主编点评:本工作最了不起的地方在于它承认了“架构配置并不唯一”。它通过严谨的数学框架证明了在大规模计算下,人类可以从繁琐的超参调优中解脱出来,转而拥抱硬件友好的设计。