
HoWToBench:打破“模仿游戏”,构建人类水平写作的大模型评估进化论
HoWToBench: Holistic Evaluation for LLM's Capability in Human-level Writing using Tree of Writing
本文提出了 ToW (Tree-of-Writing) 评估框架及配套的中文写作基准 HoWToBench。该框架通过显式构建树状评估结构并利用 LLM-Negotiator 分配权重,有效解决了大模型长文本评估中的不一致性问题,在中文 12 类体裁的评估中达到了 0.93 的人类评分相关性。
TL;DR
如果让 AI 评价另一段 AI 写的文章,它往往会陷入“越长越好”的陷阱,或者给出缺乏逻辑的一致分数。清华大学与 Z.ai 的学者们发表的题为《HoWToBench: Holistic Evaluation for LLM’s Capability in Human-level Writing using Tree of Writing》的论文,提出了一种名为 ToW (Tree-of-Writing) 的新框架。它不再让 AI 直接打分,而是先让 AI 当“谈判专家”制定打分权重,再让“专家代理”分别打分。该方法在全新的中文写作基准 HoWToBench 上实现了惊人的 0.93 人类相关性。
痛点深挖:为什么 LLM 评委总是“睁眼说瞎话”?
在复杂的文学创作(如小说、诗歌、公文报告)评估中,现有的 LLM-as-a-judge 方法存在三个致命伤:
- 谈判不一致性 (Negotiation Inconsistency):模型在面对同一篇文章时,由于缺乏显式约束,可能会在第一遍关注辞藻,第二遍关注逻辑,导致最终总分的聚合逻辑不透明。
- “模仿游戏”陷阱:大多数 Benchmark 仅测试模型是否听话(指令遵循),而忽略了文学创作中的隐式审美和情感深度。
- 长度偏差:大模型往往倾向于给长文本打高分,即使内容空洞。
核心机制:ToW (Tree-of-Writing) 结构解析
ToW 的灵感来源于人类专家的评分过程:先建立维度,再针对不同文体赋予不同权重。
1. 评估树的构建 (Taxonomy)
ToW 将评估任务结构化为一个树状图:
- 根节点 (R): 最终得分。
- 一级节点: 分为内容 (Content)、格式 (Format) 和印象 (Impression) 三大支柱。
- 叶子节点 (Leaf Nodes): 具体到逻辑、辞藻、开篇结尾、分段合理性等。
2. 动态协商 (Negotiator) 机制
针对不同的写作指令(如写一首诗 vs. 写一份合同),LLM-Negotiator 会生成一套专属的 权重分布 (Edge Weights)。例如,写合同的“格式”权重会极高,而写散文的“情感”权重则占主导。
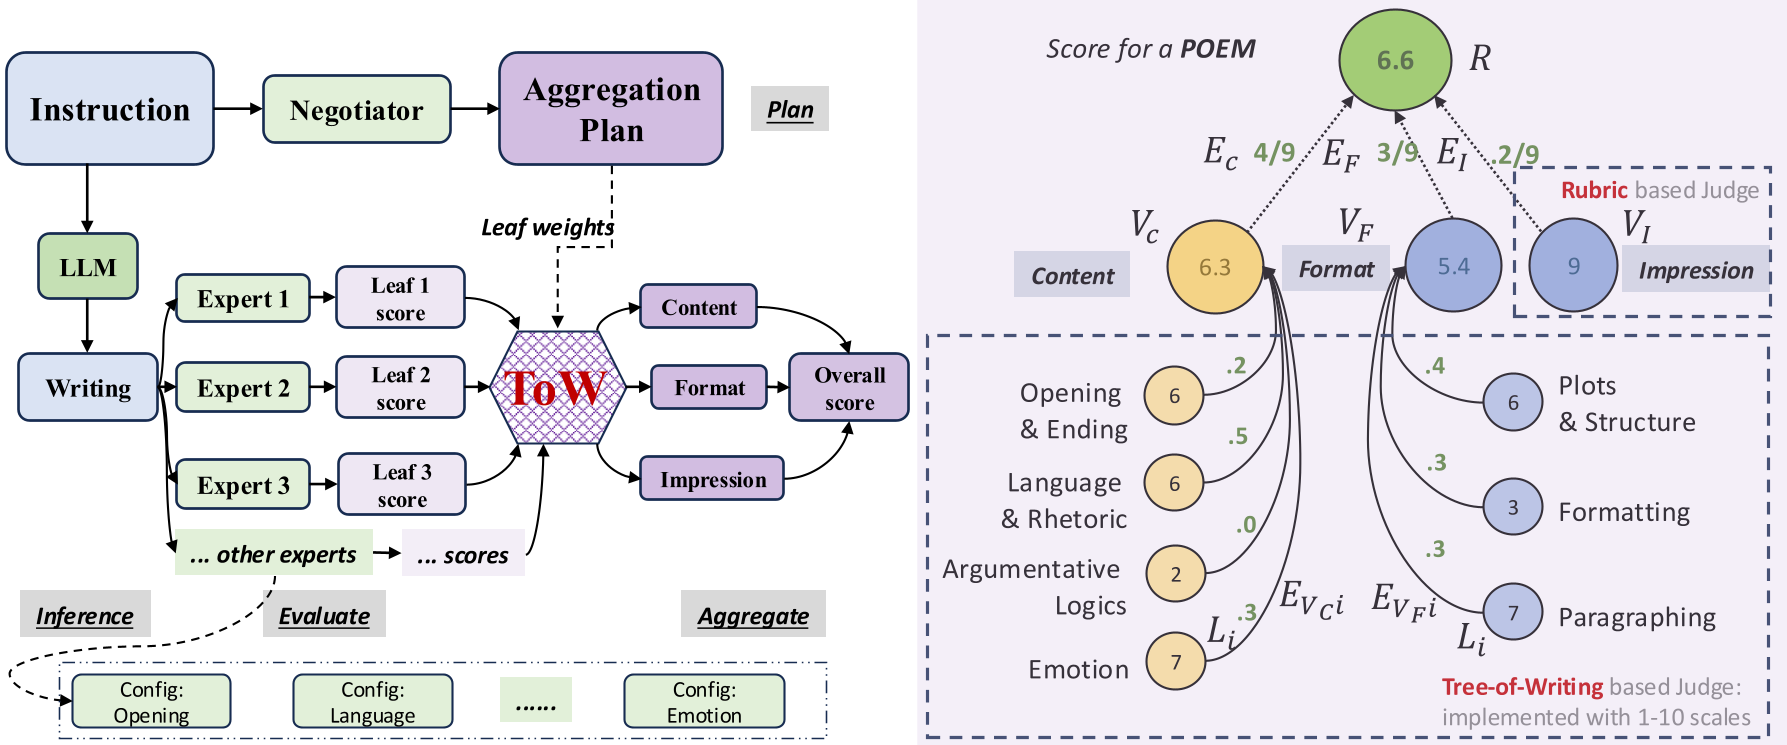 图 1:ToW 评估框架概览。Negotiator 首先根据指令制定权重计划,随后由 Expert Agents 完成评分。
HoWToBench:全方位的中文写作“考场”
作者构建了一个包含 12 种体裁、1302 个指令 的大规模中文写作基准 HoWToBench。它的独特之处在于:
- 三级难度阶梯:从补全 (Completion) 到引导写作 (Guide),再到全开放写作 (Open),全方位压榨模型的创作潜力。
- 纯净的人类参考:所有参考文本均由人类专家撰写并经过多轮筛选,杜绝了 AI 语料的循环定义问题。
实验与结果:超越“长即是好”的偏见
通过对 DeepSeek-R1、GPT-4o、Claude-3.5 等 10 款顶级大模型的测试,研究发现:
- 极高的对齐度:ToW 的评分与人类专家的相关性显著优于简单的 Rubric 方法和自动规划方法。
- 揭露长度虚荣:研究发现,在引导型任务中,输入/输出长度与内容得分实际上是 负相关 的。这表明无脑堆砌字数反而会降低创作的精炼度。
- 鲁棒性验证:当对文本进行随机“复读”或“乱删段落”的扰动时,ToW 能够敏锐地识别并降分,而传统的 BLEU 或简单的 LLM 评估往往会被欺骗。
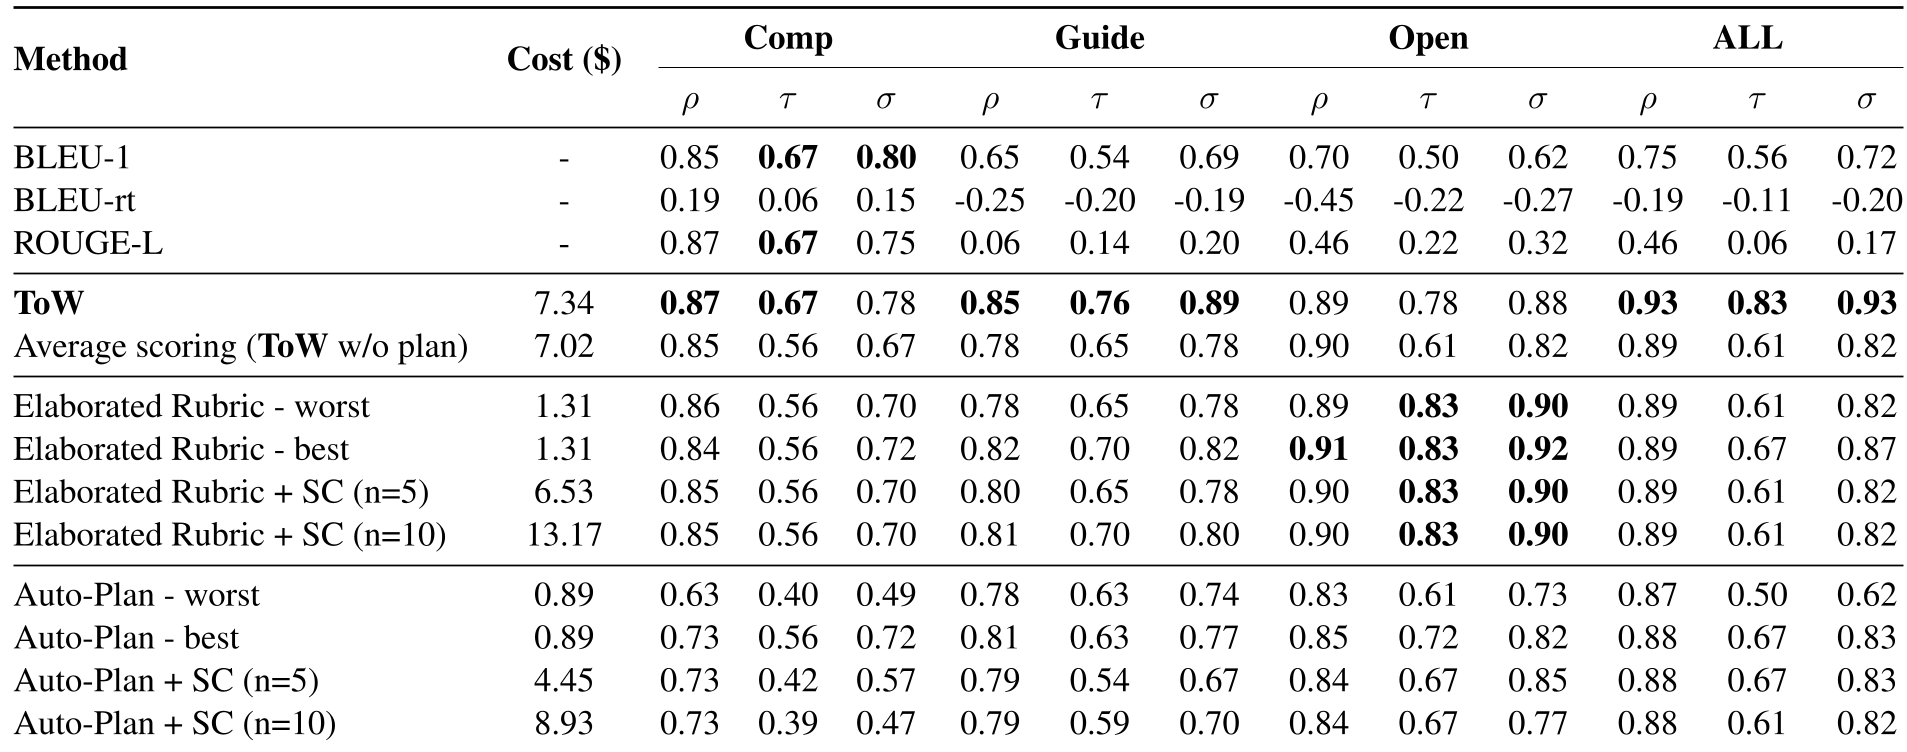 表 1:不同评估方法与人类评分的相关性对比,ToW (ρ=0.93) 位居榜首。
深度洞察与总结
核心贡献 (Takeaway)
ToW 不仅仅是一个评分工具,它通过显式的权重协商将大模型的“直觉打分”转化为“逻辑推导”。这对于需要定制化评价标准的行业(如专业文案审查、学术写作辅导)提供了重要参考。
局限性与未来 (Limitations)
- 跨语言扩展:目前主要关注中文,虽然已有初步英语测试,但多语言泛化性仍需规模化验证。
- 效率问题:多 Agent 的 DFS 评分过程相比单次 Prompt 成本更高,需要进一步优化。
总的来说,HoWToBench 和 ToW 框架标志着大模型评估从单纯的“答案对错”转向了复杂的“审美逻辑”,是通往人类水平创作能力评测的重要一步。