
HumanNet:百万小时级人类视频,能否成为具身智能的“数据圣杯”?
HumanNet: Scaling Human-centric Video Learning to One Million Hours
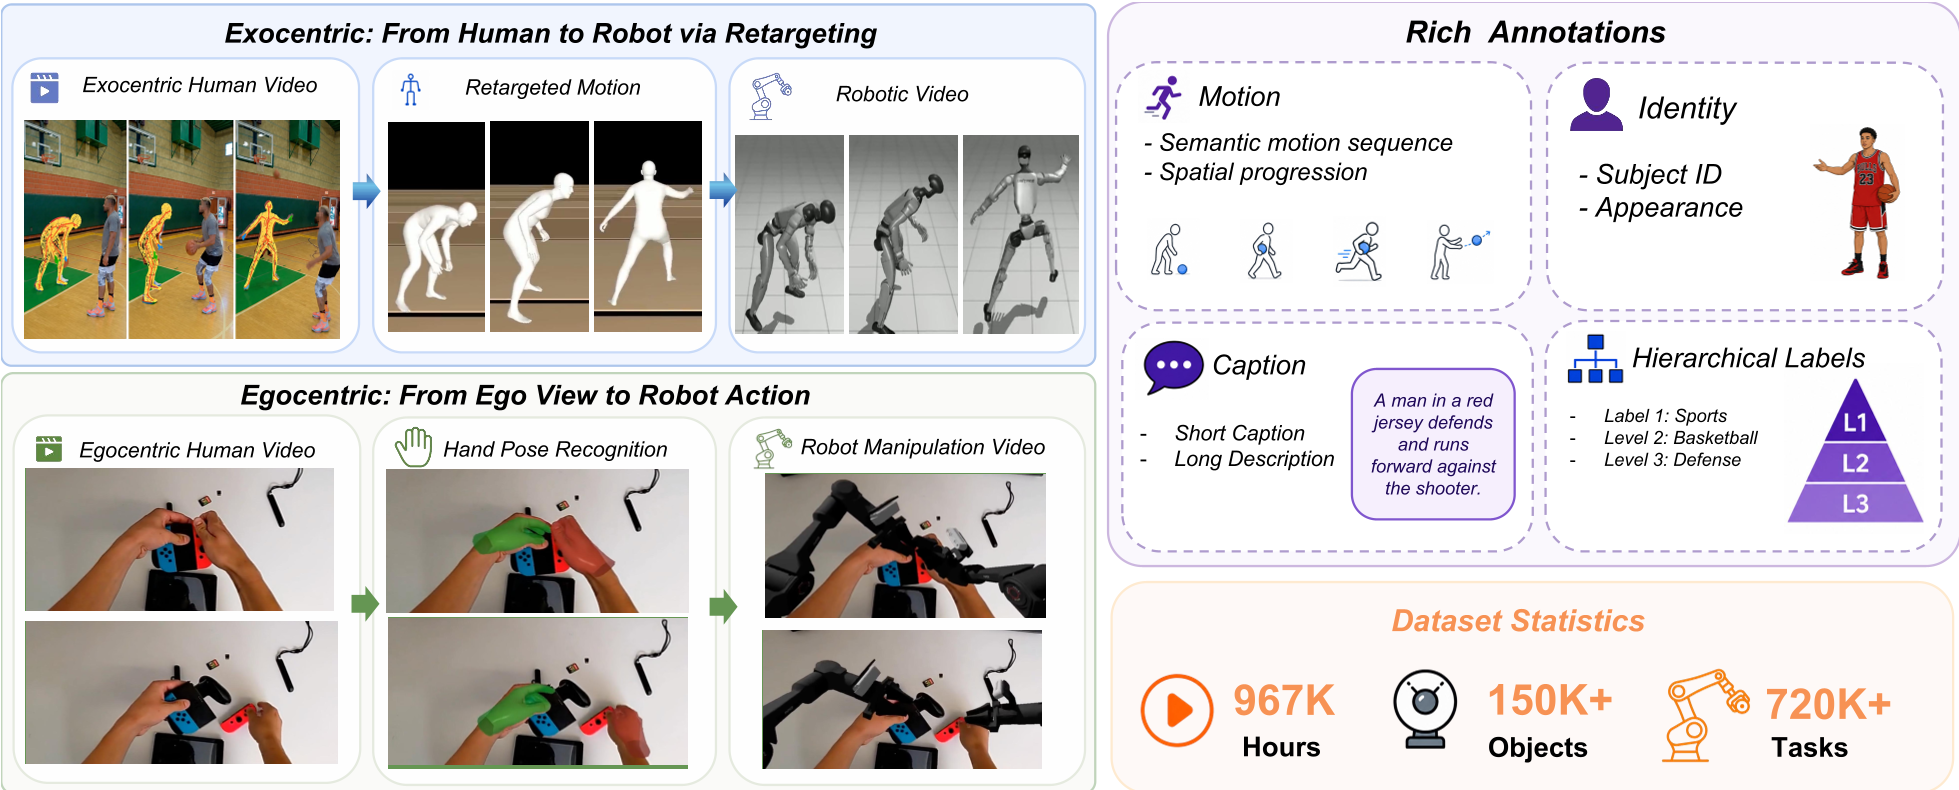
本文推出了 HumanNet,一个规模达 100 万小时的以人为中心(Human-centric)的视频数据集。该工作通过集成第一人称(Ego)与第三人称(Exo)视角,配合运动(Motion)和交互(Interaction)标注,旨在为具身智能(Embodied AI)提供比机器人实操数据更具扩展性的替代方案。
TL;DR
物理AI的瓶颈从未如此清晰:我们拥有百亿级的文本,却极度匮乏高质量的物理交互数据。北京大学等机构的研究团队推出的 HumanNet 通过提供 1,000,000 小时 的以人为中心的视频,彻底打破了此前数据集(如 Ego4D 的 3000 多小时)的规模限制。实验证明,1,000 小时的人类视角视频预训练效果,竟然可以叫板 100 小时的真实机器人数据。
痛点深挖:昂贵的机器人,匮乏的灵性
目前训练具身大模型(VLA)主要依赖两条路径:
- 真实机器人遥操作:成本极其高昂,数据覆盖面窄(只能在实验室里玩玩特定任务)。
- 互联网视频:虽然量大管饱,但大部分是看猫片或跳舞,缺乏机器人真正需要的“手-物交互”细节和“物理因果关系”。
现有方法如 Ego4D 虽然提供了第一人称视角,但在规模和任务深度上仍难以支撑起真正的通用具身大模型。
核心逻辑:从第一人称到第三人称的物理对齐
HumanNet 的设计哲学非常明确:Scale 产生灵性,Viewpoint 提供线索。
- 第一人称视角 (Egocentric):捕捉接触力学、动作意图(Action Intent)以及视觉上的电机决策后果。
- 第三人称视角 (Exocetnic):补充全身运动、人体姿态以及场景级的空间动力学。
为了将杂乱的互联网视频转化为“训练可用”的资产,作者设计了一个复杂的标注管线,包括 3D 全身姿态检测、运动重定向(Retargeting)以及 LLM 辅助生成的语义标签。
方法论详解:如何炼成百万小时数据集?
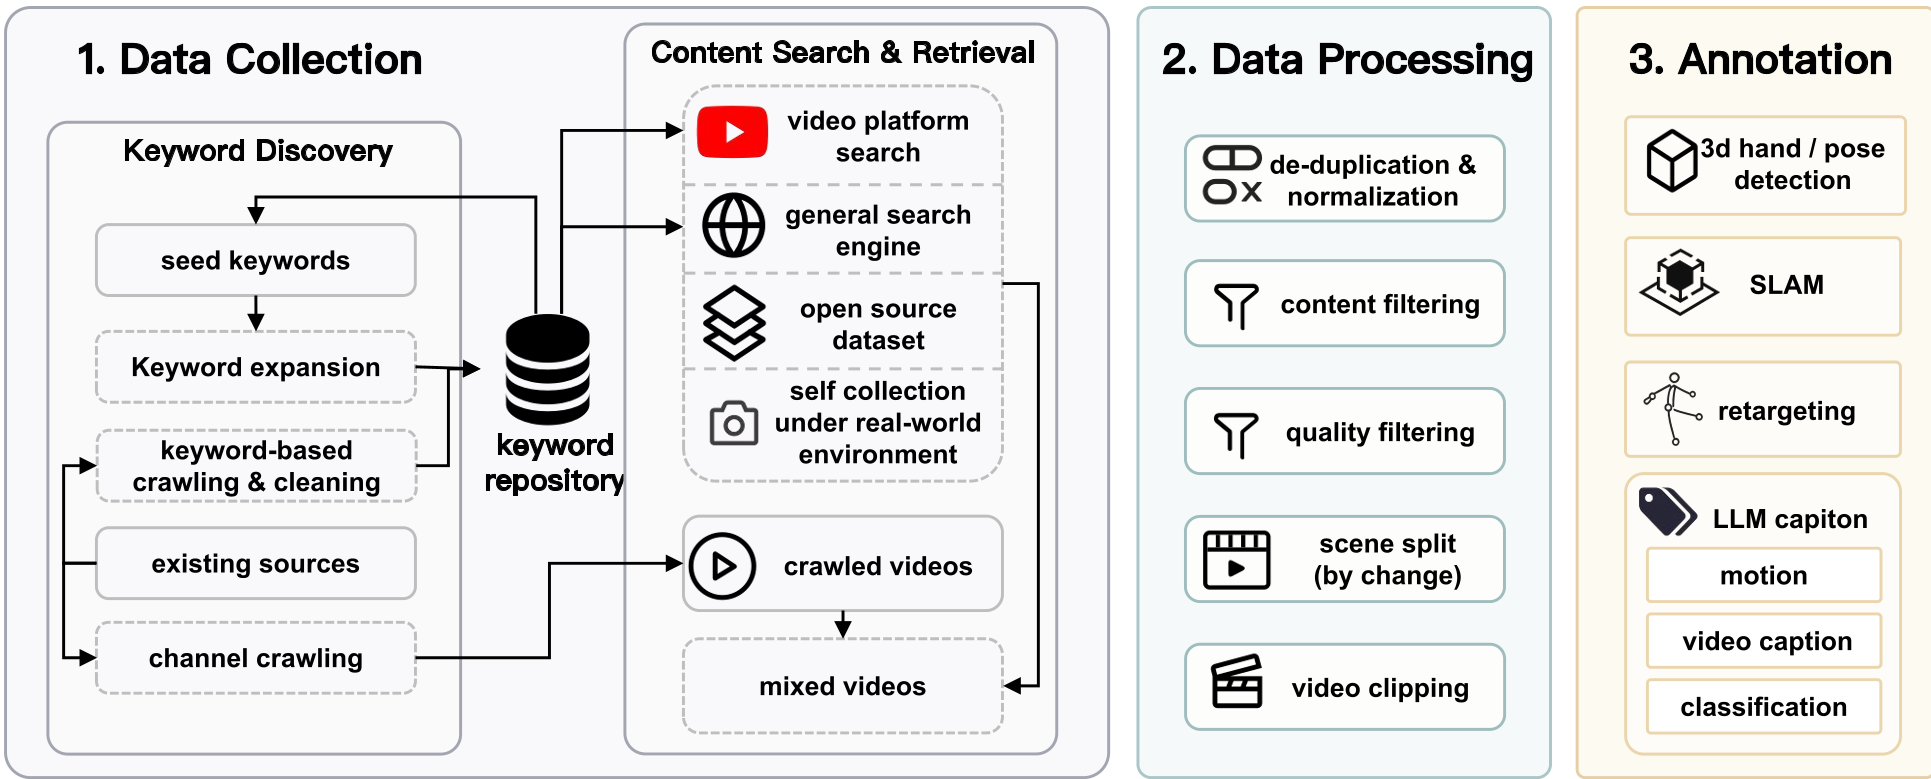
HumanNet 的数据处理流程分为三步:
- 大规模采集:利用关键词扩展和频道爬取,不仅从开放数据集白嫖,还自研了一套真实世界采集系统。
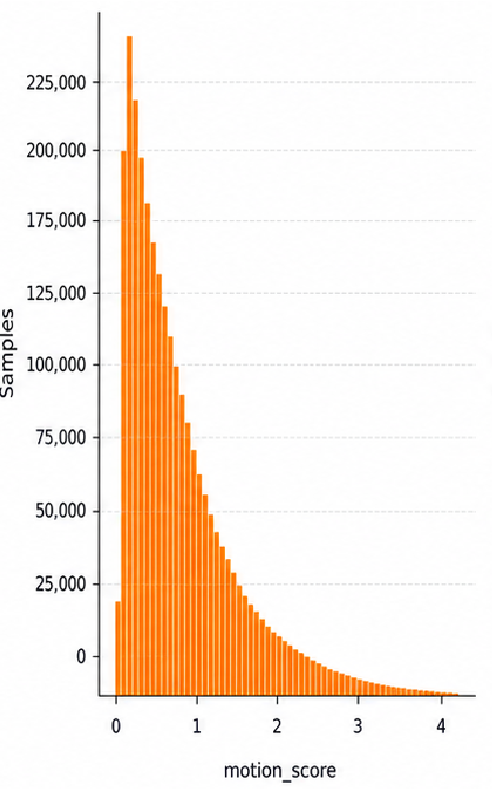
- 物理过滤:排除掉那些静态、模糊或与交互无关的废片。
- 富标注映射:这是最关键的一步,系统将人类的动作映射到统一的人形骨架(Humanoid Skeleton)上,当重定向误差低于 15mm 时,该片段才被标记为 "Robot-ready"。
实验与结果:人类视频真的能替代机器人吗?
这是本文最令人兴奋的发现。在相同的 LingBot-VLA 架构下,研究人员对比了四种初始化方案:
- 对比 1:Qwen 原始视觉模型。
- 对比 2:100 小时真机 CoBot 数据微调。
- 对比 3:1,000 小时 HumanNet 第一人称视频微调。
- 结论:在多个验证任务组中,1,000 小时人类数据展现出的迁移能力,竟然在部分指标上优于 100 小时真机数据。这意味着人类视频捕捉到了更普适的“操作先验”。
深度洞察与总结
HumanNet 的核心价值在于解耦了“具身”与“机器人实操”。 以往我们认为训练机器人模型必须用机器人数据,但 HumanNet 证明了:只要数据规模足够大、标注足够物理(Motion-aware),高质量的人类活动记录完全可以作为具身智能的底层基架。
局限性与挑战
虽有百万小时,但 Human-Robot Embodiment Gap(人类手部与机器人夹爪的区别)依然存在。此外,海量数据中的长尾偏差和隐私泄露风险(如第一人称视频拍到隐私文档)仍是未来应用中亟待解决的红线问题。
总结 (Takeaway):如果说 GPT 开启了语言的 Scaling Law,那么 HumanNet 正在尝试为物理世界的操作(Manipulation)开启同样的进程。