
HiVLA:视觉引导下的分层解耦,让机器人掌握精准操纵的“脑”与“手”
HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System
HiVLA 提出了一种以视觉分块(Visual-Grounded)为核心的分层具身智能操纵系统。该系统利用 VLM 进行高层语义规划和目标定位,并配合一个基于 Flow-matching 的 Diffusion Transformer (DiT) 动作专家实现底层控制,在 RoboTwin 2.0 仿真中相较 π0 提升了 42.7% 的成功率。
TL;DR
HiVLA (Hierarchical Visual-Grounded VLA) 重新思考了具身智能中“思考”与“执行”的关系。它通过将 VLM 强推理规划器与高频 DiT 动作专家显式解耦,解决了端到端模型微调后的能力退化问题。其核心亮点在于利用视觉定位(Grounding)作为桥梁,通过高清局部裁剪图和级联注意力机制,让机器人在杂乱环境中也能精准“拿捏”微小物体。
核心速览:告别“顾此失彼”
目前的端到端 VLA 模型(如 RT-2, π0)正面临一个基本权衡:为了让机器人学会特定的动作,必须在有限的机器人数据上微调 VLM,但这往往会导致 VLM 丧失其在互联网规模数据上习得的通用常识推理能力。
HiVLA 的核心定位是:不仅要分层,更要以“视觉定位”为核心进行感知增强。 它在领域坐标系中属于典型的层次化系统(Hierarchical System),但比前人更进了一步——它解决了如何将高层的“定位信息”无损地传递给底层“执行器”的难题。
痛点深挖:消失的空间细节
为什么现有的层次化模型表现不佳?
- 分辨率冲突:全局图像往往分辨率较低,小物体的特征在下采样中消失了。
- 坐标系丢失:如果只切出物体的局部图送入策略,机器人会丢失该物体在全局空间中的绝对位置。
- 语义负担:让底层策略同时理解复杂指令和执行动作会造成过重的认知负荷。
方法论详解:脑、眼、手的协同
HiVLA 的架构由两个核心模块组成:
1. VLM 规划器(大脑):视觉引导的决策
使用 Qwen3-VL 作为 Planner。给定任务(如“把三个方块叠起来”),它不直接输出动作,而是生成一个 JSON:
- Subtask: 拆解后的具体步骤(如 "Pick the blue block")。
- Bounding Box: 目标物体的精确坐标。
- 工具调用:调用 Image Crop 工具,从原始的高清(1080p)图像中切出目标区域。
2. DiT 动作专家(手):级联交叉注意力
这是本文的精华所在。在每个 Transformer 模块中,动作 tokens 会依次经过三层 Cross-attention:
- Stage 1 (Global):感知全局环境布局。
- Stage 2 (Local + Positional Encoding):结合局部高清细节与绝对坐标信息(Abs PE)。这解决了小物体的特征保真度和全局定位的矛盾。
- Stage 3 (Task Skill):注入子任务语义。

实验与结果:统治级表现
HiVLA 在 RoboTwin 2.0 仿真平台上进行了严苛的测试,尤其是那些涉及“点铃铛”、“按订书机”等需要极高视觉精度的任务。
| 任务类型 | π0 (SOTA) | H-RDT (Baseline) | HiVLA (Ours) | 提升比例 |
|---|---|---|---|---|
| 简单任务 | 54.3% | 90.5% | 96.0% | +5.5% |
| 困难任务 | 38.6% | 54.6% | 73.2% | +18.6% |
| 总平均 | 45.6% | 70.6% | 83.3% | +12.7% |
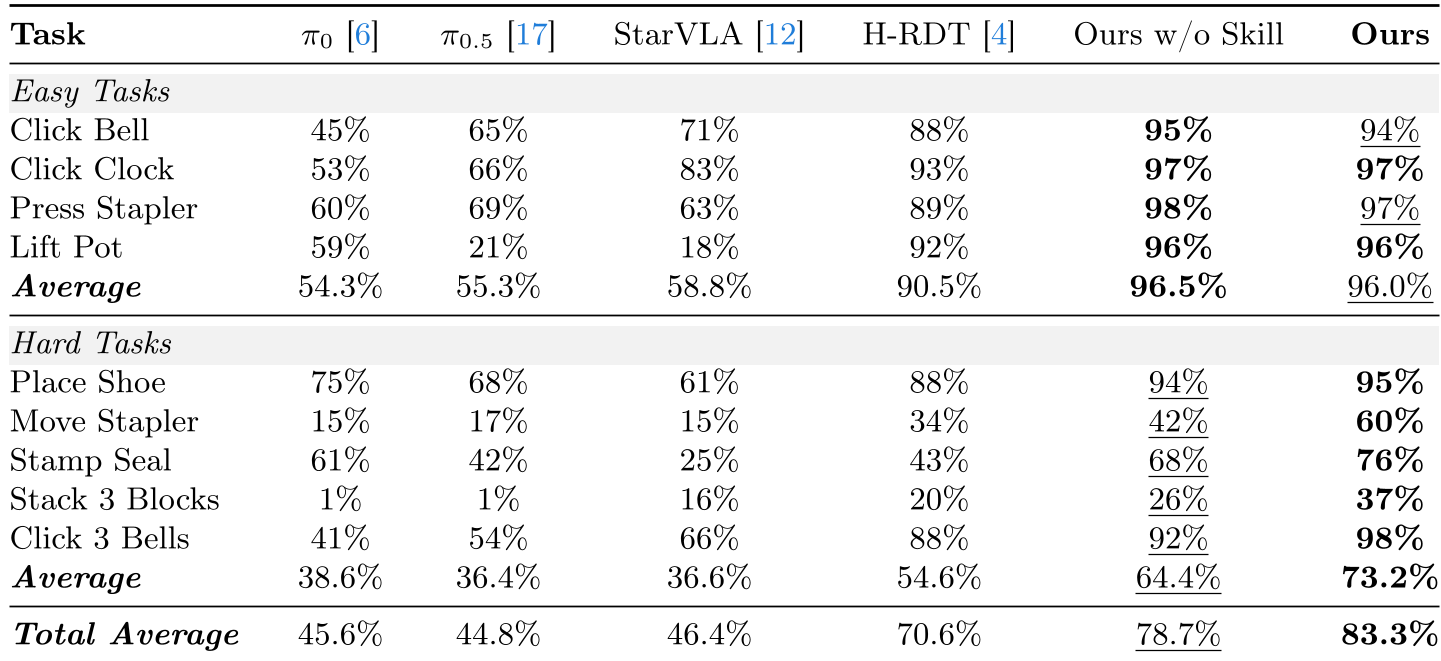
两个关键发现:
- 由粗到细的路径是关键:消融实验显示,如果调换 Global 和 Local 的注入顺序,性能会下降。这种“先看大局,再盯局部,最后对齐指令”的顺序最符合操纵直觉。
- 错误纠正能力:如果底层动作专家由于干扰没抓稳,高层 VLM 规划器会通过视觉反馈发现子任务未完成,从而重新下达指令。这是端到端模型难以实现的“语义闭环”。
深度洞察与总结
核心贡献 (Takeaway)
- 解耦的胜利:通过视觉定位 BBox 作为中间接口,既保留了 VLM 的逻辑,又让 DiT 专注于运动控制。
- 空间感知增强:Positional Encoding 的加入让局部裁剪图不再是“无根浮萍”,解决了局部与全局的坐标对齐。
局限性与展望
目前的系统仍存在延迟瓶颈(VLM 推理约 1.9s,虽然异步执行可缓解,但非纯实时)。未来研究可以探索更轻量级的 VLM 规划器,或者将这种“级联注意力”扩展到多模态时序融合中。
总的来说,HiVLA 标志着 VLA 模型从“一锅端”迈向了更加理性、模块化的层次化演进。