
CaOPD:破解 LLM“自信迷思”,实现能力与校准的完美解耦
The Illusion of Certainty: Decoupling Capability and Calibration in On-Policy Distillation
本文针对大语言模型在在线策略蒸馏(On-Policy Distillation, OPD)后出现的严重置信度失真问题,提出了 CaOPD 框架。该方法通过解耦能力克隆与置信度监督,在不损失模型推理能力的条件下,使模型在单次前向传播中输出高度校准的置信度,显著缓解了 LLM 的盲目乐观倾向。
TL;DR
大语言模型(LLM)正面临一个悖论:模型越聪明(推理能力越强),它就越容易对错误答案表现出“迷之自信”。Salesforce AI Research 的这篇论文揭示了这种现象的根源在于主流的**在线策略蒸馏(On-Policy Distillation, OPD)**算法。为了解决这一痛点,作者提出了 CaOPD 框架,通过引入基于学生端轨迹的经验置信度目标,成功打破了“能力提升必导致校准失效”的魔咒。
核心速览
目前的 LLM 后训练范式广泛采用自蒸馏。然而,作者发现这种范式隐藏着一个**“误校准缩放定律”(Scaling Law of Miscalibration)**:无论是 GPT-4 级别的闭源模型,还是各种规模的开源模型,一旦通过特权信息进行蒸馏,其置信度就会向 1.0 极端收敛。
CaOPD 的贡献在于:
- 理论证明:证明了信息不对称必然导致熵崩塌和乐观偏差。
- 非侵入式架构:无需复杂的强化学习奖励设计,通过简单的目标替换即可实现优化。
- 性能突破:通过 8B 模型实现了可比肩顶级 API 的可靠性,且具有极强的分布外(OOD)泛化能力。
痛点深挖:为什么 LLM 总是“死不认错”?
在标准的 OPD 过程中,Teacher 模型处于“开卷考试”状态——它能看到正确答案或环境反馈(Privileged Context)。而 Student 模型处于“闭卷”状态。
蒸馏的本质是让 Student 模仿 Teacher 的输出概率分布。当 Teacher 因为看到了答案而表现得极其确定时,Student 也会被迫在 logits 层面进行“人工锐化”以匹配这种分布。结果就是:Student 学会了像 Teacher 那样说话(充满信心),却没有学到 Teacher 手里的证据。
方法论详解:CaOPD 的“降噪”艺术
CaOPD 的核心思路非常直观:上帝的规上帝,凯撒的规凯撒。 将“回答什么”和“对自己有多大把握”这两个监督目标拆分开来。
1. 构建“接地气”的目标
CaOPD 不再信任 Teacher 那个“开卷”的置信度,而是让 Student 针对同一个问题跑 K 次采样(Rollouts)。通过客观验证器(Verifier)计算这 K 次的平均得分。这个得分反映了 Student 此时此刻真实的业务水平。
2. 目标替换(Target Replacement)
在损失函数计算前,CaOPD 会执行一个精准的“外科手术”:保留 Teacher 的推理轨迹监督,但把置信度 Token 强行改为刚才计算出的经验成功率。
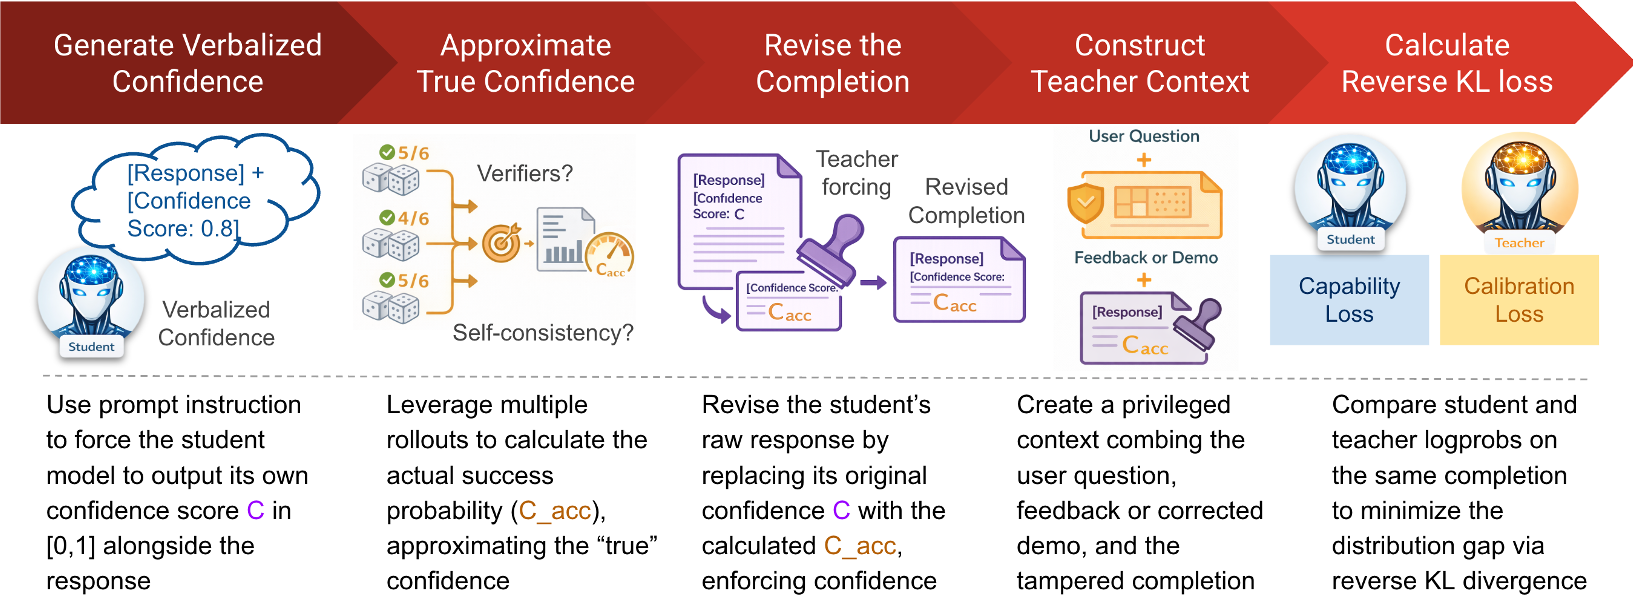 图 1:CaOPD 框架工作流,展示了如何通过多次采样修正置信度目标。
实验与结果:不交“能力税”的校准
长期以来,通过强化学习(RL)校准模型置信度往往需要付出**“能力税”(Capability Tax)**,即模型为了避免被罚,会变得过度保守,导致推理准确率下降。
CaOPD 的实验结果令人惊喜:
- Pareto 最优:在 Qwen3 家族(0.6B 到 32B)上,CaOPD 均在保持 Accuracy 的同时,大幅降低了 Brier Score 和 ECE。
- 结构性重塑:从下图中可以看出,CaOPD 将模型从盲目自信的红区拉回了理想的校准线(对角线)。
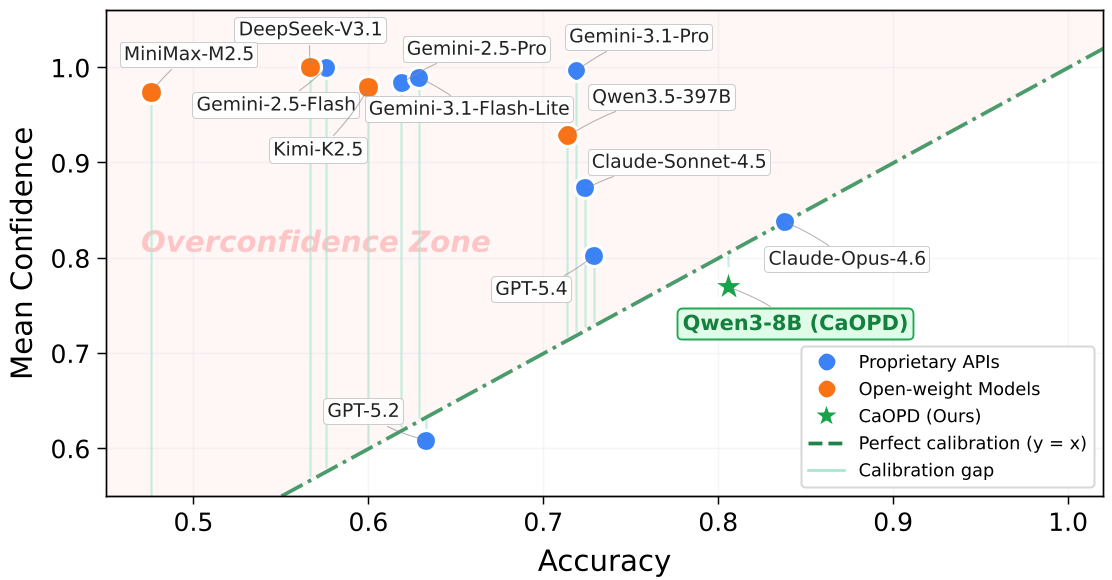 图 2:置信度与准确率对比图。CaOPD(绿点)相比传统方法(红区点)更接近理想对角线。
此外,CaOPD 在持续学习(Continual Learning)中表现优异。传统方法在学习新知识后,旧知识的校准性会迅速腐化(Calibration Forgetting),而 CaOPD 通过不断地锚定学生端轨迹,成功保持了校准的稳定性。
深度洞察与总结
为什么这很重要?
如果一个 8B 的小模型能准确告诉系统“我不确定”,我们就可以构建联级推理系统(Cascade Routing):小模型有把握时直接回复,没把握时再请求大模型。这能极大降低工业界的推理成本。
局限性
- 采样成本:训练时需要多次 Rollout(论文建议 K=8),这增加了训练开销,虽然推理时是零开销的。
- 格式依赖:依赖于模型输出特定格式的置信度 Token,这对超小模型可能存在指令遵循的压力。
总结
CaOPD 的成功证明了:置信度不应该通过单纯的“模仿”获得,而应该通过“自我反省”产生。通过将测试时的自我一致性能力摊销(Amortize)到参数中,我们终于有望得到一个既聪明又诚实的 AI 助手。