
ICR:告别“过度思考”,让 LLM 推理直击要害
Implicit Compression Regularization: Concise Reasoning via Internal Shorter Distributions in RL Post-Training
本文提出了隐式压缩正则化 (ICR),一种旨在解决大语言模型在强化学习 (RL) 后训练中出现“过度思考 (Overthinking)”问题的在线正则化方法。ICR 通过利用 rollout 组内最短的正确样本作为目标,诱导虚拟的简洁分布,在不牺牲准确率的前提下显著缩短了推理轨迹,在数学和知识密集型任务中达到了更优的 Accuracy-Length 帕累托前沿。
TL;DR
在 RL 后训练阶段,推理模型(如 o1-like models)常陷入反复验证、自我纠结的“过度思考”泥潭。本文提出了 Implicit Compression Regularization (ICR),它不靠生硬的长度惩罚,而是通过“择优录取”——即强化策略本身生成的那些既短又对的路径,实现了在提升准确率的同时,大幅压低推理成本,刷新了推理效率的 Pareto 前沿。
痛点深挖:为什么“短一点”这么难?
目前的推理模型在通过强化学习(RLVR)获得强大性能的同时,也产生了一个副作用:模型发现写得越长、反复思考越多,拿到正确奖赏的概率越高。这导致了 Overthinking:
- 显式长度惩罚 (LP):如果你直接在 Reward 后面扣除长度分,模型会学会“偷工减料”,导致 Underthinking(没想全就给答案),准确率断崖式下跌。
- 强制早停 (Early-exit):在复杂的数学竞赛题中,后半部分的推导往往至关重要,暴力截断会直接毁掉推理质量。
作者发现了一个关键的 Insight:在训练的早期,如果看同一个问题的多个采样,那些更短的正确答案往往代表了更清晰的逻辑。但随着长度惩罚的加入,这个“短即是美”的特征会逐渐消失。
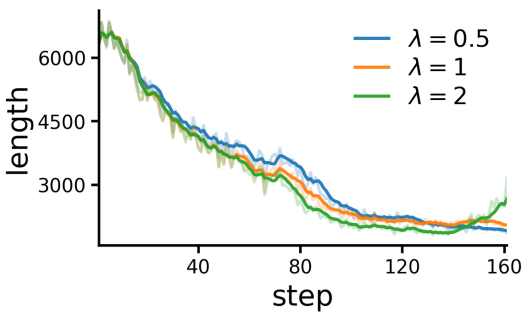
核心方法:隐式压缩正则化 (ICR)
与其用皮鞭(惩罚)逼迫模型缩短,不如用奖赏(正则化)诱导模型模仿自己最简洁的高光时刻。
1. 重新定义过度思考
论文提出了一个极具物理直觉的判断标准:
- 负相关 (Overthinking):当组内更短的回复往往更准确时,说明模型有冗余水分可以榨干。
- 正相关 (Underthinking):当回复越长准确率越高时,说明模型还没想清楚,不宜强行压缩。
2. 虚拟分布引导
ICR 的操作非常优雅。在每一轮采样(Rollout)中:
- 对同一个 Query 采样 个回复。
- 在所有正确的回复中,找到最短的那一个 。
- 在标准的 GRPO 目标之外,增加一个正则化项,强制模型向这个“最短正确回复”靠拢。
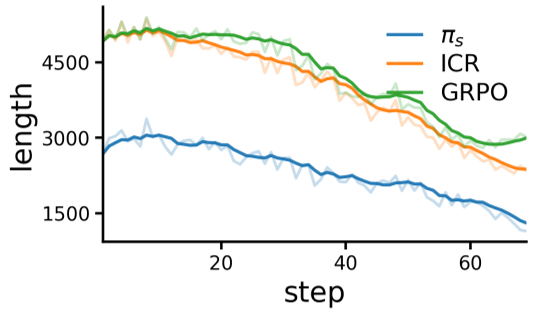
这种做法的本质是:利用策略本身已经发现的简洁路径作为示范,进行在线的分布校准。
实验与结果:鱼与熊掌兼得
实验在 Qwen3 和 DS-R1-Distill 等强基座上展开,覆盖了 AIME、AMC、MMLU-Pro 等硬核榜单。
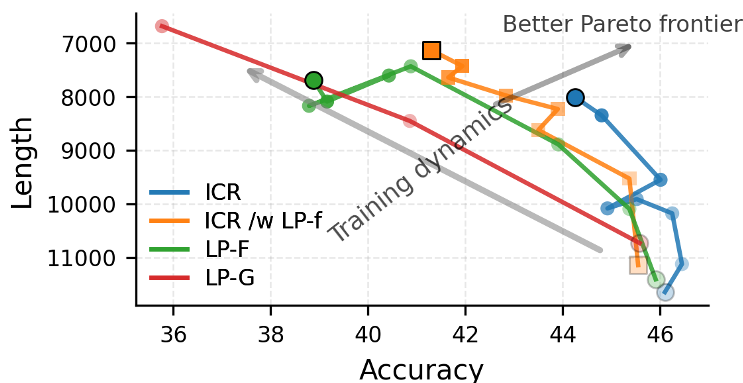
- 准确率不降反升:在 Math500 上,Qwen3-8B 使用 ICR 后,准度从 93.6% 提升到 95.0%。
- 效率大幅提升:平均 tokens 长度显著下降。更重要的是,ICR 展现出了惊人的 Pareto Frontier 优势——在同样的长度压缩下,它的准确率始终高于传统的长度惩罚方法。
深度洞察
ICR 的成功证明了一个道理:在复杂推理任务中,“如何思考”比“思考多久”更重要。 显式的惩罚改变了问题的“目标”(Objective),让模型分心去关注字数统计;而 ICR 改变的是模型的“习惯”(Inductive Bias),它通过强化高效的思维路径,让模型在保持逻辑严密性的同时,自然而然地选择更简洁的表述。
局限性与展望
目前 ICR 依赖于批次级别的统计。正如作者在附录中所言,未来的研究可以深入到实例级别甚至步骤级别的压缩。有些极难的高等数学问题可能天然需要极长的推理,如何动态识别每一个思维步骤是否存在“水分”,将是实现真正的“无损压缩”的关键。
总结
ICR 提供了一种无需修改奖励函数、无需额外训练成本的推理加速方案。它告诉我们,最高效的推理往往已经存在于模型自己的探索之中,我们要做的,只是把它找出来并赋予更强的权重。