
IntentGrasp:揭秘大模型在“意图理解”上的集体滑铁卢
IntentGrasp: A Comprehensive Benchmark for Intent Understanding
本文推出了 IntentGrasp,这是一个包含 12 个领域、49 个数据集的 LLM 意图理解(Intent Understanding)综合性基准测试。通过统一的任务格式和高质量的意图标签重构,研究评估了包括 GPT-5.4 和 Claude-4.7 在内的 20 种前沿模型。
TL;DR
在 2026 年的学术坐标系中,大模型已经能写代码、做科研,但它们真的“懂”你的心思吗?UBC 的研究者们发布的 IntentGrasp 基准测试给出了一个扎心的结论:包括 GPT-5.4、Claude-4.7 在内的顶尖模型,在处理复杂、多领域的意图理解时,表现甚至不如随机猜测。本文不仅提出了一个覆盖 12 大领域的庞大评测体系,还证明了通过“意图微调(IFT)”可以显著逆转这一局势。
1. 痛点:被忽视的语言学“深水区”
人类沟通不仅仅是文字的排列组合,其核心是意图(Intent)。现有的意图识别工作(如早期处理机票预订或银行咨询的数据集)存在两个严重局限:
- 领域碎片化:大多聚焦在简单的日常任务(Daily Life),一旦进入医疗、法律、科研等专业领域,模型就会迷失。
- 标签贫瘠化:传统的“分类标签”往往只有 1-2 个单词(如 "uses")。没有上下文,模型根本不知道这个 "uses" 是指“使用某种方法”还是“引用某种数据”。
2. IntentGrasp:重构意图理解的坐标系
为了打破局限,作者从 49 个高质量语料库中提取了 12 个领域(从毒性言论检测到政策制定),并执行了关键的意图标签语境化(Contextualization)。
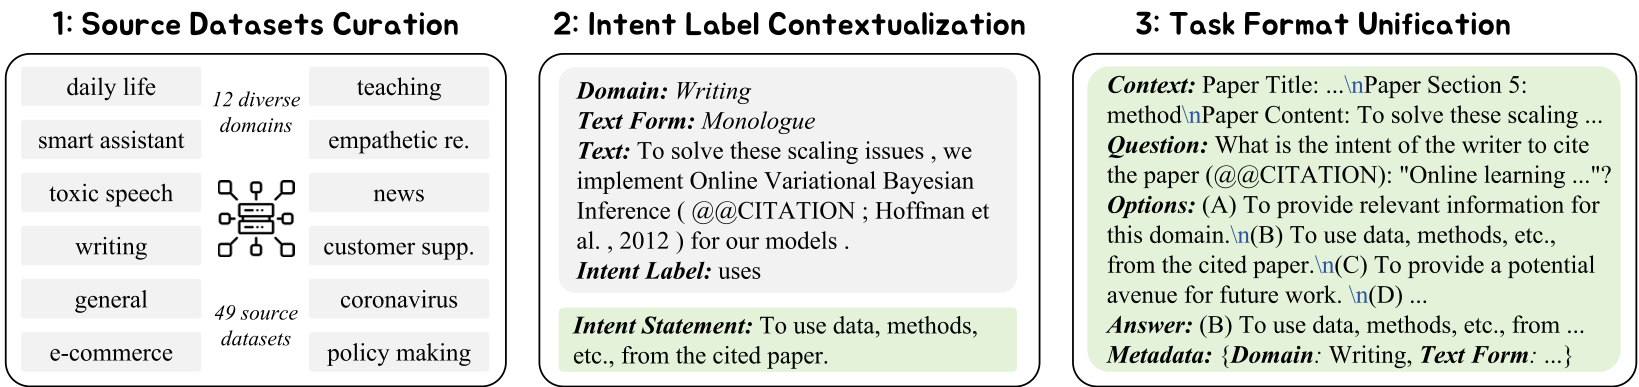 注:模型不再是简单的分类器,而是需要从多个“意图声明”中选出正确答案。
3. 实验发现:前沿模型的“群体失聪”
作者评估了 Llama3、Qwen3、GPT-5、Gemini-3 和 Claude-4 等 7 个家族的 20 个模型。结果令人震惊:
- Gem Set 噩梦:在最具挑战性的子集(Gem Set)上,大部分模型的 F1 分数低于 15.2%(随机猜测线)。
- 人机鸿沟:人类在这些任务上的表现约为 81.1%,而最强的商业模型如 Gemini-3.1-Pro 也仅能达到 20% 出头。
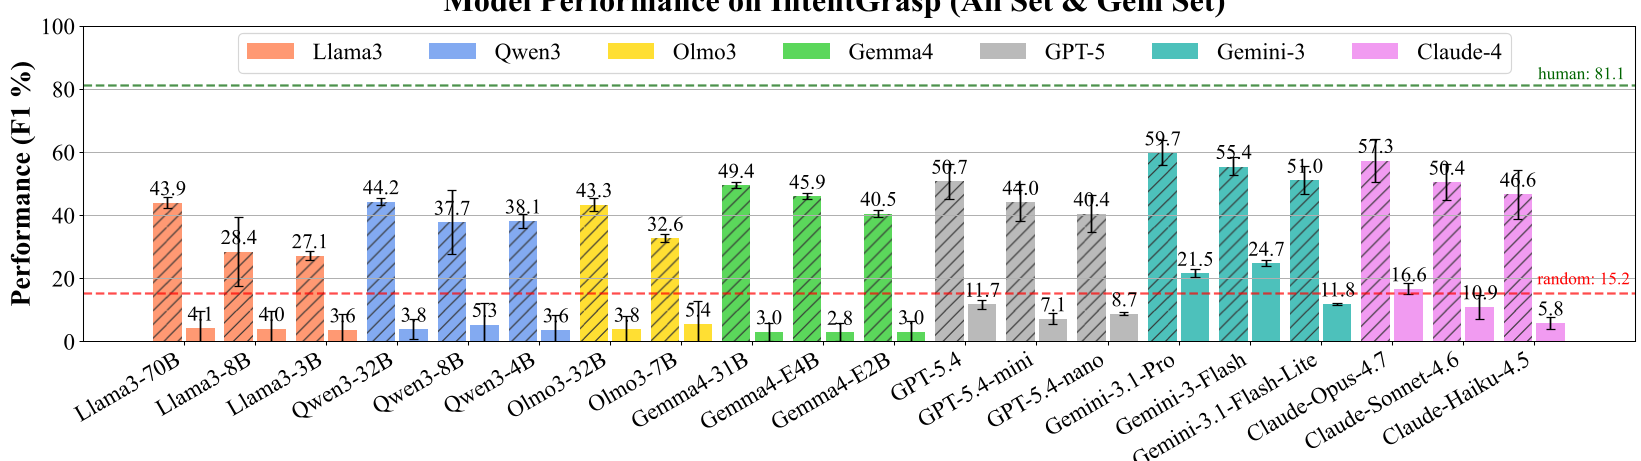 图示:无论是开源还是闭源模型,在意图理解面前都显得力不从心。
4. 破局之道:意图微调(IFT)
既然 Scaling Law 无法自动带来意图理解的飞跃,作者提出了 Intentional Fine-Tuning (IFT)。
- 方法:在 IntentGrasp 提供的 26 万条训练数据上进行监督微调(SFT)。
- 效果:经过 IFT 的 Qwen3-4B 模型在 All Set 上提升了 30+ F1 点,甚至超越了未经过此类训练的 GPT-5.4 和 Gemini-3.1-Pro。
更难能可贵的是,IFT 展现了极强的 Lodo(留一领域验证)能力。即使该领域在训练中未曾出现,IFT 也能通过学习通用的意图逻辑来提升表现。
5. 深度洞察与展望
这项研究指出了一个关键方向:AI 的安全性高度依赖于由于意图理解。 如果 AI 不能理解用户恶毒提问背后的真实意图(Malicious Intent),安全护栏就会形同虚设;如果医疗机器人理解错了个人的健康诉求(Intent),后果将是灾难性的。
局限性:目前的 IntentGrasp 仍局限于文本和英文。未来的 SOTA 竞争将转向多模态(Multimodal)和多文化(Multicultural)下的意图捕捉。
总结
IntentGrasp 不仅仅是一个数据集,它是对当前“大模型无所不能”论调的一剂清醒剂。要实现真正智能、安全的 AI 助手,我们必须让模型从“文字搬运工”进化为真正的“意图洞察者”。
本文由资深学术技术主编重构。