
[研界重磅] Intern-S1-Pro:万亿参数开启“科学多模态”新纪元
Intern-S1-Pro: Scientific Multimodal Foundation Model at Trillion Scale
本文推出了 Intern-S1-Pro,这是全球首个万亿参数(1T)级别的科学多模态大模型。该模型在保持顶尖通用能力的同时,通过大规模科学数据强化,在化学、生物、材料和地球科学等 100 多个专业任务中超越了 GPT-5.2 和 Gemini-3-Pro 等闭源模型。
TL;DR
上海人工智能实验室(Shanghai AI Lab)正式发布 Intern-S1-Pro。作为全球首个 1 Trillion (万亿) 参数规模的科学多模态基座模型,它不仅刷新了通用能力的 SOTA 榜单,更通过创新的 Grouped Routing 架构和 6T tokens 的高质量科学数据灌注,在生物、化学、地球科学等 100+ 领域展现出碾压闭源模型的推理深度。
1. 为什么我们需要万亿参数的“科学通才”?
在 AI for Science (AI4S) 领域,模型面临的“语言”远比自然语言复杂:蛋白质序列、化学分子式、卫星遥感影像、高频时间序列信号。这些数据具有极高的领域密度和长尾属性。
作者通过对比发现,科学领域的复杂性类似于多语言翻译任务——当任务种类增加时,模型容量必须呈指数级增长。Intern-S1-Pro 的动机非常明确:只有足够大的模型(Scaling Law),才能在不牺牲通用逻辑的前提下,深度理解物理世界的底层规律。
2. 核心架构:解决万亿 MoE 的“成长烦恼”
由于 Intern-S1-Pro 采用了稀疏 Mixture-of-Experts (MoE) 架构,如何在万亿参数规模下保持训练稳定是一个巨大的挑战。
2.1 分组路由 (Grouped Routing)
传统的 Top-K 路由在万亿规模下极易导致某些“明星专家”过载而其他专家闲置,甚至引发 OOM。作者设计了 Grouped Routing,将专家按设备均匀分组,强制每个组内进行局部 Top-K 选择。
- 直觉:这类似于在公司管理中,不是让全公司 1000 人去抢 8 个任务,而是分到 8 个小组,每组内部选出最强的 1 个人负责,从而确保了各机器间的负载绝对均衡。
2.2 直通估计器 (Straight-Through Estimator)
MoE 路由通常是不可导的离散操作。本文引入了 STE(见下图右侧),在反向传播时让梯度流经全量 softmax 分布,确保即使是当前未被选中的专家也能得到更新信号,避免了专家“僵化”。
 图 1:SAGE 框架与专家扩展逻辑
3. 物理直觉:从“粒子”到“波”的表征飞跃
文本 Token 化本质上是将信息视为离散的粒子。但光、电、声等科学数据本质是波。
- FoPE (Fourier Position Encoding):Intern-S1-Pro 引入傅里叶位置编码。它不仅仅是顺序编码,而是利用傅里叶变换捕捉信号的频谱特性,从物理底层弥合了语言模型处理连续物理信号时的表征缺口。
- 自适应时序编码器:针对跨度极大的科学时间序列(如 EEG 或天文信号),模型能够根据采样率动态调整 Patch 大小,支持从 100 到 1,000,000 个时间步的输入。
4. 数据炼金:让科学数据“说人话”
直接将结构化的 PubChem 数据库或 PDF 中的冷冰冰表格喂给模型会导致分布偏移(Distribution Shift)。Intern-S1-Pro 采用了三大策略:
- 结构化转换:通过模板将矩阵、分子式转化为叙事性文本。
- 数据多样化:利用强化学习(Rollout)技术,将简单的知识问答转化为复杂的逻辑演绎链。
- 系统提示隔离 (System Prompt Isolation):为科学任务和通用任务注入互斥的 Prefix,在万亿参数空间中为不同的知识领域开辟“平行宇宙”。
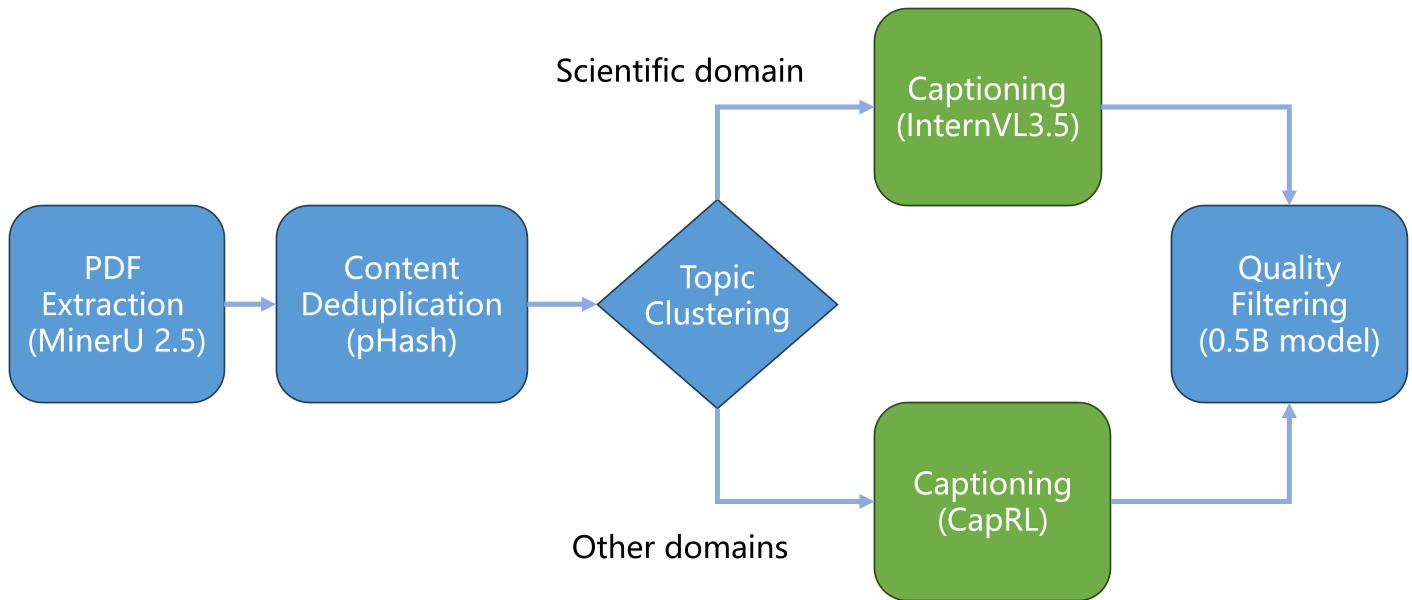 图 2:针对 PDF 科研文献定制的 Caption 生成流程
5. 实验战绩:科学能力的维度打击
在科学推理基准 SciReasoner 上,Intern-S1-Pro 拿到了 55.5 的高分。相比之下,GPT-5.2 (13.6) 和 Gemini-3-Pro (14.7) 在专业科学逻辑上显得较为薄弱。
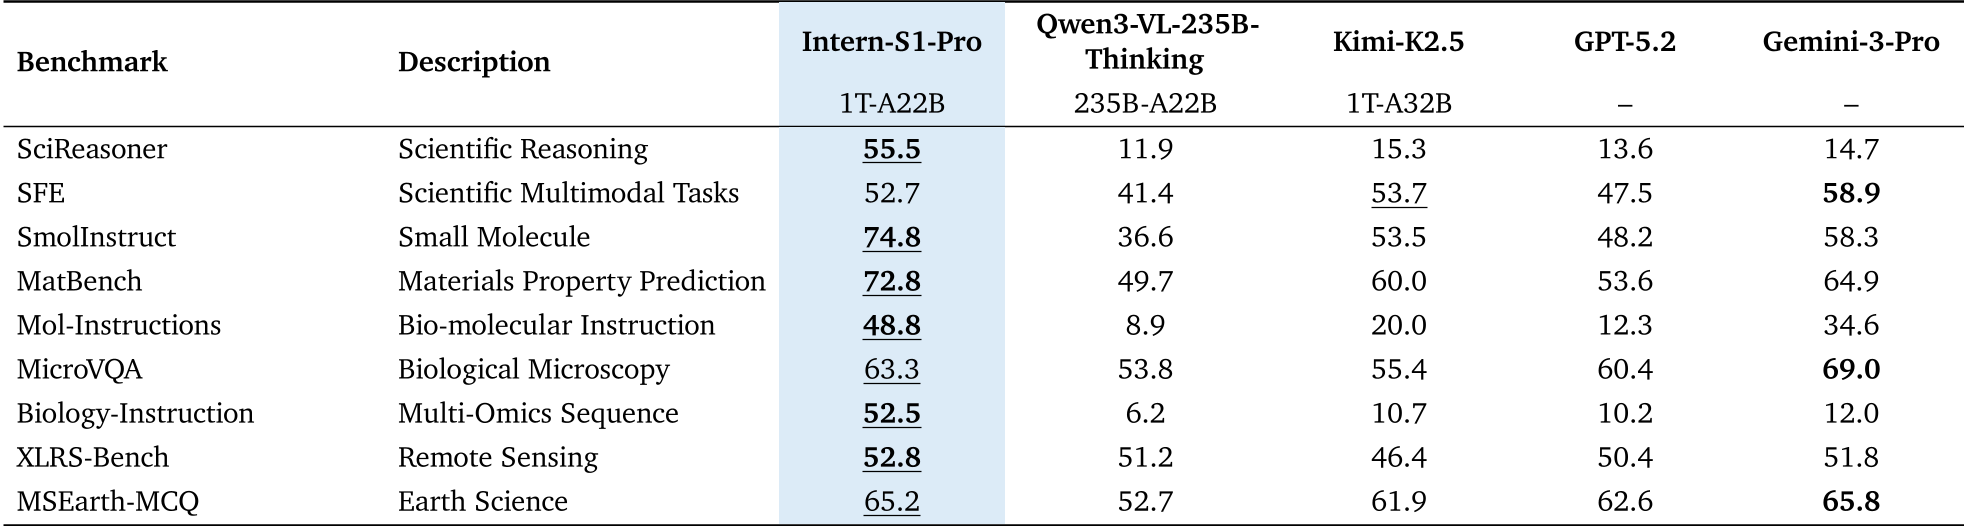 表 1:顶级模型在科学基准上的性能对比
更令人振奋的是“生物领域案例研究”:在完全相同的生物数据集上训练,Intern-S1-Pro 的表现由于其通用推理能力的增强,竟然远超专门设计的生物专家模型。这有力地反驳了“小而精”必定优于“大而全”的传统认知。
6. 深度透视:通向科学助手 (Agent) 之路
Intern-S1-Pro 不只是一个问答机器。它集成了先进的 Agent 能力,在 GAIA (77.4) 和 ScreenSpot V2 (93.6) 等基准上表现卓越。通过与 XTuner 和 LMDeploy 的深度联合优化,即使在分布式 Reinforce 强化学习阶段,由于解决了 FP8 精度下的训练/推理不一致问题,模型依然展现出惊人的收敛稳定性。
总结与展望
Intern-S1-Pro 代表了 AI4S 的新高度:它不再满足于仅仅做一个“懂点科学”的聊天机器人,而是通过 Scale + Specialized Data 的架构闭环,真正成为了能够处理复杂实验流、理解物理连续性、并拥有深厚领域专业知识的“科学通才”。未来,此类模型将极大缩短从实验室假设到科研发现的时间跨度。